

Introduktion
Det visade sig att jag på min nuvarande arbetsplats behövde bekanta mig med denna teknologi. Jag börjar med en liten bakgrund. Vid vårt senaste möte meddelade vårt team att vi behövde skapa en integration med ett välkänt system. Med integration menas att detta välkända system kommer att skicka förfrågningar via HTTP till en specifik endpoint, och vi, som kanske förvånande är, skickar tillbaka svar i form av SOAP-meddelanden. Det verkar ganska enkelt och trivialt. Därför behöver vi…
Uppgift
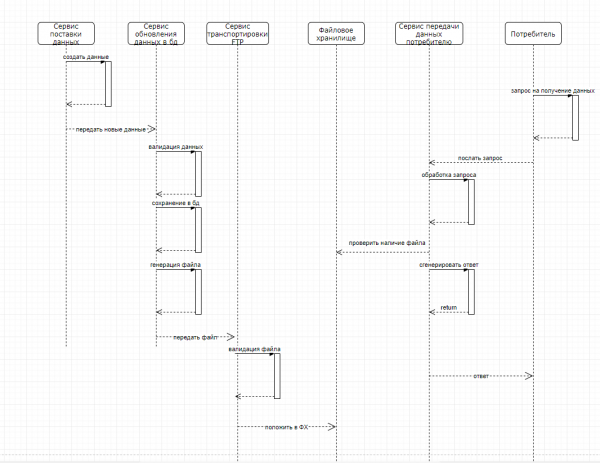
Skapa 3 tjänster. Den första är en databasuppdateringstjänst. Denna tjänst, vid mottagande av nya data från det externa systemet, uppdaterar informationen i databasen och genererar en fil i CSV-format för att överföra den till nästa system. Endpointen för den andra tjänsten - Transporttjänsten via FTP - anropas, som tar emot den överförda filen, validerar den och lägger den i filarkivet via FTP. Den tredje tjänsten - Tjänsten för dataleverans till konsumenten - arbetar asynkront med de två första. Den tar emot en förfrågan från det externa systemet om att få den fil som nämndes ovan, tar den färdiga svarfilen, modifierar den (uppdaterar fälten id, description, linkToFile) och skickar svaret som ett SOAP-meddelande. Så, i stort sett ser situationen ut så här: De två första tjänsterna börjar arbeta endast när data för uppdatering har kommit. Den tredje tjänsten arbetar kontinuerligt eftersom det finns många informationskonsumenter, omkring 1000 förfrågningar om data per minut. Tjänsterna är tillgängliga hela tiden och deras instanser finns i olika miljöer, såsom test, demo, preprod och prod. Nedan presenteras en översikt över hur dessa tjänster fungerar. Jag bör omedelbart påpeka att vissa detaljer har förenklats för att undvika onödig komplexitet.
Teknisk fördjupning
När vi planerade lösningen på uppgiften bestämde vi oss först för att utveckla applikationer i Java med hjälp av Spring-ramverket, en Nginx-lastbalanserare, en Postgres-databas och andra tekniska och mindre tekniska komponenter. Eftersom tiden för att utveckla den tekniska lösningen tillät oss att överväga andra angreppssätt, föll blicken på den trendiga teknologin Apache NIFI, som är populär inom vissa kretsar. Jag vill genast nämna att denna teknologi gjorde att vi upptäckte dessa tre tjänster. I den här artikeln kommer jag att beskriva utvecklingen av en filtransporttjänst och en dataleveranstjänst till konsumenten; om artikeln uppskattas kommer jag även att skriva om tjänsten för att uppdatera data i databasen.
Vad är det?
NIFI är en distribuerad arkitektur för snabb parallel loading och bearbetning av data, med ett stort antal plugins för källor och transformationer, versionhantering av konfigurationer och mycket mer. En trevlig bonus är att den är mycket enkel att använda. Triviala processer som getFile, sendHttpRequest och andra kan visualiseras som rutor. Varje ruta representerar en viss process, vars interaktion kan ses i bilden nedan. Mer detaljerad dokumentation om hur man konfigurerar processerna är skriven , för dem som talar ryska — . I dokumentationen beskrivs det utmärkt hur man packar upp och startar NIFI, samt hur man skapar processer, som också är rutorna.
Idén att skriva artikeln föddes efter långvariga sökningar och strukturerande av den erhållna informationen till något begripligt, samt en önskan att underlätta livet för framtida utvecklare.
Exempel
Ett exempel på hur kvadrater interagerar med varandra har granskats. Den övergripande schemat är ganska enkelt: Vi får en HTTP-förfrågan (teoretiskt med en fil i förfrågan. För att demonstrera NIFIs möjligheter startar förfrågan i detta exempel en process för att hämta en fil från den lokala filhanteraren), därefter skickar vi tillbaka ett svar om att förfrågan har mottagits, samtidigt som processen för att hämta filen från filhanteraren startar och därefter flyttas den via FTP. Det är värt att påpeka att processerna interagerar med varandra genom så kallade flowFiles. Detta är en grundläggande enhet i NIFI, som lagrar attribut och innehåll. Innehållet är de data som representeras av flödesfilen. Med andra ord, om du har fått en fil från en kvadrat och överför den till en annan, kommer innehållet att vara din fil.
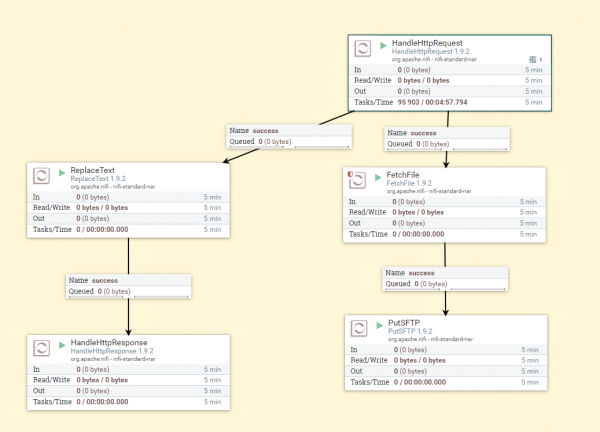
Som ni kan se av denna bild illustreras den allmänna processen. HandleHttpRequest tar emot förfrågningar, ReplaceText genererar svarets kropp, HandleHttpResponse returnerar svaret. FetchFile hämtar en fil från filsystemet och överför den till kvadraten PutSftp, som placerar filen på FTP, på den angivna adressen. Låt oss nu titta närmare på denna process.
I detta fall är request början på allt. Låt oss se på dess konfigurationsparametrar.
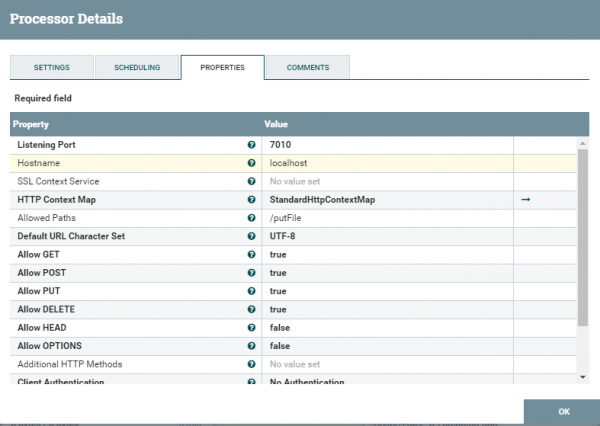
Här är allt ganska trivialt, förutom StandartHttpContextMap - detta är en typ av tjänst som möjliggör att skicka och ta emot förfrågningar. Mer detaljerat och till och med med exempel kan man se -
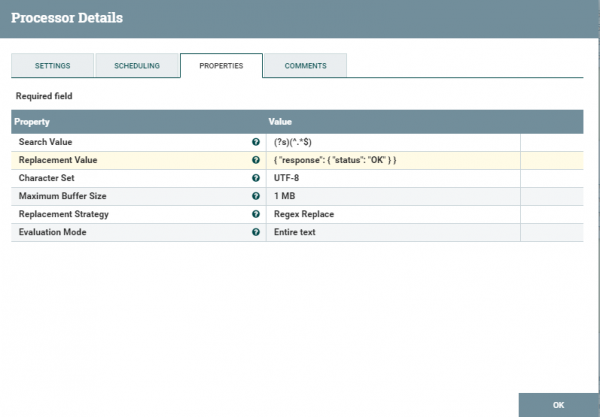
Därefter kommer vi att titta på konfigurationsparametrarna för ReplaceText-kvadraten. Här är det viktigt att notera ReplacementValue - det som kommer att återvända till användaren som ett svar. I inställningarna kan vi justera loggnivån, loggar kan ses {vart vi packade upp nifi}/nifi-1.9.2/logs, där finns också parametrarna failure/success - baserat på dessa parametrar kan vi justera processen som helhet. Det vill säga, vid framgångsrik behandling av texten - kommer processen för att skicka svar till användaren att kallas, annars loggar vi helt enkelt den misslyckade processen.
I egenskaperna för HandleHttpResponse finns det inte mycket intressant förutom statusen vid framgångsrik skapande av ett svar.
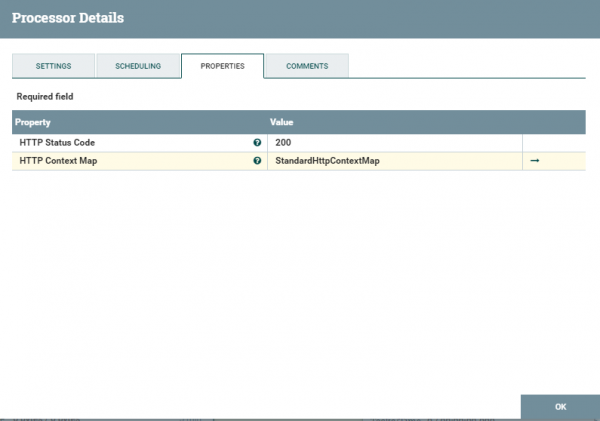
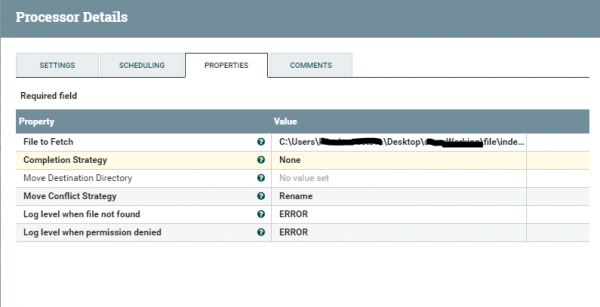
Vi har diskuterat förfrågan och svaret - låt oss gå vidare till att hämta filen och placera den på FTP-servern. FetchFile hämtar filen enligt den angivna sökvägen i inställningarna och överför den till nästa process.
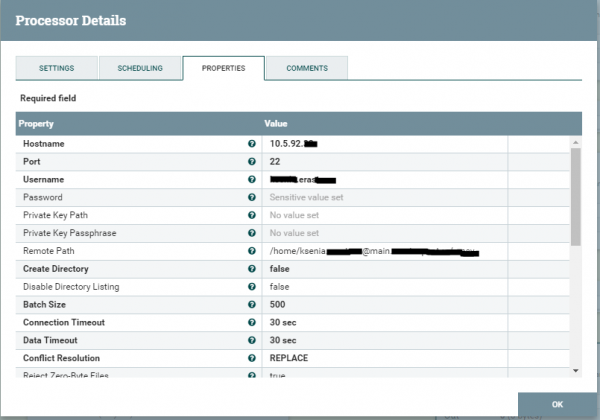
Och sedan placeras filen i fillagret av rutan PutSftp. Konfigurationsparametrarna kan vi se nedan.
Det är värt att notera att varje ruta är en separat process som måste startas. Vi har tittat på det enklaste exemplet som inte kräver någon avancerad anpassning. Låt oss nu se en något mer komplex process där vi skriver lite på Groovy.
Ett mer komplext exempel
Tjänsten för att överföra data till konsumenten blev något mer komplicerad tack vare processen att modifera SOAP-meddelandet. Den övergripande processen visas i bilden nedan.
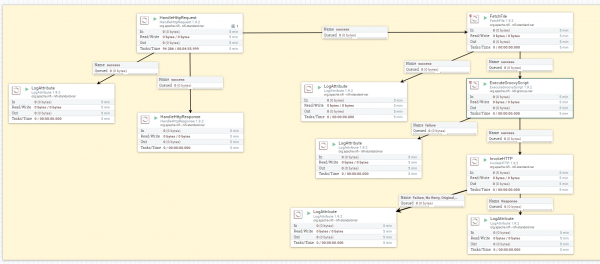
Här är idén inte särskilt komplicerad heller: vi fick en förfrågan från konsumenten om att de behövde data, vi skickade tillbaka ett svar om att vi mottagit meddelandet, startade processen för att hämta svaret, redigerade det med viss logik och skickade sedan filen till konsumenten i form av ett SOAP-meddelande på servern.
Jag tycker inte att vi behöver beskriva de rutor vi sett ovan igen – vi går direkt till de nya. Om du behöver redigera en fil och vanliga rutor som ReplaceText inte passar, måste du skriva ditt eget skript. Detta kan göras med rutan ExecuteGroovyScript. Inställningarna för den presenteras nedan.
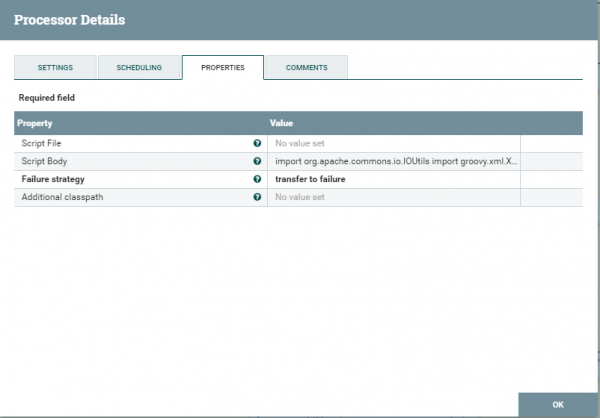
Det finns två alternativ för att ladda upp skriptet i denna ruta. Det första är att ladda upp en fil med skriptet. Det andra är att infoga skriptet i scriptBody. Såvitt jag vet stöder rutan executeScript flera programmeringsspråk — ett av dem är groovy. Jag måste tyvärr göra java-utvecklare besvikna — man kan inte skriva skript i sådana rutor med java. För den som verkligen vill — behöver man skapa sin egen anpassade ruta och lägga till den i NIFI-systemet. Hela denna operation åtföljs av ganska långvariga besvär, vilket vi inte kommer att ta upp i den här artikeln. Jag valde språket groovy. Nedan finns en testskript som helt enkelt uppdaterar id:t i SOAP-meddelandet inkrementellt. Det är viktigt att notera. Du tar filen från flowFile och uppdaterar den, glöm inte att lägga tillbaka den uppdaterade filen. Det är också värt att notera att inte alla bibliotek är anslutna. Det kan hända att du ändå måste importera ett av biblioteken. En nackdel är också att det är ganska svårt att felsöka skriptet i denna ruta. Det finns ett sätt att ansluta till JVM NIFI och börja felsökningsprocessen. Personligen har jag kört en lokal applikation och imiterat att jag får filen från sessionen. Jag har också gjort felsökning lokalt. Fel som dyker upp vid laddning av skriptet är ganska lätta att googla och skrivs av NIFI i loggen.
import org.apache.commons.io.IOUtils
import groovy.xml.XmlUtil
import java.nio.charset.*
import groovy.xml.StreamingMarkupBuilder

def flowFile = session.get()
if (!flowFile) return
try {
    flowFile = session.write(flowFile, { inputStream, outputStream ->
        String result = IOUtils.toString(inputStream, "UTF-8");
        def recordIn = new XmlSlurper().parseText(result)
        def element = recordIn.depthFirst().find {
            it.name() == 'id'
        }

        def newId = Integer.parseInt(element.toString()) + 1
        def recordOut = new XmlSlurper().parseText(result)
        recordOut.Body.ClientMessage.RequestMessage.RequestContent.content.MessagePrimaryContent.ResponseBody.id = newId

        def res = new StreamingMarkupBuilder().bind { mkp.yield recordOut }.toString()
        outputStream.write(res.getBytes(StandardCharsets.UTF_8))
} as StreamCallback)
     session.transfer(flowFile, REL_SUCCESS)
}
catch(Exception e) {
    log.error("Error during processing of validate.groovy", e)
    session.transfer(flowFile, REL_FAILURE)
}
Egentligen slutar anpassningen av rutan här. Den uppdaterade filen överförs till en ruta som ansvarar för att skicka filen till servern. Nedan finns inställningarna för denna ruta.
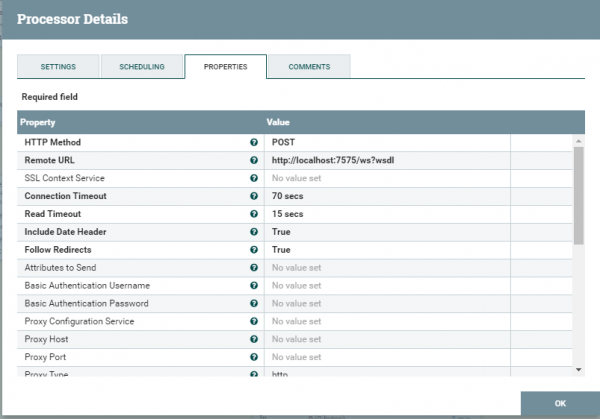
Vi beskriver metoden genom vilken SOAP-meddelandet kommer att skickas. Vi anger vart det ska skickas. Därefter behöver vi ange att det verkligen är SOAP.
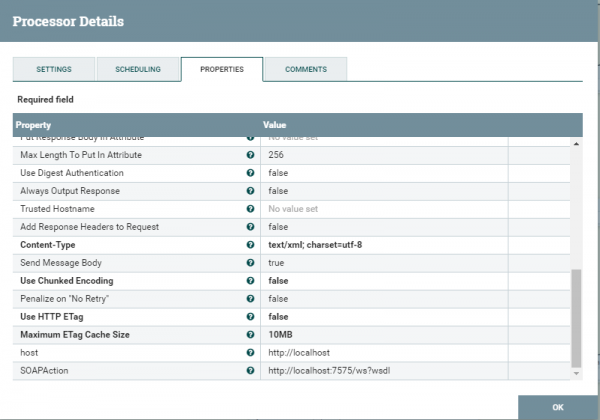
Vi lägger till flera egenskaper såsom värd och åtgärd (soapAction). Vi sparar och kontrollerar. Mer detaljerat om hur man skickar SOAP-förfrågningar kan man se
Vi har undersökt flera användningsalternativ för NIFI-processer. Hur de interagerar och vilken verklig nytta de ger. De exempel som diskuterats är testexempel och skiljer sig något från det som faktiskt finns i produktion. Jag hoppas att denna artikel kommer vara lite användbar för utvecklare. Tack för uppmärksamheten. Om det finns några frågor – skriv. Jag ska försöka svara.
Källa: habr.com
