

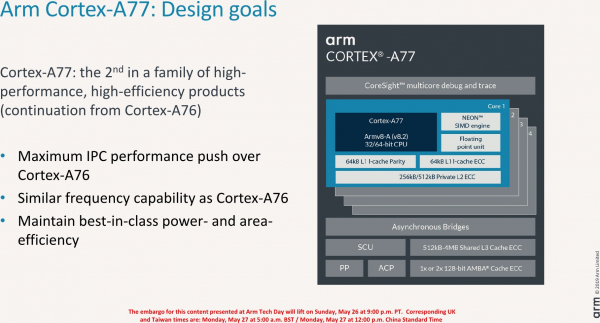
ARM har presenterat sin senaste processordesign – Cortex-A77. Precis som förra årets Cortex-A76 är denna kärna avsedd för högpresterande uppgifter i smartphones och en mängd olika enheter. Utvecklaren har fokuserat på att öka antalet utförda kommandon per cykel (IPC). Klockfrekvenser och energiförbrukning har förblivit på ungefär samma nivå som Cortex-A76.
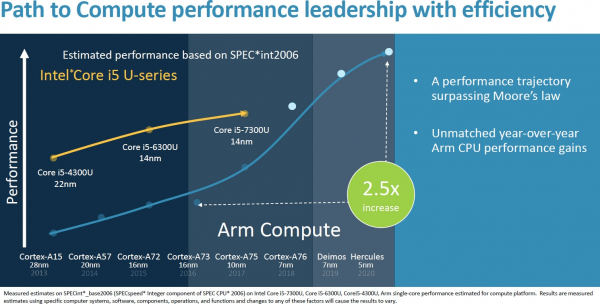
För närvarande är ARM inriktad på att snabbt öka prestandan för sina kärnor. Enligt deras planer, från Cortex-A73 2016 till designen Hercules 2020, avser företaget att öka CPU-kraften med 2,5 gånger. Övergångarna från 16 nm till 10 nm och sedan till 7 nm har redan gjort det möjligt att höja klockfrekvensen, och i kombination med arkitekturen Cortex-A75 och senare Cortex-A76 beräknar ARM att en 1,8-faldig prestandaökning har uppnåtts hittills. Nu kommer kärnan Cortex-A77 att kunna öka prestandan med ytterligare 20 % vid samma klockfrekvens tack vare ökningen av IPC. Det innebär att den 2,5-faldiga ökningen 2020 blir fullt realistisk.
Trots en 20 % ökning av IPC har ARM beräknat att energiförbrukningen för A77 inte har ökat. Kompromissen här är att kiselarean för A77 är cirka 17 % större än A76 vid samma tekniska normer. Som ett resultat kommer kostnaden för enskilda kärnor att öka något. Jämfört med ARM:s prestationer, ska det nämnas att AMD i Zen 2 uppnått en IPC-ökning på 15 % jämfört med Zen+, medan IPC-värdet hos Intels kärnor har förblivit ungefär detsamma under många år.
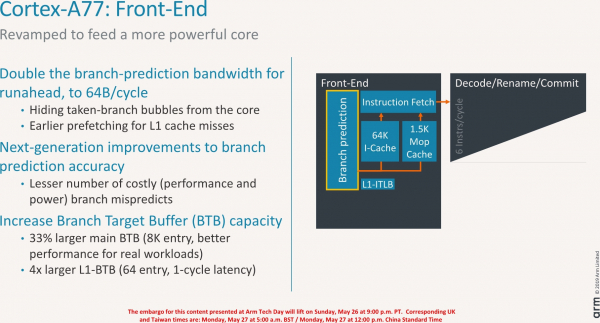
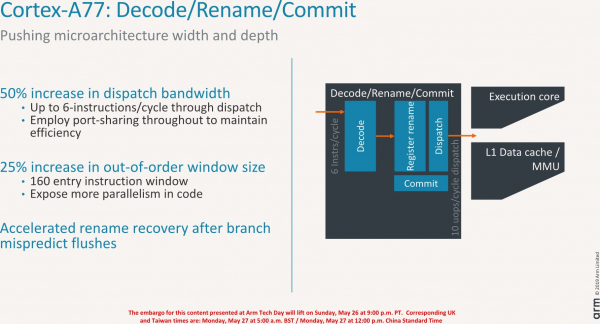
Fönstret för utförande med omordning av kommandon (out-of-order window size) har ökat med 25 %, till 160 enheter, vilket gör det möjligt för kärnan att öka beräkningsparallellismen. Även i Cortex-A76 fanns en stor branch target buffer, och i Cortex-A77 har den ökat med ytterligare 33 %, till 8 KB, vilket möjliggör för branch-prediction-enheten att effektivt hantera det ökade antalet parallella instruktioner.
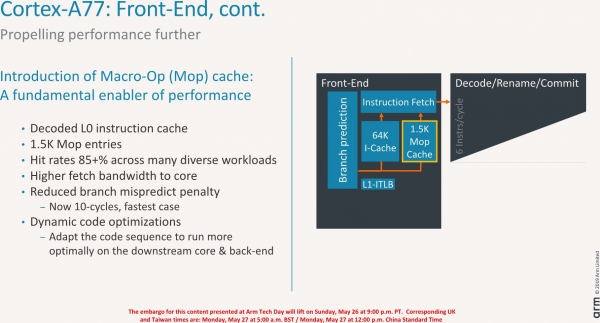
En ännu mer intressant nyhet är den helt nya 1,5 KB-cache som lagrar makrooperationer (MOP) som returneras från avkodningsmodulen. ARM-arkitekturen avkodar instruktioner från applikationen i mindre makrooperationer och bryter sedan ner dem i mikrooperationer som överförs till exekveringskärnan. MOP-cachen används för att minska påverkan av missade grenar och återställningar, eftersom makrooperationerna nu lagras i en separat enhet och inte kräver omavkodning - vilket ökar den totala kapaciteten hos kärnan. I vissa belastningar är den nya enheten ett extremt användbart tillägg till den standardmässiga instruktioncachen.
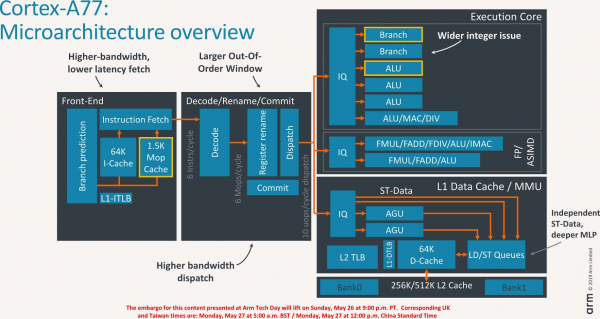
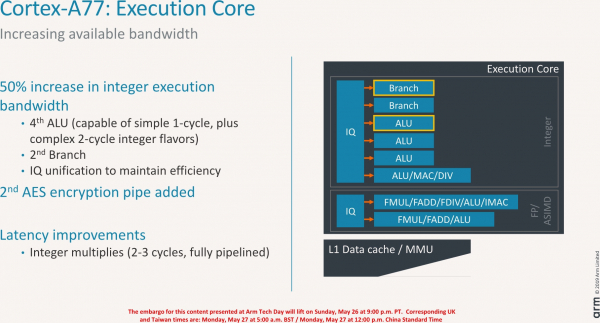
I exekveringskärnan har en fjärde ALU-enhet och en andra grenhanterare lagts till. Den fjärde ALU ökar den totala kapaciteten hos processorn med 1,5 gånger genom att möjliggöra exekvering av enkla instruktioner (såsom ADD och SUB) och dubbla heltalsoperationer som multiplikation. De två andra ALU-enheterna kan endast hantera grundläggande enkla instruktioner, medan den senaste enheten belastas med mer komplexa matematiska operationer som division, multiplicering med ackumulering osv. Den andra grenenheten inom exekveringskärnan dubblar antalet samtidiga grenövergångar som kärnan kan hantera, vilket är användbart i fall där två av de sex skickade kommandona relaterar till grenövergångar. Interna tester på ARM har visat på prestandaförbättringar från användningen av denna andra grenövergångsblock.
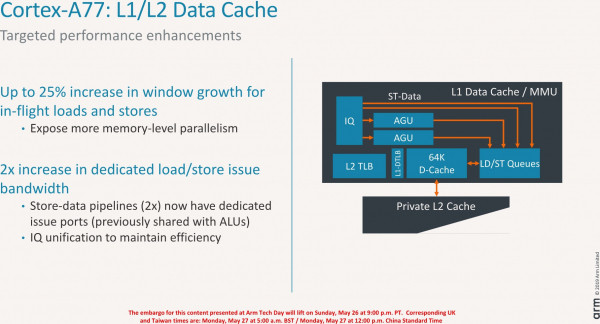
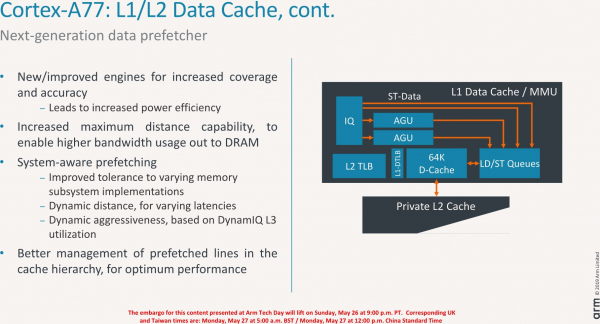
Bland andra förändringar i kärnan finns tillägget av en andra AES-krypteringspipeline, ökad minneskapacitet, en förbättrad datapre-fetching-mekanism av nästa generation som gör det möjligt att öka energieffektiviteten och samtidigt öka systemets DRAM-kapacitet, optimisering av cacheprestanda osv.
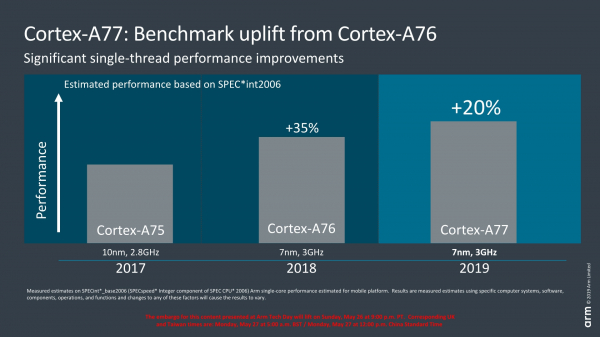
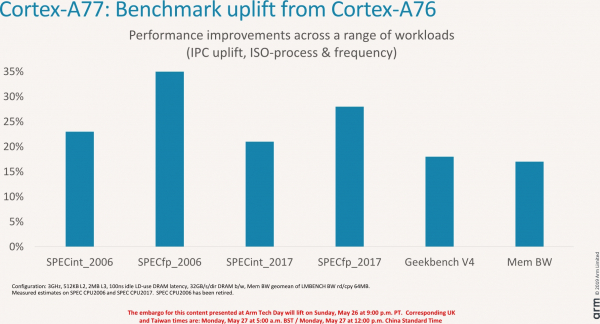
Den största ökningen observeras i Cortex-A77 vid heltalsoperationer och beräkningar med flyttal. Detta bekräftas av interna tester från ARM i SPEC, som visade en prestandaökning på 20 % respektive 35 % i heltalsoperationer och flyttalsberäkningar. Förbättringar av minnesbandbredd ligger någonstans i intervallet 15–20 %. Sammanfattningsvis ger optimeringar och förändringar i A77 i genomsnitt en 20-procentig ökning av prestandan jämfört med föregående generation. Tack vare nyare tillverkningstekniker som 7 nm ULV kan vi uppnå ytterligare fördelar i de slutliga chipen.
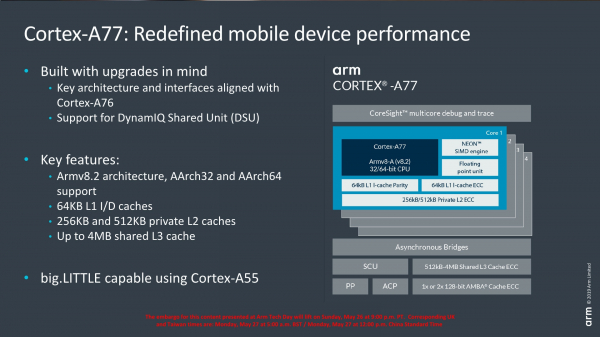
ARM har utvecklat Cortex-A77 för att fungera i en 4+4 big.LITTLE-konfiguration (4 kraftfulla kärnor och 4 enkla energieffektiva). Men med tanke på den ökade ytan av den nya arkitekturen kan många tillverkare av ekonomiska skäl presentera konfigurationer såsom 1+3+4 eller 2+2+4, vilket redan tillämpas där endast en eller två kärnor kommer att vara fullständiga, outkappade A77.
Källa: 3dnews.ru
