

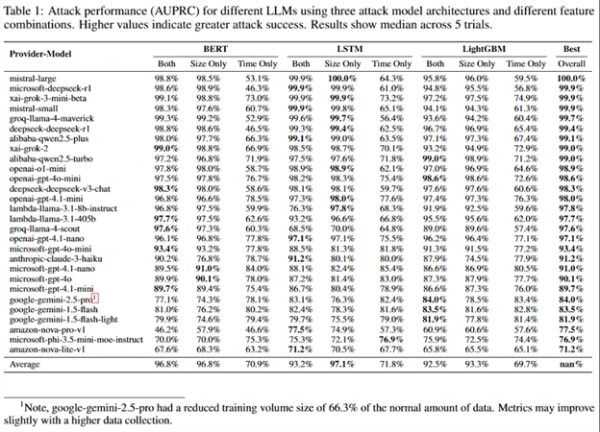
Säkerhetsforskare från Microsoft har utvecklat en teknik för sidokanalsattacker, kallad Whisper Leak, som möjliggör, baserat på passiv analys av krypterad trafik som överförs via TLS-anslutningar, klassificering av ämnen för förfrågningar till tjänster baserade på stora språkmodeller. Informationen om storleken på nätverkspaket och fördröjningar mellan deras överföring visade sig vara tillräcklig för att bestämma ämnena för förfrågningar till AI-chatbotar med en noggrannhet på över 98%. I praktiken kan den föreslagna metoden användas för att identifiera specifika ämnen i användartrafik, till exempel försök att få information om olagliga aktiviteter, utan att dekryptera innehållet.
Verktygen för att extrahera data från trafikdumpningar, träna modellen och testa metodens effektivitet har publicerats på GitHub. Möjligheten att genomföra attacken har demonstrerats för 28 populära stora språkmodeller från de största tillverkarna. Till exempel var noggrannheten för att identifiera förfrågningar om "pengatvätt" för många AI-tjänster 100%, när det i den analyserade trafiken fanns 1 önskad förfrågan och 10 000 förfrågningar som inte var relaterade till det aktuella ämnet.
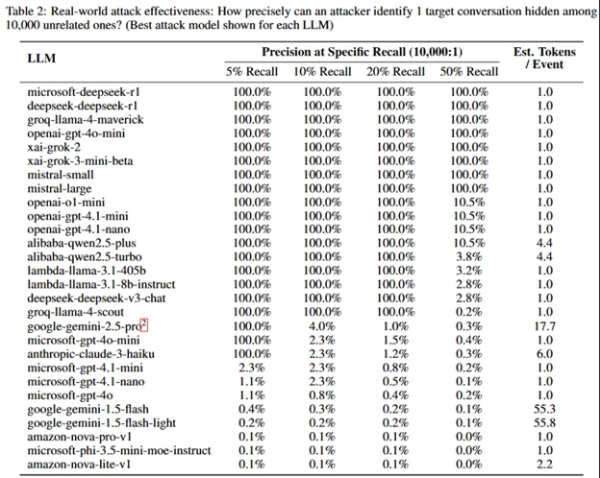
Anledningen till informationsläckaget är att modeller genererar svar på förfrågningar steg för steg, en token i taget, där varje steg använder den tidigare token som kontext för att bestämma det mest sannolika nästa ordet eller frasen. Följaktligen skickas ett separat nätverkspaket för varje token och fördröjningen mellan paketen motsvarar fördröjningen mellan modellens bestämning av nästa token.
I TLS, om ingen datakomprimering används, är utbytet av chiffertext lika med storleken på den okrypterade texten plus en konstant. Genom att skapa en modell som kopplar önskade uppsättningar av tokens med paketstorlekar och fördröjningar mellan deras överföring kan man ganska exakt bestämma närvaron av önskade ämnen i trafiken. Under studien har tre varianter av sådana maskininlärningsmodeller utvecklats, baserade på neurala nätverksarkitekturer som LightGBM, Bi-LSTM och BERT. För varje modell har experiment genomförts för att bestämma det önskade ämnet vid analys av enbart paketstorlekar, enbart fördröjningar mellan paketen och båda kriterierna.
För att minska effektiviteten av passiv analys av förfrågningarnas ämne föreslås utvecklare av AI-tjänster att bifoga slumpmässigt tilläggsfyllnad, buffra tokenöverföringen eller utföra substitution av falska paket.
Källa: opennet.ru
