

Företaget Google har meddelat att de genomför ett experiment för att integrera en stor maskininlärningsspråkmodell i Chrome. För att få åtkomst till modellen från webbapplikationer och webbläsartillägg har ett API Prompt föreslagits, vilket möjliggör att skicka förfrågningar på naturligt språk, liknande hur chattbottar fungerar. Det förväntas att den inbyggda stora språkmodellen i webbläsaren kommer att förenkla genomförandet av AI-uppgifter i webbapplikationer och att man slipper tänka på installation och hantering av språkmodeller.
I det pågående experimentet används modellen Gemini Nano, den mest kompakta i Gemini-familjen. Det finns också möjlighet att installera expertmodeller som utökar den grundläggande modellen med ytterligare kunskaper som kan behövas för att lösa specifika uppgifter, samt för att implementera färdigheter som maskinöversättning och sammanfattning. Modellerna körs lokalt på användarens system utan att behöva kontakta externa tjänster.
Den runtime som används för att köra modellen aktiverar automatiskt de tillgängliga GPU:erna och NPU:erna i systemet för att snabba upp arbetet med modellen eller växlar till CPU-användning. Fördelarna med att köra modellen på användarens system inkluderar bevarande av konfidentialitet för de data som behandlas, möjlighet att fortsätta arbeta offline när det inte finns någon nätverksanslutning eller vid problem med nätverkskvaliteten, minskad fördröjning vid sändning av förfrågningar, samt uteslutning av beroendemiljöer från externa tjänster.
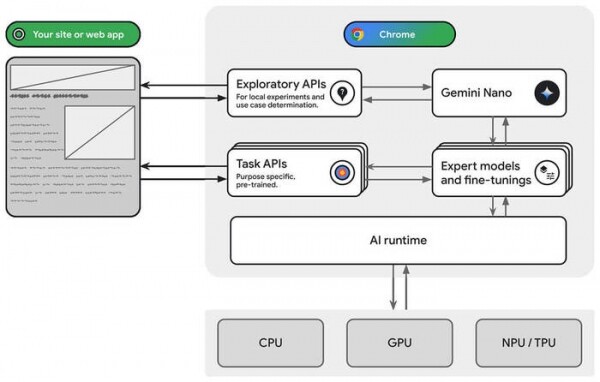
API Prompt som utvecklas för interaktionen med modellen gör det möjligt att inte bara utföra de enklaste enkla förfrågningarna på naturligt språk, utan också att organisera engagemanget för modellen i bearbetning och klassificering av data med hänsyn till kontexten, ta hänsyn till tidigare skickade förfrågningar och data i sessionen, samt använda modellen för att välja optimala alternativ (till exempel kan man be modellen välja en ikon från en lista med emoji för en specifik kommentar på en webbplats). Ytterligare planeras det att utveckla API:t för användning inom innehållsskapande och för att lösa uppgifter som omskrivning, korrektur och grammatikkorrigering.
I allmänhet utvecklas två typer av API:er för att interagera med den inbyggda AI-modellen – Task och Exploratory. Den första ger tillgång till funktioner för att lösa specifika uppgifter, såsom att översätta text från ett språk till ett annat (API Translation) eller sammanfatta kärnan i texten (API Summarization). Den andra typen syftar till att skapa och verifiera experimentella prototyper vid utvecklingen av nya Task API:er. Arbetet med API LoRA (Low-Rank Adaptation) pågår också för att anpassa vikterna i den grundläggande modellen för att förbättra effektiviteten vid lösningen av specifika uppgifter.
Tillgång till att delta i experimentet ges efter att en ansökan har fyllts i. API:et är under aktiv utveckling och kommer att utvidgas och förändras baserat på användarnas feedback och preferenser innan den slutgiltiga versionen antas. I framtiden planeras mer tillgänglig testning med hjälp av Origin Trials-läget, som ger möjlighet att arbeta med experimentella API:er från applikationer som laddats upp från localhost eller 127.0.0.1, eller efter registrering och mottagande av en speciell token som är giltig under en begränsad tid för en specifik webbplats. Parallellt med producenter av andra webbläsare pågår arbete för att standardisera de utvecklade API:erna.
Källa: opennet.ru
