

Intel Foundry har släppt ett reklamblad, som noggrant beskriver företagets avancerade lösningar för utveckling och implementering av hårdvara för AI-appar och högpresterande beräkningar. Intel har också demonstrerat en "testprototyp av AI-chippet", som visar företagets nuvarande möjligheter inom paketering.
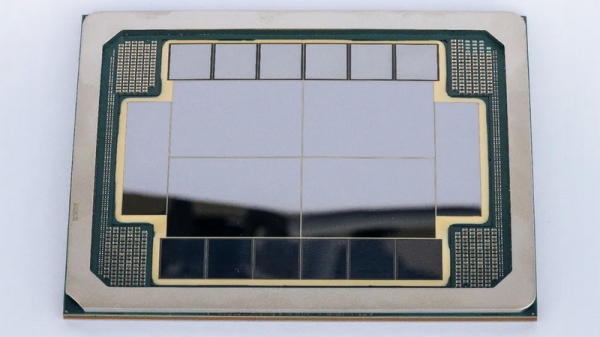
Intel har visat upp ett system i paket (SiP) som är åtta fotolitografimönster stort, vilket inkluderar fyra logiska enheter, 12 staplar av HBM4-klass och två in-/utgångsenheter. Till skillnad från den storskaliga konceptutvecklingen med 16 logiska enheter och 24 staplar HBM5, som företaget presenterade förra månaden, är detta system faktiskt produktionsdugligt redan idag.
Det är viktigt att notera att Intel Foundry har visat inte en fungerande AI-accelerator utan en "testprototyp av AI-chippet", som demonstrerar hur man faktiskt kan skapa (eller snarare montera) framtida processorer för AI och högpresterande beräkningar. Intel visar hela konstruktionsmetoden, som kombinerar stora beräkningsblock, staplar av höghastighetsminne, supersnabba interchipanslutningar och nya strömförsörjningsteknologier i ett och samma tekniska paket. Detta paket skiljer sig avsevärt från det som idag erbjuds av företag som TSMC. Intel vill visa att framtida generationers processorer för högpresterande AI kan ha en flerkapslad konstruktion, och Intel Foundry är redan kapabel att producera dem.
Den plattform som demonstrerats bygger på fyra stora logiska block, som antas vara baserade på Intel 18A teknologiprocess (därmed med RibbonFET-transistorer med cirkulärt grind och PowerVia-strömförsörjningssystem på baksidan), som omges av HBM4-minnesstackar och in- och utgångsblock. Alla nyckelkomponenter är antagligen kopplade med EMIB-T 2.5D-broar, som är inbyggda direkt på chassits substrat. Intel använder EMIB-T interchipgränssnittsteknik, som lägger till genomgående kiselövergångshål inom broarna, så att ström och signaler kan passera både vertikalt och horisontellt, vilket maximerar densiteten av interkonnectioner och strömförsörjning. Plattformen är utformad för UCIe interchipgränssnitt som arbetar vid 32 GT/s och högre, som tydligen också används för anslutning av C-HBM4E-staplar.
Testprototypen av chipet demonstrerar också Intels övergång till vertikal montering. Företagets teknologikarta inkluderar Intel 18A-PT, som är utvecklad specifikt för chiplets, vilket innebär att andra logiska kristaller eller minnen placeras ovanpå. Därför måste chiplets ha strömförsörjning från baksidan och även använda genomgående och hybridinterkonnectioner. För "testprototypen av AI-processorn" placeras de grundläggande 18A-PT-kristallerna under beräkningskristallerna 18A/18A-P och fungerar antingen som stora cache-minneskristaller eller utför andra stödjande funktioner. För vertikal anslutning av chiplets använder Intel Foveros paketningsteknikfamilj — Foveros 2.5D, Foveros-R och Foveros Direct 3D. Dessa tillåter en finpitch koppling mellan aktiva kristaller för att säkerställa maximal bandbredd och energieffektivitet för de översta kristallerna. Tillsammans med EMIB-broar tillåter dessa metoder Intel att skapa en hybrid lateralt-vertikal montering, som företaget positionerar som ett alternativ till stora kiselinterposers med högre plattanvändningsgrad och utbyte av dugliga produkter.
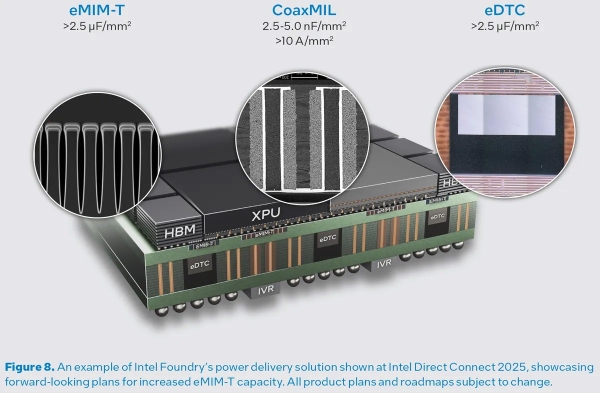
För flerchipacceleratorer för AI och högpresterande beräkningar är den främsta konstruktionsbegränsningen strömförsörjningen. I detta syfte måste Intel-plattformen kombinera alla senaste innovationer från Intel inom energieffektivisering, inklusive PowerVia, inbyggda kondensatorer Omni MIM, avkoppling på bro-nivå i EMIB-T, kondensatorer eDTC och eMIM-T på huvudchipet samt inbyggda induktorer CoaxMIL för att stödja delvis integrerade spänningsregulatorer (IVR), placerade under varje stapel och under själva höljet (till skillnad från IVR i fallet med CoWoS-L från TSMC, som är en del av interposer). Detta flerskiktade nätverk är avsett att stödja stabil ström vid belastningar för generativ AI utan att sänka spänningsnivån.
Genom sin demonstration försöker Intel tydligt attrahera kunder. För närvarande är det oklart om den nästa generationens AI-accelerator med kodnamnet Jaguar Shores, vars lansering är planerad till 2027, kommer att använda den arkitektur som Intel visar idag.
Källa:
Källa: 3dnews.ru
