

Första delen:
Vad? En videokodex är en del av programvaran/hårdvaran som komprimerar och/eller avkodar digital video.
Varför? Trots vissa begränsningar av såväl bandbredd som
lagringsutrymme, kräver marknaden alltmer högkvalitativ video. Kommer du ihåg hur vi i det förra inlägget beräknade det nödvändiga minimumet för 30 bilder per sekund, 24 bitar per pixel, med upplösningen 480×240? Vi fick 82,944 Mbit/s utan komprimering. Komprimering är fortfarande det enda sättet att överhuvudtaget överföra HD/FullHD/4K till TV-skärmar och internet. Hur uppnås detta? Låt oss nu kort gå igenom de viktigaste metoderna.
Översättningen gjordes med stöd av företaget EDISON Software.Vi sysslar med , samt .
Kodex vs Container
En vanlig nybörjarmisstag är att förväxla videokodexen och digital video container. En container är ett format, ett omslag som innehåller metadata för video (och kanske ljud). Den komprimerade videon kan ses som en nyttolast i containern.
Vanligtvis indikerar videofilens filändelse dess typ av container. Till exempel, filen video.mp4 är troligen en container MPEG-4 Part 14, medan en fil med namnet video.mkv troligen är en . För att vara helt säker på kodexen och containerformatet kan man använda eller .
Lite historia
Innan vi går över till Hur?, låt oss dyka lite in i historien för att förstå några äldre kodexer bättre.
Videokodex H.261 introducerades 1990 (tekniskt sett 1988) och skapades för att arbeta med en överföringshastighet på 64 Kbit/s. Den använde redan sådana idéer som färgsampling, makroblock etc. År 1995 publicerades standarden för videokodexen H.263, som utvecklades fram till 2001.
År 2003 avslutades den första versionen av H.264/AVC. Samma år släppte företaget "TrueMotion" sin gratis videokodex som komprimerade video med förlust, kallad VP3. År 2008 köpte Google detta företag och släppte VP8 samma år. I december 2012 släppte Google VP9, och den stöds av ungefär ¾ av marknaden för webbläsare (inklusive mobila enheter).
AV1 — är en ny gratis videokodare med öppen källkod som har utvecklats av Alliansen för öppna media (AOMedia), som består av välkända företag som: Google, Mozilla, Microsoft, Amazon, Netflix, AMD, ARM, NVidia, Intel och Cisco. Den första versionen av kodaren 0.1.0 publicerades den 7 april 2016.
Födelsetiden för AV1
I början av 2015 arbetade Google med VP10, Xiph (som tillhör Mozilla) arbetade med Daala, och Cisco skapade sin gratis videokodare som heter Thor.
Sedan MPEG LA meddelade först årliga begränsningar för HEVC (H.265) och avgifter, som var 8 gånger högre än för H.264, men snart ändrade de reglerna igen:
utan årlig gräns,
avgift för innehåll (0,5% av intäkten) och
avgift per enhet var ungefär 10 gånger högre än för H.264.
Alliansen för öppna media skapas av företag från olika områden: hårdvaruproducenter (Intel, AMD, ARM, Nvidia, Cisco), innehållstillverkare (Google, Netflix, Amazon), webbläsarskapare (Google, Mozilla) och andra.
Företagen hade ett gemensamt mål — en videokodare utan licensavgifter. Sedan dyker det upp AV1 med en mycket enklare patentlicens. Timothy B. Terriberry gav en enastående presentation som blev källan till den nuvarande konceptet AV1 och dess licensmodell.
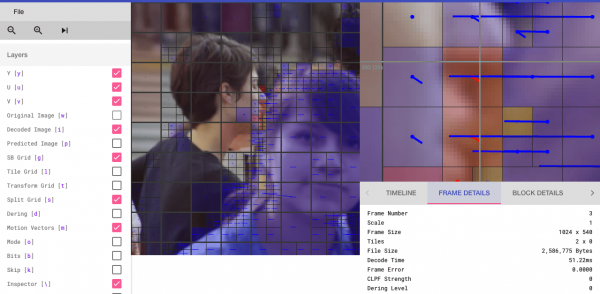
Du kommer att bli förvånad över att veta att du kan analysera AV1-kodaren via en webbläsare (de som är intresserade kan besöka).
En universell kodare
Låt oss bryta ner de grundläggande mekanismerna bakom den universella videokodaren. Många av dessa koncept är användbara och används i moderna kodare, såsom VP9, AV1 och HEVC. Jag varnar för att många av de saker som förklaras kommer att förenklas. Ibland kommer verkliga exempel att användas (som i fallet med H.264) för att demonstrera teknologier.
Steg 1 — uppdelning av bilden
Det första steget är att dela upp ramen i flera sektioner, undersektorer och så vidare.
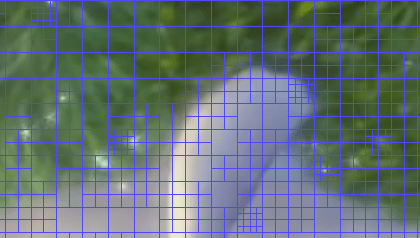
Varför? Det finns många skäl. När vi delar upp bilden kan vi bättre förutsäga rörelsevektorer genom att använda små sektioner för små rörliga delar. Medan vi för en statisk bakgrund kan nöja oss med större sektioner.
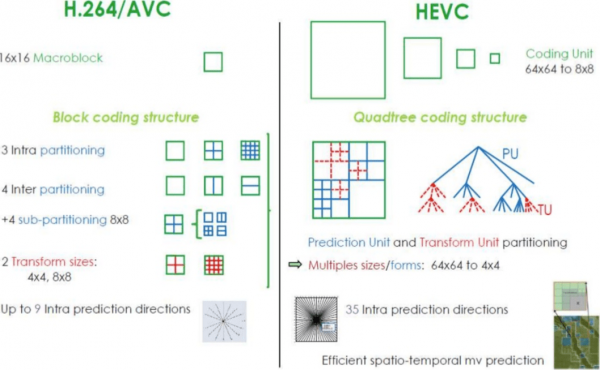
Vanligtvis organiserar codecs dessa sektioner i sektioner (eller fragment), makroblock (eller kodningsträdblock) och många underavsnitt. Den maximala storleken på dessa sektioner varierar, HEVC sätter 64×64, medan AVC använder 16×16, och underavsnitt kan delas upp till storlekar på 4×4.
Kommer du ihåg typerna av ramar från den tidigare artikeln?! Detta kan också tillämpas på block, så vi kan ha I-fragment, B-block, P-makroblock osv.
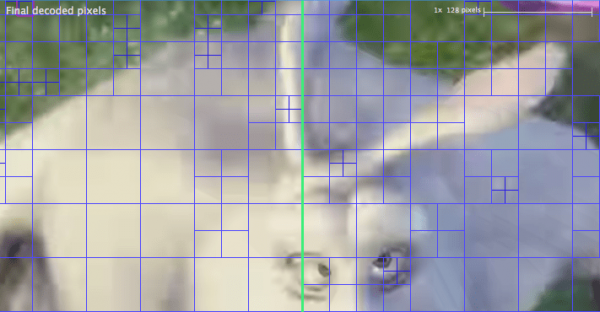
För de som vill öva – se hur bilden delas upp i sektioner och underavsnitt. För detta kan man använda den som nämndes i den tidigare artikeln. (den som är betald, men med en gratis provversion som har begränsning på de första 10 ramarna). Här analyseras sektionerna. VP9:
Steg 2 – prognostisering
Så fort vi har sektioner kan vi göra astrologiska prognoser baserade på dem. För INTER-prognostisering är det nödvändigt att överföra rörelsevektorer och rester, medan för INTRA-prognostisering överförs prognosriktning och resten.
Steg 3 – omvandling
När vi har den resterande blocket (förutsagd sektion → verklig sektion) kan vi omvandla det på ett sätt som gör att vi vet vilka pixlar som kan kasseras, samtidigt som den totala kvaliteten bevaras. Det finns vissa omvandlingar som erbjuder exakt beteende.
Även om det finns andra metoder, låt oss titta närmare på diskret cosinustransform (DCT – från discrete cosine transform). Huvudfunktionerna för DCT:
- Omvandlar block med pixlar till lika stora block med frekvenskoefficienter.
- Kompakterar kraften, vilket hjälper till att eliminera rumslig redundans.
- Säkerställer reversibilitet.
Den 2 februari 2017 publicerade Cintra R.J. och Bayer F.M. en artikel om DCT-liknande omvandling för bildkomprimering, vilket kräver endast 14 additioner.
Oroa dig inte om du inte förstod fördelarna med varje punkt. Nu kommer vi att bevisa deras verkliga värde med konkreta exempel.
Låt oss ta ett sådant block av pixlar 8×8:
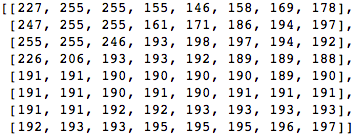
Detta block renderas till följande bild av 8 på 8 pixlar:
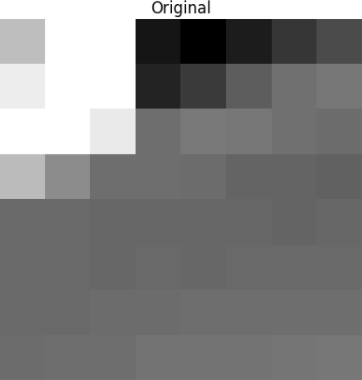
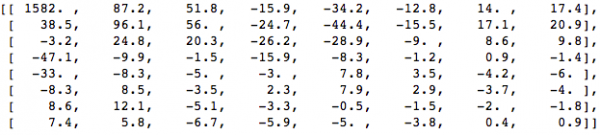
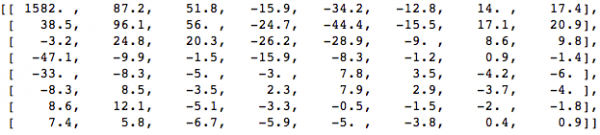
Vi tillämpar DCT på detta block av pixlar och får ett block av koefficienter med storleken 8×8:
Och om vi renderar detta block av koefficienter får vi följande bild:
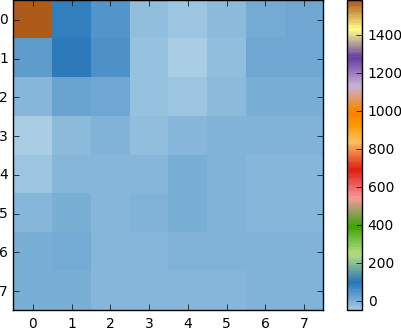
Som vi kan se, liknar detta inte det ursprungliga bilden. Det går att märka att den första koefficienten avviker kraftigt från alla andra. Denna första koefficient är känd som DC-koefficienten, som representerar alla prov i ingångsarrayen, något som liknar ett medelvärde.
Denna block av koefficienter har en intressant egenskap: den separerar högfrekventa komponenter från lågfrekventa.
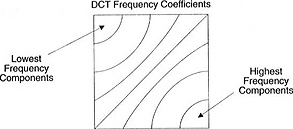
I bilden är den största delen av kraften koncentrerad på lägre frekvenser, därför, om vi omvandlar bilden till dess frekvenser och kastar bort de högre frekventa koefficienterna, kan vi minska mängden data som krävs för att beskriva bilden utan att offra för mycket bildkvalitet.
Frekvens betyder hur snabbt signalen förändras.
Låt oss försöka tillämpa kunskapen vi fått i testexemplet genom att omvandla den ursprungliga bilden till dess frekvens (koefficientblock) med hjälp av DCT, och därefter kasta bort en del av de minst viktiga koefficienterna.
Först konverterar vi den till frekvensområdet.
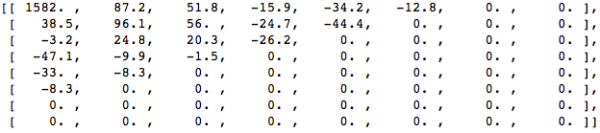
Därefter kastar vi bort en del (67%) av koefficienterna, främst den nedre högra delen.
Slutligen återskapar vi bilden från detta bortkastade koefficientblock (kom ihåg att det måste vara omvänt) och jämför med originalet.
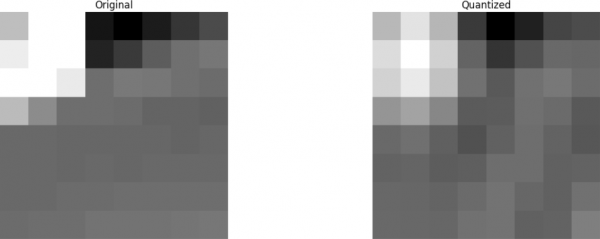
Vi ser att den liknar den ursprungliga bilden, men det finns många skillnader från originalet. Vi har kastat bort 67,1875% och ändå fått något som påminner om ursprunget. Det skulle kunna ha varit mer genomtänkt att kasta bort koefficienterna för att få en bild av ännu högre kvalitet, men det är redan nästa ämne.
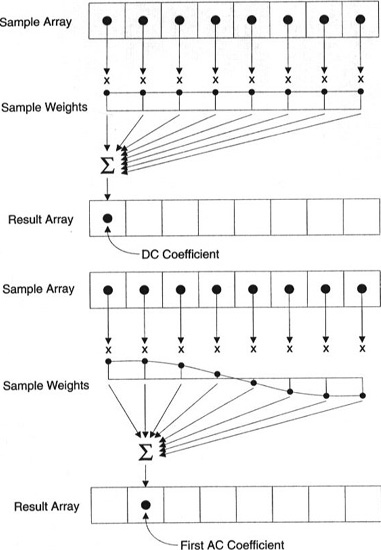
Varje koefficient bildas med hjälp av alla pixlar
Viktigt: varje koefficient avbildas inte direkt på en pixel, utan representerar en viktad summa av alla pixlar. Denna fantastiska graf visar hur den första och andra koefficienten beräknas med vikter som är unika för varje index.
Du kan också försöka visualisera DCT genom att titta på en enkel bildformation baserad på den. Till exempel, här är bokstaven A som bildas med hjälp av varje koefficientväg.
Fjärde steget är kvantisering
Efter att ha tagit bort vissa koefficienter i det föregående steget, utför vi en speciell form av kvantisering i det sista steget (omvandling). I detta skede är det acceptabelt att förlora information. Eller, enklare sagt, vi kvantiserar koefficienterna för att uppnå kompression.
Hur kan vi kvantisera en block av koefficienter? En av de enklaste metoderna är jämn kvantisering, där vi tar blocket, delar det med ett värde (med 10) och rundar det som vi fått.
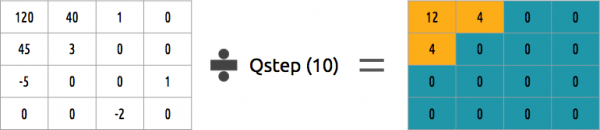
Kan vi återställa detta block av koefficienter? Ja, det kan vi, genom att multiplicera med samma värde som vi delade med.
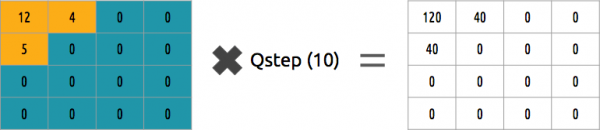
Denna metod är inte den bästa, eftersom den inte tar hänsyn till varje koefficients betydelse. Vi skulle kunna använda en kvantiseringsmatris istället för ett enda värde, och denna matris kan utnyttja egenskapen DCT, vilket kvantiserar de flesta av de nedre högra och ett fåtal av de övre vänstra.
Steg 5 - entropikodning
Efter att vi har kvantiserat data (bildblock, fragment, ramar) kan vi fortfarande komprimera dem utan förlust. Det finns många algoritmiska sätt att komprimera data. Vi kommer kort att introducera några av dem, för en djupare förståelse kan du läsa boken "Understanding Compression: Data Compression for Modern Developers".»).
Videoinkodning med VLC
Låt oss anta att vi har en ström av tecken: a, e, är lika med noll. och t. Sannolikheten (inom intervallet 0 till 1) för hur ofta varje tecken förekommer i strömmen presenteras i denna tabell.
| a | e | är lika med noll. | t | |
|---|---|---|---|---|
| Sannolikhet | 0,3 | 0,3 | 0,2 | 0,2 |
Vi kan tilldela unika binära koder (helst små) till de mest sannolika, och större koder till mindre sannolika.
| a | e | är lika med noll. | t | |
|---|---|---|---|---|
| Sannolikhet | 0,3 | 0,3 | 0,2 | 0,2 |
| Binärkod | 0 | 10 | 110 | 1110 |
Vi komprimerar strömmen, och antar att vi får slösa 8 bitar per tecken. Utan kompression skulle det krävas 24 bitar per tecken. Om varje tecken ersätts med sin kod, så ger det en besparing!
Det första steget innebär att koda tecknet e, vilket är 10, och det andra tecknet är a, vilket läggs till (inte på ett matematiskt sätt): [10] [0], och slutligen det tredje tecknet t, vilket gör vår slutgiltiga komprimerade bitström lika [10] [0] [1110] eller 1001110, vilket kräver bara 7 bitar (3,4 gånger mindre utrymme än originalet).
Observera att varje kod måste vara en unik prefixkod. hjälper att hitta dessa siffror. Även om denna metod inte är utan brister, finns det videokodekar som fortfarande erbjuder denna algoritmiska metod för komprimering.
Både kodaren och avkodaren måste ha tillgång till en teckentabell med sina binära koder. Därför är det också nödvändigt att skicka med tabellen i indata.
Arithmetisk kodning
Låt oss anta att vi har en ström av tecken: a, e, är lika med noll., s och t, och deras sannolikhet presenteras i denna tabell.
| a | e | är lika med noll. | s | t | |
|---|---|---|---|---|---|
| Sannolikhet | 0,3 | 0,3 | 0,15 | 0,05 | 0,2 |
Med denna tabell bygger vi intervall som innehåller alla möjliga tecken, sorterade efter största antal.
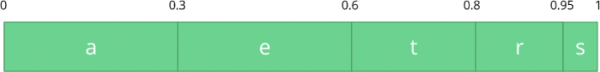
Låt oss nu koda strömmen av tre tecken: eat.
Först väljer vi det första tecknet e, som ligger i intervallet från 0,3 till 0,6 (exklusive). Vi tar detta intervall och delar det igen i samma proportioner som tidigare, men för detta nya intervall.
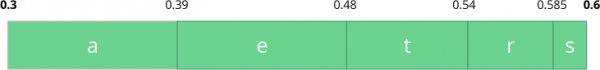
Låt oss fortsätta koda vår ström eat. Nu tar vi det andra tecknet a, som ligger i det nya intervallet från 0,3 till 0,39, och sedan tar vi vårt sista tecken t och, genom att upprepa samma process igen, får vi det sista intervallet från 0,354 till 0,372.
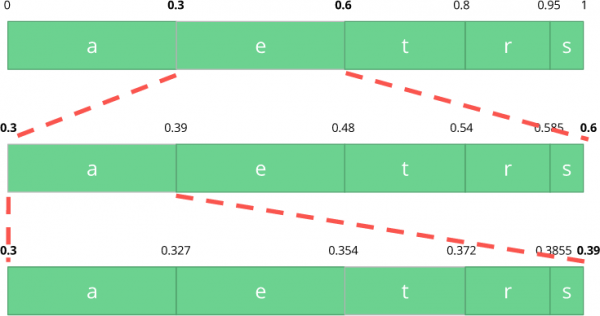
Vi behöver bara välja ett nummer i det sista intervallet från 0,354 till 0,372. Låt oss välja 0,36 (men vi kan också välja vilket annat nummer som helst inom detta intervall). Endast med detta nummer kan vi återställa vår ursprungliga ström. Det är som att vi ritade en linje inom intervallen för att koda vår ström.
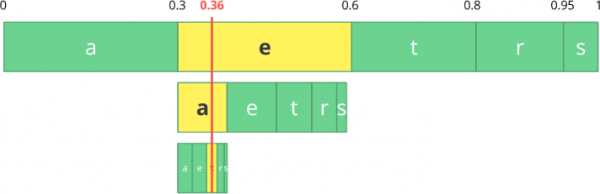
Den omvända operationen (d.v.s. avkodning) är lika enkel: med vårt nummer 0,36 och vårt ursprungliga intervall kan vi köra samma process. Men nu, med detta nummer, identifierar vi strömmen som kodades med hjälp av detta nummer.
Med det första intervallet märker vi att vårt nummer motsvarar skärningen, så detta är vårt första tecken. Låt oss nu dela upp detta intervall igen och följa samma process som tidigare. Här kan vi se att 0,36 motsvarar tecknet a, och efter att ha upprepat processen har vi kommit till det sista tecknet t (och formar vår ursprungliga kodade ström. eat).
Både kodaren och avkodaren måste ha en sannolikhetstabell för tecken tillgänglig, så det är nödvändigt att skicka med den i indata.
Ganska elegant, eller hur? Den som kom på denna lösning var verkligen smart. Vissa videokodekar använder denna teknik (eller erbjuder åtminstone den som ett alternativ).
Idén handlar om att förlora komprimering av en kvantiserad bitström. Denna artikel saknar säkert en massa detaljer, orsaker, kompromisser osv. Men om du är utvecklare bör du veta mer. Nya codecs försöker använda olika algoritmer för entropikodning, såsom ANS.
Steg 6 - bitströmformat
När allt detta är gjort återstår det att packa upp de komprimerade ramverken i kontext av de utförda stegen. Det är nödvändigt att tydligt informera dekodern om de beslut som kodaren har fattat. Dekodern måste ges all nödvändig information: bitdjup, färgrymd, upplösning, prognosinformation (rörelsevektorer, riktad INTER-prognos), profil, nivå, bildhastighet, bildtyp, bildnummer och mycket mer.
Vi kommer att bekanta oss ytligt med bitströmmen H.264. Vårt första steg är att skapa en minimal H.264 bitström (FFmpeg lägger som standard till alla kodningsparametrar, såsom SEI NAL — vi kommer att få veta vad det är längre fram). Vi kan göra detta med vårt eget arkiv och FFmpeg.
./s/ffmpeg -i /files/i/minimal.png -pix_fmt yuv420p /files/v/minimal_yuv420.h264
Detta kommando kommer att generera en rå bitström H.264 med en bild, upplösning 64×64, med färgrymden YUV420. Används som bild är följande bild.

H.264 bitström
Standard AVC (H.264) definierar att informationen kommer att överföras i makroblock (i nätverksbemärkelse), kallade NAL (detta är en sådan abstraktionsnivå i nätverket). Den huvudsakliga målsättningen för NAL är att tillhandahålla en "nätverksvänlig" representation av video. Denna standard bör fungera på TV-apparater (baserat på strömmar), på internet (baserat på paket).

Det finns en synkroniseringsmarkering för att bestämma gränserna för NAL-elementen. Varje synkroniseringsmarkering innehåller ett värde 0x00 0x00 0x01, förutom den första, som är 0x00 0x00 0x00 0x01. Om vi kör hexdump för den genererade H.264 bitströmmen, kan vi identifiera åtminstone tre NAL-mönster i början av filen.
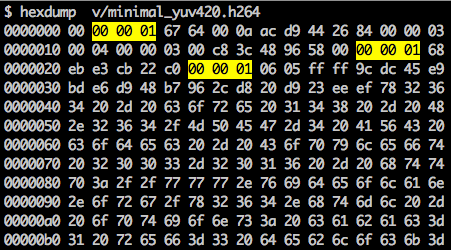
Som nämnts måste dekodern veta inte bara bilddata utan även detaljer om videon, ramen, färgerna, de använda parametrarna och mycket mer. Den första byten av varje NAL bestämmer dess kategori och typ.
| NAL typ-ID | Beskrivning |
|---|---|
| 0 | Okänd typ |
| 1 | Kodad bildfragment utan IDR |
| 2 | Kodad del av slice-data A |
| 3 | Kodad del av slice-data B |
| 4 | Kodad del av slice-data C |
| 5 | Kodad IDR-fragment av IDR-bild |
| 6 | Ytterligare information om SEI-tillägget |
| 7 | SPS-sekvensparametrar |
| 8 | PPS-bildparametrar |
| 9 | Åtkomstseparator |
| 10 | Sekvensens slut |
| 11 | Strömens slut |
| … | … |
Vanligtvis är den första NAL-biten i bitströmmen SPS. Denna typ av NAL ansvarar för att informera om allmänna kodningsvariabler, såsom profil, nivå, upplösning och mer.
Om vi hoppar över den första synkroniseringsmarkören kan vi avkoda den första byten för att ta reda på vilken typ av NAL den första är.
Till exempel, den första byten efter synkroniseringsmarkören är 01100111, där den första biten (0) finns i fältet forbidden_zero_bit. De följande 2 bitarna (11) meddelar oss fältet nal_ref_idc, som anger om denna NAL är en referensfält eller inte. Och de återstående 5 bitarna (00111) meddelar oss fältet nal_unit_type, i detta fall är det en SPS-block (7) NAL.
Den andra byten (binär=01100100, hex=0x64, dec=100) i SPS NAL är fältet profile_idc, som visar den profil som används av kodaren. I det här fallet användes den begränsade högprofilen (dvs. högprofil utan stöd för bidirektionell B-slice).
Om vi ser över bitströmspecifikationen H.264 för SPS NAL, kommer vi att upptäcka många värden för parameterets namn, kategori och beskrivning. Till exempel, låt oss titta på fälten pic_width_in_mbs_minus_1 och pic_height_in_map_units_minus_1.
| Parameternamn | Kategori | Beskrivning |
|---|---|---|
| pic_width_in_mbs_minus_1 | 0 | ue(v) |
| pic_height_in_map_units_minus_1 | 0 | ue(v) |
Om vi utför vissa matematiska operationer med värdena i dessa fält, får vi upplösningen. Vi kan representera 1920 x 1080 med pic_width_in_mbs_minus_1 värdet 119 ((119 + 1) * macroblock_size = 120 * 16 = 1920). Återigen, för att spara plats, istället för att koda 1920 gjorde vi det med 119.
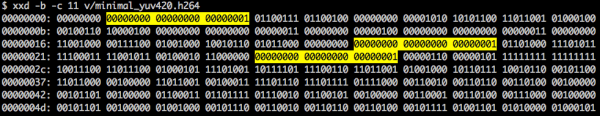
Om vi fortsätter att kontrollera vår skapade video i binär form (t.ex.: xxd -b -c 11 v/minimal_yuv420.h264), kan vi gå till sista NAL, som är själva ramen.

Här ser vi dess första 6 byte-värden: 01100101 10001000 10000100 00000000 00100001 11111111. Eftersom det är känt att den första byten anger typ av NAL, i detta fall (00101) är detta ett IDR-fragment (5), och då kan vi undersöka det vidare:
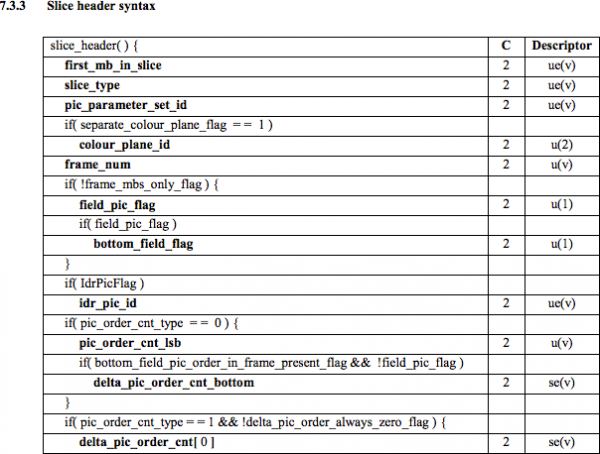
Genom att använda specifikationsinformationen kan vi avkoda fragmentets typ (slice_type) och ramenummer (frame_num) bland andra viktiga fält.
För att få värdena för vissa fält (ue(v), me(v), se(v) eller te(v), måste vi avkoda fragmentet med hjälp av en speciell avkodare, baserad på . Denna metod är mycket effektiv för att koda värden på variabler, särskilt när det finns många standardvärden.
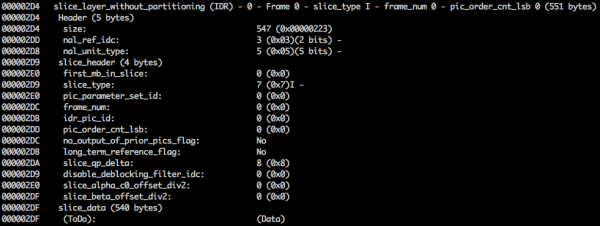
Värden slice_type och frame_num i denna video är 7 (I-fragment) och 0 (första bildrutan).
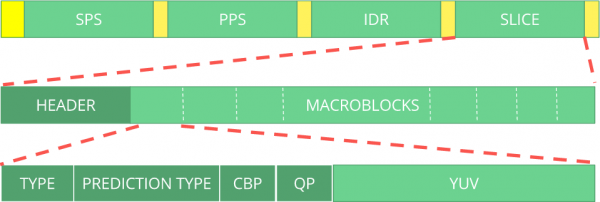
En bitström kan ses som ett protokoll. Om du vill veta mer om bitströmmen, bör du hänvisa till specifikationen ITU H.264. Här är en makroskiss som visar var bilddata finns (YUV i komprimerad form).
Du kan också utforska andra bitströmmer, som VP9, H.265 (HEVC) eller till och med vår nya bästa bitström AV1. Är de alla lika? Nej, men om du förstår åtminstone en, blir det mycket lättare att förstå de andra.
Vill du öva? Utforska H.264 bitströmmen
Du kan generera en enskild bildvideo och använda MediaInfo för att undersöka bitströmmen H.264. Faktum är att inget hindrar dig från att titta på källkoden som analyserar bitströmmen H.264 (AVC).
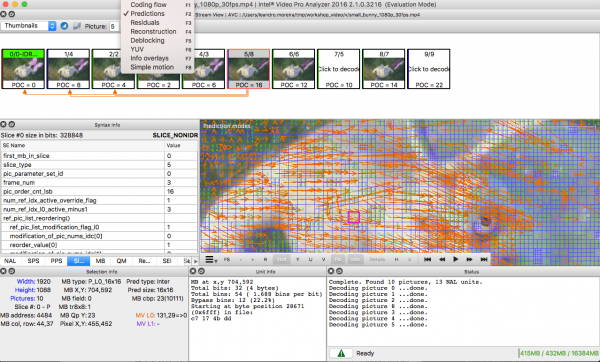
För praktiken kan du använda Intel Video Pro Analyzer (jag nämnde visst att programmet är betalt, men det finns en gratis provversion med en gräns på 10 bilder?).
Översikt
Notera att många moderna kodekar använder samma modell som vi just har lärt oss. Låt oss ta en titt på blockschemat för videokodeken Thor. Det innehåller alla steg vi har gått igenom. Hela poängen med detta meddelande är att du åtminstone ska få en bättre förståelse för innovationer och dokumentation inom detta område.
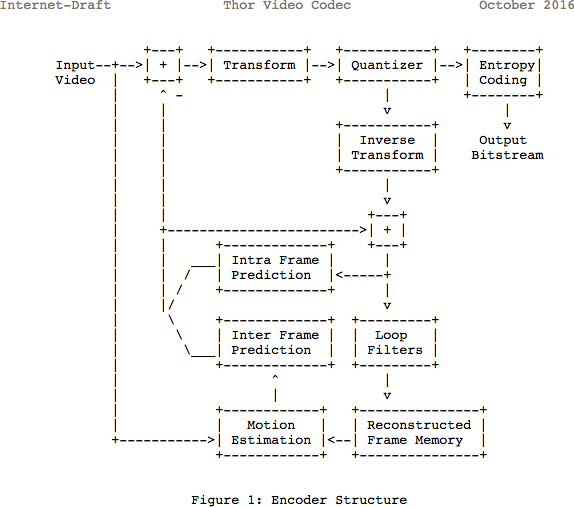
Tidigare beräknade vi att det skulle krävas 139 GB lagringsutrymme för att lagra en videofil som varar en timme vid kvalitet 720p och 30 fps. Om man använder metoderna som vi har diskuterat i denna artikel (inter-frame och intra-frame förutsägelser, transformering, kvantisering, entropikodning, osv.) kan man uppnå (givet att vi spenderar 0,031 bitar per pixel) en video av ganska god kvalitet som bara tar 367,82 MB istället för 139 GB.
Hur uppnår H.265 en bättre komprimeringsgrad än H.264?
Nu när vi vet mer om hur kodekar fungerar är det lättare att förstå hur nya kodekar kan ge högre upplösning med färre bitar.
När du jämför AVC och HEVC, kom ihåg att det nästan alltid är ett val mellan högre CPU-belastning och grad av komprimering.
HEVC har fler avsnitt (och underavsnitt) än AVC, fler riktningar för intern prognos, förbättrad entropikodning och mycket mer. Alla dessa förbättringar har gjort H.265 kapabel att komprimera 50% mer än H.264.
Första delen:
Källa: habr.com
