

Jag snubblade över ett intressant material om artificiell intelligens i spel. Med en förklaring av grundläggande saker om AI genom enkla exempel, och dessutom många användbara verktyg och metoder för dess smidiga utveckling och design. Hur, var och när de ska användas - det finns också.
De flesta exemplen är skrivna i pseudokod, så djupa programmeringskunskaper behövs inte. Under länken finns 35 sidor text med bilder och GIF:ar, så var beredd.
UPD. Jag ber om ursäkt, men jag har redan gjort min egen översättning av denna artikel på Habré. . Du kan läsa hans version , men av någon anledning har artikeln gått mig förbi (jag använde sökfunktionen, men något gick fel). Eftersom jag skriver i en blogg som är dedikerad till spelutveckling, beslutade jag mig för att lämna min egen översättning för prenumeranterna (vissa moment har jag formulerat på ett annat sätt, andra har jag medvetet utelämnat på råd från utvecklarna).
Vad är AI?
Spel-AI fokuserar på vilka åtgärder ett objekt ska vidta baserat på de förhållanden det befinner sig i. Detta kallas vanligtvis för att hantera 'intelligenta agenter', där agenten är en spelkaraktär, ett fordon, en bot, och ibland något mer abstrakt: en hel grupp av entiteter eller till och med en civilisation. I varje fall är det något som ska kunna se sin omgivning, fatta beslut baserat på den och agera i enlighet med detta. Detta kallas Sense/Think/Act-cykeln (Känna/Tänka/Agera):
- Känna: agenten hittar eller får information om saker i sin miljö som kan påverka dess beteende (hot i närheten, föremål att samla, intressanta platser att utforska).
- Tänka: agenten beslutar hur den ska reagera (överväger om det är tillräckligt säkert att samla föremål eller om den först måste slåss/gömma sig).
- Agera: agenten utför åtgärder för att genomföra det föregående beslutet (börjar röra sig mot motståndaren eller objektet).
- …situationen har nu förändrats på grund av karaktärernas handlingar, så cykeln börjar om med nya uppgifter.
AI fokuserar vanligtvis på Sense-delen av cykeln. Till exempel gör självkörande bilar bilder av vägen, kombinerar dem med radar- och lidar-data samt tolkar dem. Vanligtvis görs detta av maskininlärning, som bearbetar indata och ger dem mening, genom att extrahera semantisk information som "det finns en annan bil 20 meter framför dig". Detta kallas för klassificeringsproblem.
Spel behöver inte ett komplext system för att extrahera information, eftersom största delen av datan redan är en integrerad del av det. Det är inte nödvändigt att köra algoritmer för bildigenkänning för att avgöra om det finns en fiende framför — spelet vet redan och överför informationen direkt under beslutsprocessen. Därför är Sense-delen av cykeln ofta mycket enklare än Think och Act.
Begränsningar för spel-AI
AI har flera begränsningar som måste följas:
- AI behöver inte tränas i förväg, som en maskininlärningsalgoritm. Det är meningslöst att skriva ett neuralt nätverk under utvecklingen för att observera tiotusentals spelare och lära sig det bästa sättet att spela mot dem. Varför? För att spelet inte har släppts ännu och det inte finns några spelare.
- Spelet ska underhålla och utmana, så agenterna får inte hitta det bästa tillvägagångssättet mot människor.
- Agenterna måste se realistiska ut, så att spelarna känner att de spelar mot riktiga människor. AlphaGo överträffade människor, men de valda dragen var långt ifrån traditionell förståelse av spelet. Om spelet imiterar en mänsklig motståndare ska det inte finnas den känslan. Algoritmen måste förändras för att ta rimliga beslut snarare än perfekta idéer.
- AI måste fungera i realtid. Det betyder att algoritmen inte kan monopoliserar CPU-användningen under lång tid för att ta beslut. Även 10 millisekunder för detta är för länge, eftersom de flesta spel behöver mellan 16 och 33 millisekunder för att slutföra all bearbetning och gå vidare till nästa grafikram.
- Det är idealiskt om åtminstone en del av systemet styrs av data, så att "icke-kodare" kan göra ändringar, och så att justeringar sker snabbare.
Låt oss överväga AI-ansatser som täcker hela cykeln Sense/Think/Act.
Beslut om grundläggande beslut
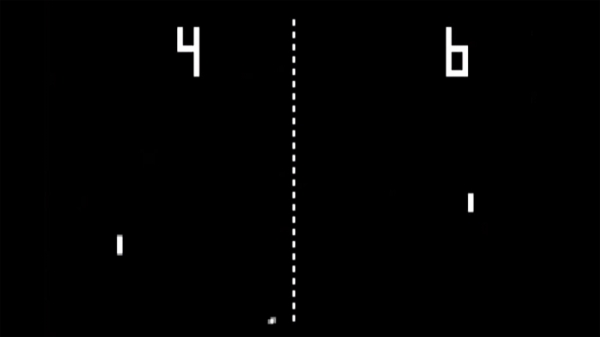
Låt oss börja med det enklaste spelet – Pong. Målet är att flytta plattan (paddle) så att bollen studsar mot den istället för att passera förbi. Det är som tennis där du förlorar om du inte slår tillbaka bollen. Här har AI en relativt enkel uppgift – att avgöra i vilken riktning plattan ska flyttas.
Villkorssatser
För AI i Pong finns det en uppenbar lösning – alltid försöka placera plattan under bollen.
Ett enkelt algoritm för detta, skrivet i pseudokod:
varje bilduppdatering medan spelet pågår:
om bollen är till vänster om plattan:
flytta plattan vänster
annars om bollen är till höger om plattan:
flytta plattan höger
Om plattan rör sig med bollens hastighet är det en perfekt algoritm för AI i Pong. Det är inget som behöver kompliceras, om det inte finns så många data och möjliga handlingar för agenten.
Denna metod är så enkel att hela cykeln Sense/Think/Act knappt märks. Men den finns där:
- Delen Sense finns i de två if-satserna. Spelet vet var bollen och plattan är, så AI vänder sig till den för denna information.
- Delen Think ingår också i de två if-satserna. De representerar två beslut som i detta fall är ömsesidigt uteslutande. Som ett resultat väljs en av tre åtgärder – flytta plattan åt vänster, flytta åt höger, eller inte göra något om den redan är korrekt placerad.
- Delen Act finns i satserna Flytta Plattan Vänster och Flytta Plattan Höger. Beroende på spelets design kan de flytta plattan omedelbart eller med en viss hastighet.
Sådana metoder kallas reaktiva – det finns en enkel uppsättning regler (i det här fallet if-satserna i koden) som reagerar på den aktuella världens tillstånd och agerar.
Besluts träd
Exemplet med spelet Pong är i princip likvärdigt med den formella AI-konceptet som kallas besluts träd. Algoritmen går igenom det för att nå ett "blad" – beslutet om vilken åtgärd som ska vidtas.
Låt oss skapa ett flödesschema för besluts trädet för vår plattforms algoritm:
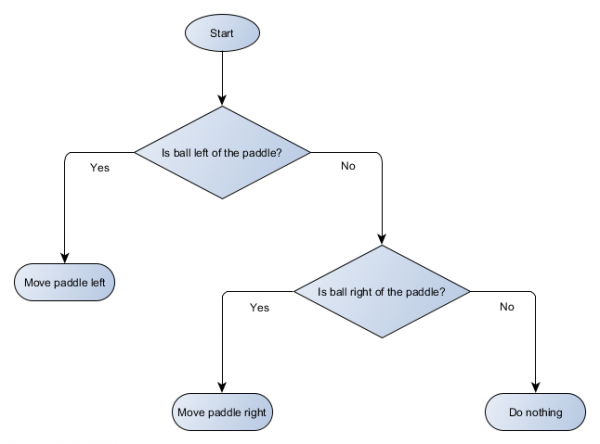
Varje del av trädet kallas node (nod) – AI använder grafteori för att beskriva sådana strukturer. Det finns två typer av noder:
- Besluts noder: val mellan två alternativ baserat på kontroll av ett visst villkor, där varje alternativ representeras som en separat nod.
- Slutnoder: åtgärder att utföra, vilket representerar det slutgiltiga beslutet.
Algoritmen börjar med den första noden ("rotnoden" av trädet). Den antingen fattar ett beslut om vilken undernod att gå till, eller så utför den en åtgärd som är lagrad i noden och avslutas.
Vad är då fördelen om ett beslutsträd gör samma jobb som if-satserna i avsnittet ovan? Här finns ett gemensamt system där varje beslut har endast ett villkor och två möjliga resultat. Detta gör det möjligt för utvecklaren att skapa AI utifrån data som representerar beslut i trädet, utan att hårdkoda det. Låt oss föreställa oss det i en tabell:
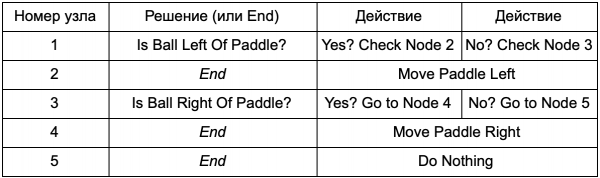
På kodsidan får du ett system för att läsa strängar. Skapa en nod för var och en av dem, koppla logik för beslutsfattande baserat på den andra kolumnen och undernoder baserat på den tredje och fjärde kolumnen. Du behöver fortfarande programmera villkor och åtgärder, men nu blir spelstrukturen mer komplex. Du lägger till fler beslut och åtgärder och konfigurerar hela AI:n genom att helt enkelt redigera en textfil med definitionen av trädet. Därefter överlämnar du filen till speldesignern, som kan ändra beteendet utan att behöva rekonstruera spelet eller ändra koden.
Beslutsträd är mycket användbara när de byggs automatiskt baserat på en stor mängd exempel (t.ex. med hjälp av ID3-algoritmen). Detta gör dem till ett effektivt och högpresterande verktyg för att klassificera situationer baserat på insamlade data. Men vi går bortom ett enkelt system för att välja åtgärder för agenter.
Scenarier
Vi har gått igenom systemet för beslutsträd som använde fördefinierade villkor och åtgärder. Människor som designar AI kan organisera trädet som de vill, men de måste fortfarande förlita sig på en programmerare som har kodar det hela. Vad om vi kunde ge designern verktyg för att skapa egna villkor eller åtgärder?
För att programmet inte ska behöva skriva kod för villkoren Is Ball Left Of Paddle och Is Ball Right Of Paddle, kan det skapa ett system där designern skriver villkoren för att kontrollera dessa värden. Då skulle data i beslutsträdet se ut så här:
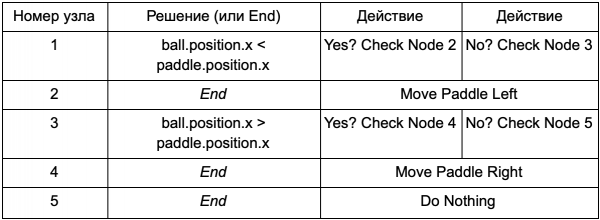
I grunden är detta detsamma som i den första tabellen, men lösningarna inom sig har egen kod, som liknar den villkorliga delen av en if-sats. I koden skulle detta läsas i den andra kolumnen för beslutsknutar, men istället för att söka efter ett specifikt villkor att utföra (Är bollen till vänster om paddeln), utvärderar det det villkorliga uttrycket och returnerar true eller false därefter. Detta görs med hjälp av skriptspråket Lua eller Angelscript. Genom dessa kan utvecklaren ta objekt i sitt spel (boll och paddel) och skapa variabler som kommer att vara tillgängliga i skriptet (boll.position). Dessutom är skriptspråket enklare än C++. Det kräver inte en fullständig kompilering, vilket gör det perfekt för snabb justering av spel logik och låter "icke-kodare" själva skapa nödvändiga funktioner.
I det givna exemplet används skriptspråket endast för att utvärdera det villkorliga uttrycket men kan också användas för åtgärder. Till exempel kan data Move Paddle Right bli en skriptoperator (boll.position.x += 10). Således kan åtgärden också definieras i skriptet, utan behov av att programmera Move Paddle Right.
Man kan gå längre och helt skriva besluts trädet i skriptspråket. Detta skulle vara kod i form av hårdkodade villkorssatser, men de skulle finnas i externa skriptfiler, vilket betyder att de kan ändras utan att behöva kompilera om hela programmet. Ofta kan man ändra skriptfilen mitt under spelet för att snabbt testa olika AI-reaktioner.
Reagera på händelser
Exemplen ovan passar perfekt i Pong. De kör kontinuerligt cykeln Sense/Think/Act och agerar baserat på världens senaste tillstånd. Men i mer komplicerade spel behöver man reagera på specifika händelser, istället för att utvärdera allt på en gång. Pong är i så fall redan ett dåligt exempel. Låt oss välja ett annat.
Föreställ dig en shooter där fienderna står stilla tills de upptäcker spelaren, varefter de agerar beroende på sin "specialisering": vissa kommer att rush'a, andra kommer att attackera på avstånd. Detta är fortfarande ett grundläggande reaktionssystem — "om spelaren upptäcktes, gör något" — men det kan logiskt delas upp i händelsen Player Seen (spelare upptäckt) och reaktionen (välj ett svar och utför det).
Det här tar oss tillbaka till cykeln Sense/Tänk/Utför. Vi kan programmera Sense-delen som varje ram kontrollerar om AI:n ser spelaren. Om inte händer ingenting, men om den gör det skapas en händelse kallad Player Seen. Koden kommer att ha en separat sektion som säger: "när händelsen Player Seen inträffar, gör ", där är svaret du behöver för att anropa delarna Tänk och Utför. På så sätt ställer du in reaktioner på händelsen Player Seen: för en "rushande" karaktär – ChargeAndAttack, och för en snipervapen – HideAndSnipe. Dessa samband kan skapas i en databas för snabb redigering utan att behöva kompilera om. Och här kan vi också använda skriptspråk.
Att fatta komplexa beslut
Även om enkla reaktionssystem är mycket effektiva finns det många situationer där de inte räcker. Ibland måste olika beslut fattas beroende på vad agenten gör för tillfället, men att representera detta som ett villkor är svårt. Ibland finns det för många villkor för att effektivt representera dem i ett beslutsträd eller skript. Ibland måste man förutse hur situationen kommer att förändras innan man fattar beslut om nästa steg. För att lösa dessa problem behövs mer komplexa metoder.
Ändlig tillståndsmaskin
Ändlig tillståndsmaskin eller FSM (Finita tillståndsmaskin) är ett sätt att säga att vår agent för närvarande befinner sig i ett av flera möjliga tillstånd och att han kan övergå från ett tillstånd till ett annat. Det finns ett bestämt antal sådana tillstånd – därav namnet. Det bästa exemplet från verkligheten är trafikljuset. På olika platser finns det olika sekvenser av ljus, men principen är densamma – varje tillstånd representerar något (stanna, gå, etc.). Trafikljuset befinner sig bara i ett tillstånd vid varje given tidpunkt och går från ett tillstånd till ett annat baserat på enkla regler.
Med NPC:er i spel är det en liknande historia. Låt oss ta en vakthavande med dessa tillstånd:
- Patrullerande (Patrolling).
- Angripande (Attacking).
- Flyende (Fleeing).
Och med dessa villkor för att förändra hans tillstånd:
- Om vakten ser en fiende, attackerar han.
- Om vakten attackerar, men inte längre ser fienden, återgår han till att patrullera.
- Om vakten attackerar, men är svårt skadad, flyr han.
Man kan också skriva if-operatorer med en tillståndsvariabel för vakten och olika kontroller: finns det en fiende i närheten, vad är NPC:ns hälsotillstånd osv. Låt oss lägga till några fler tillstånd:
- Inaktivitet (Idling) — mellan patruller.
- Sökning (Searching) — när en fiende har setts men har gömt sig.
- Be om hjälp (Finding Help) — när en fiende har setts, men är för stark för att slåss ensam.
Valet för var och en är begränsat — till exempel kommer en vakt inte att söka efter en gömd fiende om han har låg hälsa.
Till slut kan en lång lista med "om och" bli för otymplig, så vi bör formaliserar en metod som gör det möjligt för oss att hålla reda på tillstånd och övergångar mellan tillstånd. <x и y, но не z>, så <p>För att göra detta kommer vi att ta hänsyn till alla tillstånd och under varje tillstånd skriva upp alla övergångar till andra tillstånd, tillsammans med de nödvändiga villkoren för dem.
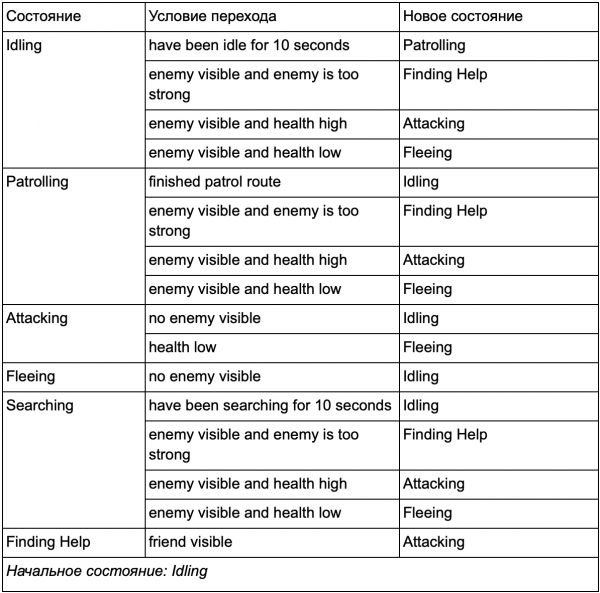
Detta är en övergångstabell för tillstånd — ett omfattande sätt att representera FSM. Vi ritar ett diagram och får en fullständig översikt över hur NPC:ns beteende förändras.
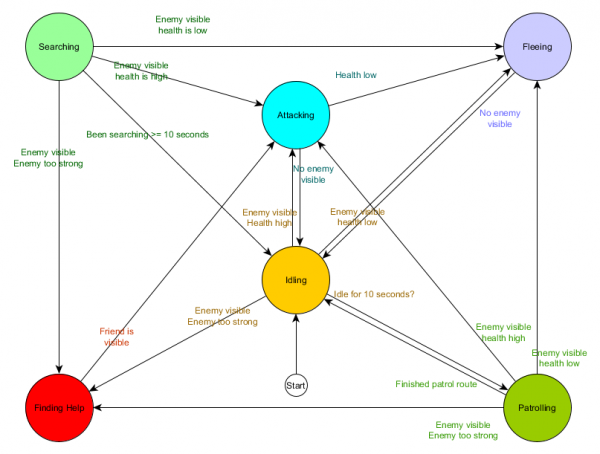
Diagrammet visar kärnan i beslutsfattande för denna agent baserat på den aktuella situationen. Varje pil visar en övergång mellan tillstånd, om villkoret bredvid är sant.
Vid varje uppdatering kontrollerar vi agentens aktuella tillstånd, går igenom listan över övergångar, och om villkoren för övergången är uppfyllda, antar han ett nytt tillstånd. Till exempel kontrolleras det varje bild om den 10-sekunders timer har löpt ut, och om ja, övergår vakten från Inaktivitet till Patrullering. På samma sätt kontrollerar tillståndet Angripande agentens hälsa — om den är låg, övergår han till tillståndet Fly.
Detta är bearbetning av övergångar mellan tillstånd, men hur är det med beteendet kopplat till själva tillstånden? När det gäller att implementera det faktiska beteendet för ett specifikt tillstånd finns det vanligtvis två typer av "hooks", där vi tilldelar åtgärder till FSM:
- Åtgärder som vi utför regelbundet för det aktuella tillståndet.
- Åtgärder som vi vidtar när vi övergår från ett tillstånd till ett annat.
Exempel för den första typen. I tillståndet Patrullering kommer agenten varje bild att röra sig längs patrullvägen. I tillståndet Angripande kommer agenten varje bild att försöka påbörja en attack eller övergå till ett tillstånd när det är möjligt.
För den andra typen kan vi överväga övergången "om fienden är synlig och fienden är för stark, så gå in i tillståndet Finding Help. Agenten måste välja vart de ska gå för hjälp och spara denna information så att tillståndet Finding Help vet vart de ska vända sig. Så snart hjälpen har hittats, går agenten tillbaka till tillståndet Attacking. Vid det tillfället kanske de vill berätta för en allierad om hotet, så en åtgärd kan inträffa: NotifyFriendOfThreat.
Och återigen kan vi se på detta system genom linsen av cykeln Sense/Think/Act. Sense uttrycks i de data som används av övergångslogiken. Think — är de övergångar som är tillgängliga i varje tillstånd. Och Act sker genom åtgärder som utförs periodiskt inom tillståndet eller vid övergångar mellan tillstånden.
Ibland kan kontinuerlig övervakning av övergångsvillkor vara kostsam. Till exempel, om varje agent skulle utföra komplexa beräkningar varje bildrute för att avgöra om de ser fiender och om de borde gå från tillståndet Patrolling till Attacking — skulle det ta mycket processortid.
Viktiga förändringar i världens tillstånd kan ses som händelser som kommer att hanteras när de inträffar. Istället för att FSM varje bildrute kontrollerar övergångsvillkoret "kan min agent se spelaren?", kan vi konfigurera ett separat system för att utföra kontrollerna mer sällan (till exempel 5 gånger per sekund). Som resultat ges Player Seen när kontrollen godkänns.
Detta skickas vidare till FSM, som nu måste gå in i tillståndet Player Seen event received och reaktionsmässigt agera. Det slutgiltiga beteendet är detsamma, förutom en nästan omärkbar fördröjning innan svaret ges. Resultatet är att prestandan har förbättrats genom att separera en del av Sense till en separat del av programmet.
Hierarkisk ändlig tillståndsmaskin
Att arbeta med stora FSM är dock inte alltid bekvämt. Om vi vill expandera angreppstillståndet genom att ersätta det med separata MeleeAttacking (närstrid) och RangedAttacking (distansangrepp), måste vi justera övergångarna från alla andra tillstånd som leder till tillståndet Attacking (både nuvarande och framtida).
Du har säkert lagt märke till att vårt exempel har många dubblerade övergångar. De flesta övergångar i tillståndet Idling är identiska med övergångarna i tillståndet Patrolling. Det vore bra att undvika upprepningar, särskilt om vi lägger till fler liknande tillstånd. Det är meningsfullt att gruppera Idling och Patrolling under en gemensam etikett "icke-strid", där det bara finns ett gemensamt uppsättning övergångar till stridstillstånd. Om vi föreställer oss denna etikett som ett tillstånd, skulle Idling och Patrolling bli del-tillstånd. Ett exempel på användning av en separat övergångstabell för det nya icke-stridstillståndet:
Huvudtillstånd:
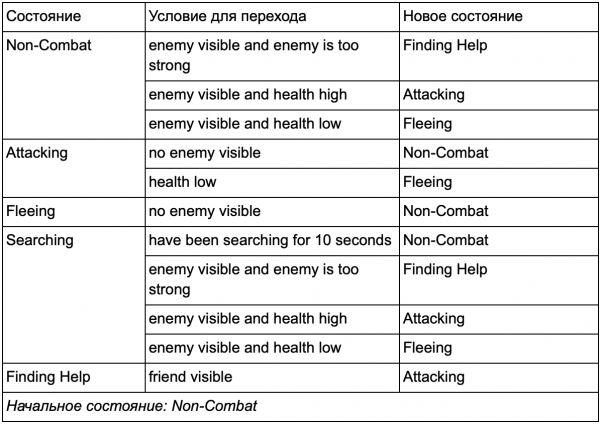
Icke-stridstillstånd:
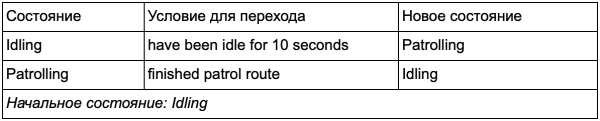
Och i form av ett diagram:
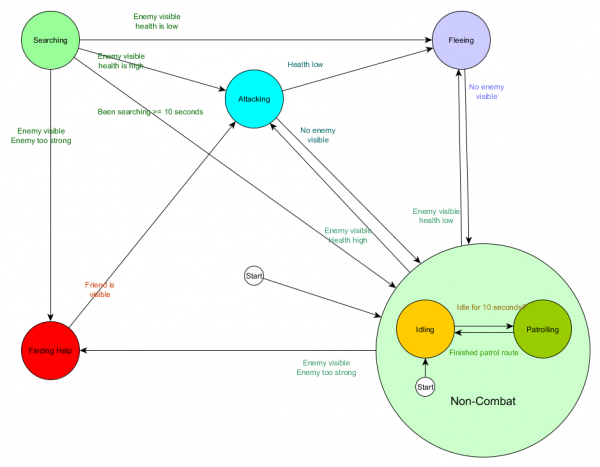
Det är samma system, men med ett nytt icke-stridstillstånd som inkluderar Idling och Patrolling. Med varje tillstånd som innehåller FSM med del-tillstånd (och dessa del-tillstånd i sin tur innehåller sina egna FSM — och så vidare, så många du behöver), får vi ett Hierarchical Finite State Machine eller HFSM (hierarkisk ändlig automat). Genom att gruppera det icke-stridstillståndet har vi skapat en hel del onödiga övergångar. Detsamma kan vi göra för eventuella nya tillstånd med gemensamma övergångar. Till exempel, om vi i framtiden utökar tillståndet Attacking till tillstånden MeleeAttacking och MissileAttacking, kommer dessa vara del-tillstånd som övergår mellan varandra baserat på avståndet till fienden och tillgången på ammunition. Som ett resultat kan komplexa beteendemodeller och delmodeller representeras med minimalt av dubblerade övergångar.
Beteendeträd
Med HFSM skapas komplexa kombinationer av beteenden på ett enkelt sätt. Det finns dock en liten svårighet, att beslutsfattande i form av övergångsregler är nära kopplat till det aktuella tillståndet. Och i många spel är detta just vad som behövs. En noggrann användning av tillståndshierarkier kan minska antalet upprepningar vid övergångar. Men ibland behövs regler som fungerar oberoende av vilket tillstånd du är i, eller som tillämpas i nästan alla tillstånd. Till exempel, om agentens hälsa faller under 25%, vill du att den ska fly oavsett om den har varit i strid, slappnat av eller pratat — du måste lägga till detta villkor i varje tillstånd. Och om din designer senare vill ändra tröskeln för låg hälsa från 25% till 10%, måste detta åtgärdas igen.
I idealfall behövs ett system där besluten om "vilket tillstånd man ska vara i" ligger utanför själva tillstånden, så att förändringar endast behöver göras på ett ställe utan att påverka övergångsvillkoren. Här kommer beteendeträd in i bilden.
Det finns flera sätt att implementera detta, men kärnan är ungefär densamma och liknar ett beslutsträd: algoritmen börjar med en "rot"-nod, och i trädet finns noder som representerar antingen beslut eller handlingar. Det finns dock några viktiga skillnader:
- Nu returnerar noderna ett av tre värden: Succeeded (om arbetet har slutförts), Failed (om det inte går att starta) eller Running (om det fortfarande körs och inget slutresultat har nåtts).
- Det finns inte längre beslutsnoder för att välja mellan två alternativ. Istället finns det Decorator-noder, som har en enda undernod. Om de lyckas så utför de sin enda undernod.
- Noder som utför handlingar returnerar värdet Running för att representera de pågående handlingarna.
Denna lilla uppsättning noder kan kombineras för att skapa många komplexa beteendemodeller. Låt oss föreställa oss HFSM:n från det tidigare exemplet som ett beteendeträd:
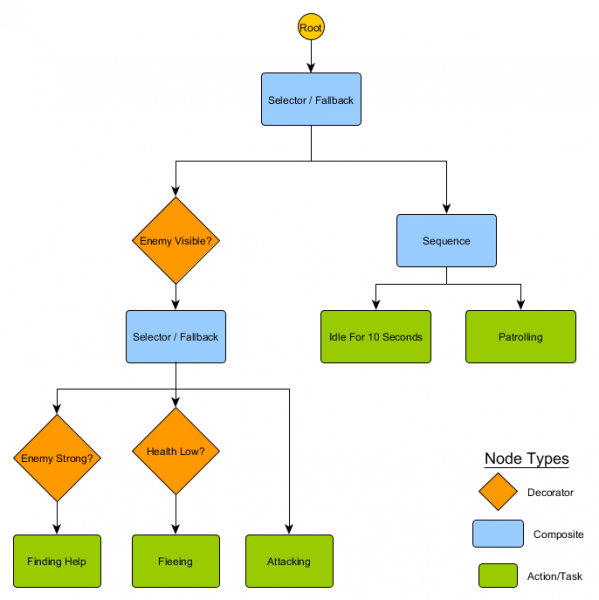
Med denna struktur bör det inte finnas någon tydlig övergång från tillstånden Idling/Patrolling till tillståndet Attacking eller något annat. Om fienden är synlig och karaktärens hälsa är låg, kommer exekveringen att stanna på noden Fleeing, oavsett vilken nod den tidigare exekverade — Patrolling, Idling, Attacking eller någon annan.
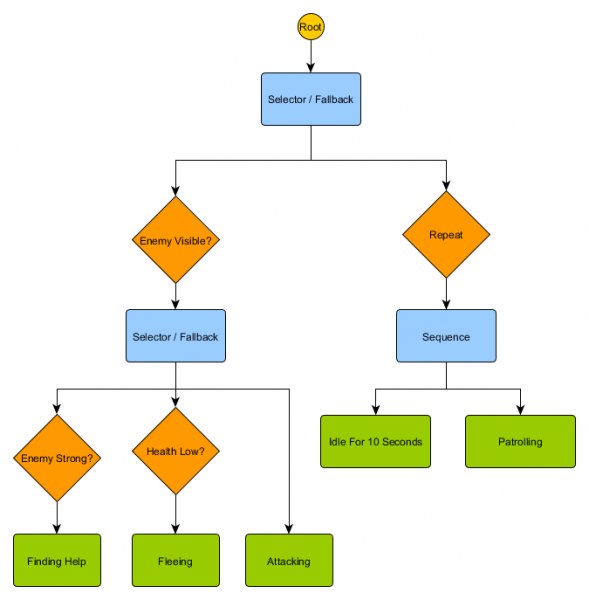
Beteendeträd är komplexa — det finns många sätt att konstruera dem, och att hitta rätt kombination av dekoratörer och kompositnoder kan vara utmanande. Det finns också frågor om hur ofta man ska kontrollera trädet — vill vi gå igenom varje del eller bara när ett av villkoren har förändrats? Hur ska man lagra tillståndet som relaterar till noderna — hur vet vi när vi har varit i tillståndet Idling i tio sekunder, eller hur vet vi vilka noder som exekverades senast för att korrekt hantera sekvensen?
Det är just därför det finns många olika implementeringar. Till exempel har i vissa system decorator-noder ersatts med inbyggda dekoratorer. Dessa omvärderar trädet när dekoratorns villkor ändras, hjälper till att koppla ihop noder och erbjuder periodiska uppdateringar.
Utility-baserat system
Vissa spel har många olika mekaniker. Det är önskvärt att de får alla fördelar av enkla och allmänna regler för övergångar, men inte nödvändigtvis i form av ett fullt beteendeträd. Istället för att ha en tydlig uppsättning val eller ett träd av möjliga handlingar är det enklare att lära sig alla handlingar och välja den mest lämpliga i stunden.
Ett system baserat på nytta hjälper just i det här. Det är ett system där agenten har många olika handlingar och själv väljer vilken han ska utföra, baserat på den relativa nyttan av varje av dem. Här är nyttan ett godtyckligt mått på hur viktigt eller önskvärt det är för agenten att utföra denna handling.
Den beräknade nyttan av en handling baserat på det aktuella tillståndet och miljön kan agenten kontrollera och välja den mest lämpliga andra tillståndet när som helst. Detta liknar en FSM, förutom att övergångarna definieras av bedömningen för varje potentiellt tillstånd, inklusive det aktuella. Observera att vi väljer den mest användbara handlingen för att gå vidare (eller stanna kvar om vi redan har genomfört den). För mer variation kan detta vara ett viktat, men slumpmässigt val från en liten lista.
Systemet tilldelar ett godtyckligt intervall av nyttovärden — till exempel från 0 (helt oönskat) till 100 (fullt önskvärt). Varje handling har en rad parametrar som påverkar beräkningen av detta värde. Återigen med vårt exempel med vakten:
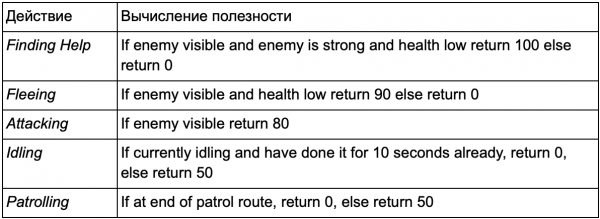
Övergångar mellan handlingar är oklara — vilket tillstånd som helst kan följa efter något annat. Prioriteringarna av handlingar ligger i de återkommande nytta värdena. Om fienden är synlig, och fienden är stark, medan karaktärens hälsa är låg, kommer både Fleeing och FindingHelp att ge höga, icke-noll värden. Samtidigt kommer FindingHelp alltid att vara högre. På samma sätt ger icke-stridshandlingar aldrig mer än 50, så de kommer alltid att vara lägre än stridshandlingar. Detta måste beaktas när man skapar handlingar och beräknar deras nytta.
I vårt exempel returnerar åtgärder antingen ett fast konstant värde eller ett av två fasta värden. Ett mer realistiskt system skulle föreslå att man returnerar en bedömning från ett kontinuerligt intervall av värden. Till exempel returnerar åtgärden Fleeing högre nytta värden om agentens hälsa är låg, medan åtgärden Attacking returnerar lägre värden om fienden är för stark. På grund av detta har åtgärden Fleeing prioritet över Attacking i alla situationer där agenten känner att han inte har tillräcklig hälsa för att besegra motståndaren. Detta möjliggör att ändra prioriteringar baserat på ett antal kriterier, vilket gör denna metod mer flexibel och variabel än beteendeträd eller FSM.
Varje åtgärd har många villkor för att beräkna programmet. Dessa kan skrivas på ett skriptspråk eller som en serie matematiska formler. I The Sims, som modellerar karaktärens dagliga rutiner, läggs en ytterligare nivå av beräkningar till - agenten får en rad "motivationer" som påverkar nytta värderingarna. Om karaktären är hungrig kommer han så småningom att bli ännu hungrigare, och nyttovärdet för åtgärden EatFood kommer att öka tills karaktären utför den, vilket minskar hungernivån och återställer värdet av EatFood till noll.
Idén att välja åtgärder baserat på ett bedömningssystem är ganska enkel, så ett utility-baserat system kan användas som en del av AI: s beslutsprocesser snarare än som en fullständig ersättning. Beslutsträdet kan be om bedömning av två barnknutar och välja den som har högre värde. På liknande sätt kan ett beteendeträd ha en sammansatt nod Utility för att bedöma nyttan av åtgärder för att avgöra vilken barnelement som ska utföras.
Rörelse och navigering
I de tidigare exemplen hade vi en plattform som vi flyttade åt vänster eller höger, och en väktare som patrullerade eller attackerade. Men hur hanterar vi själva agentens rörelse över en viss tidsperiod? Hur ställer vi in hastigheten, hur undviker vi hinder och hur planerar vi rutten om det är svårare att nå destinationen än att bara röra sig i en rak linje? Låt oss ta en titt på detta.
Hantering
I början kommer vi att anta att varje agent har ett hastighetsvärde, som inkluderar hur snabbt den rör sig och i vilken riktning. Det kan mätas i meter per sekund, kilometer per timme, pixlar per sekund, osv. Med minnet av cykeln Sinna/Tänka/Handla kan vi föreställa oss att delen Tänka väljer hastigheten, medan delen Handla tillämpar den hastigheten på agenten. Vanligtvis finns det ett fysiksystem i spel som utför den här uppgiften åt dig, genom att studera hastighetsvärdet för varje objekt och justera det. Därför kan vi överlåta AI:t en enda uppgift – att avgöra vilken hastighet agenten ska ha. Om vi vet var agenten ska vara, måste vi flytta den i rätt riktning med den angivna hastigheten. En mycket trivial ekvation:
desired_travel = destination_position – agent_position
Föreställ dig en 2D-värld. Agenten befinner sig vid punkten (-2,-2), destinationen ligger någonstans nordost i punkten (30, 20), och den nödvändiga vägen för agenten att komma dit är (32, 22). Anta att dessa positioner mäts i meter – om vi antar att agentens hastighet är 5 meter per sekund, kommer vi att skala vår rörelsevektor och få en hastighet på ungefär (4.12, 2.83). Med dessa parametrar skulle agenten nå destinationen efter nästan 8 sekunder.
Värden kan räknas om när som helst. Om agenten var halvvägs till målet, skulle rörelsen vara hälften av längden, men eftersom agentens maximala hastighet är 5 m/s (vilket vi bestämde tidigare), kommer hastigheten att vara densamma. Detta fungerar också för rörliga mål, vilket gör det möjligt för agenten att göra små justeringar när de rör sig.
Men vi vill ha mer variation – till exempel att långsamt öka hastigheten för att simulera en karaktär som rör sig från stillastående till löpande. Samma sak kan göras i slutet innan stopp. Dessa funktioner kallas steering behaviours, där varje har specifika namn: Seek (sök), Flee (fly), Arrival (ankomst) osv. Idén är att accelerationer kan tillämpas på agentens hastighet, baserat på en jämförelse mellan agentens position och nuvarande hastighet med destinationen, för att använda olika sätt att röra sig mot målet.
Varje beteende har ett något annat syfte. Seek och Arrival är sätt att flytta agenten till destinationspunkten. Obstacle Avoidance (undvikande av hinder) och Separation (separation) justerar agentens rörelse för att kringgå hinder på vägen till målet. Alignment (samordning) och Cohesion (sammanslutning) håller agenterna tillsammans när de rör sig. Ett antal olika styrningsbeteenden kan summeras för att få en enda vägvektor med hänsyn till alla faktorer. En agent använder beteendena Arrival, Separation och Obstacle Avoidance för att hålla sig borta från väggar och andra agenter. Denna metod fungerar bra i öppna miljöer utan överflödiga detaljer.
Under svårare förhållanden fungerar sammanslagningen av olika beteenden sämre — till exempel kan agenten fastna i väggen på grund av konflikten mellan Arrival och Obstacle Avoidance. Därför måste vi överväga alternativ som är mer komplexa än bara en enkel summering av alla värden. En sådan metod är: istället för att summera resultaten av varje beteende kan vi överväga rörelser i olika riktningar och välja den bästa.
Men i en komplex miljö med återvändsgränder och val av vilken riktning man ska gå, behöver vi något ännu mer avancerat.
Sökväg
Steering behaviours är utmärkta för enkel rörelse på öppen mark (fotbollsplan eller arena), där vägen från A till B är en rak linje med små avvikelser runt hinder. För komplexa rutter behöver vi pathfinding (sökväg), som är ett sätt att utforska världen och fatta beslut om rutten genom den.
Det enklaste sättet är att lägga ett rutnät över varje ruta intill agenten och bedöma i vilka av dem det är tillåtet att röra sig. Om någon av dem är en destination, följ vägen från varje ruta tillbaka till föregående, tills du når början. Det är vägen. Om inte upprepa processen med närmaste andra rutor, tills du hittar destinationen eller rutorna tar slut (detta innebär att det inte finns någon möjlig väg). Detta kallas formellt för Breadth-First Search eller BFS (bredd först-sökning). På varje steg tittar det åt alla håll (därav bredd). Sökområdet liknar en vågfront som rör sig tills den når målet — sökområdet expanderar för varje steg tills slutpunkten inkluderas, varefter vägen tillbaka kan spåras till början.
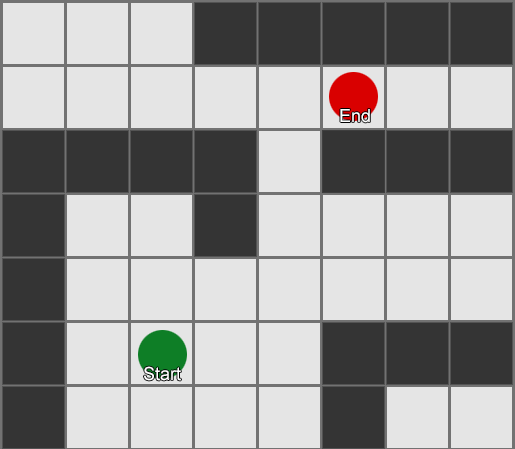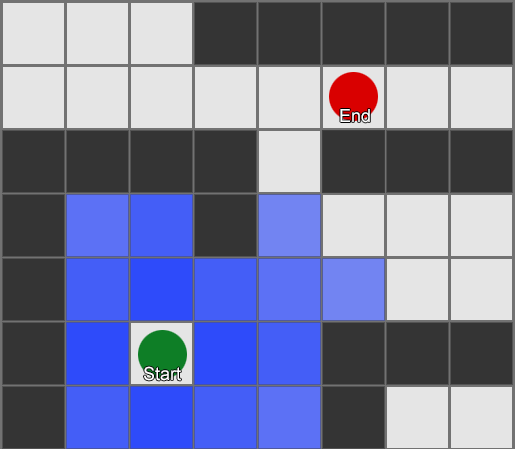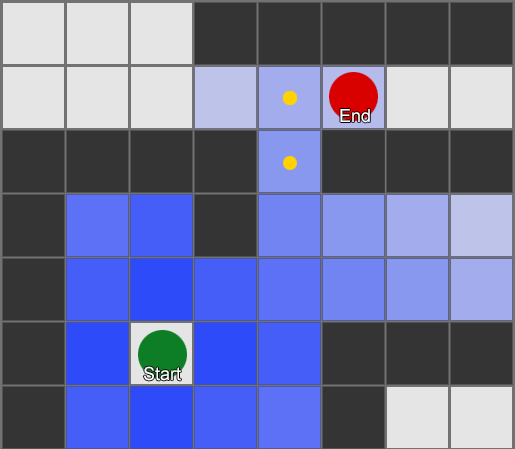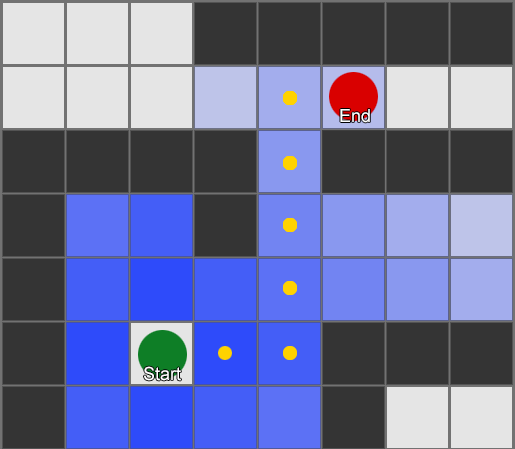
Som ett resultat får du en lista över rutor som utgör den önskade vägen. Detta är vägen (därav pathfinding) — en lista över ställen som agenten kommer att besöka på väg till destinationen.
Eftersom vi känner till positionen för varje ruta i världen kan vi använda steering behaviors för att röra oss längs vägen — från nod 1 till nod 2, sedan från nod 2 till nod 3 och så vidare. Det enklaste alternativet är att rikta in sig på mitten av nästa ruta, men det är ännu bättre att stanna vid mitten av kanten mellan den nuvarande rutan och den nästa. Detta gör att agenten kan skära hörn vid branta svängar.
BFS-algoritmen har även nackdelar — den utforskar lika många rutor i "fel" riktning som i "rätt". Här framträder en mer avancerad algoritm kallad A* (A star). Den fungerar på liknande sätt men istället för att blint utforska grannrutor (sen grannarnas grannar, sedan grannarnas grannars grannar och så vidare), samlar den noder i en lista och sorterar dem så att nästa utforskade nod alltid är den som leder till den kortaste vägen. Noder sorteras baserat på en heuristik som beaktar två saker — "kostnaden" för den hypotetiska vägen till den önskade rutan (inklusive eventuella rörlighetskostnader) och en bedömning av hur långt denna ruta är från destinationen (och flyttar sökningen i rätt riktning).
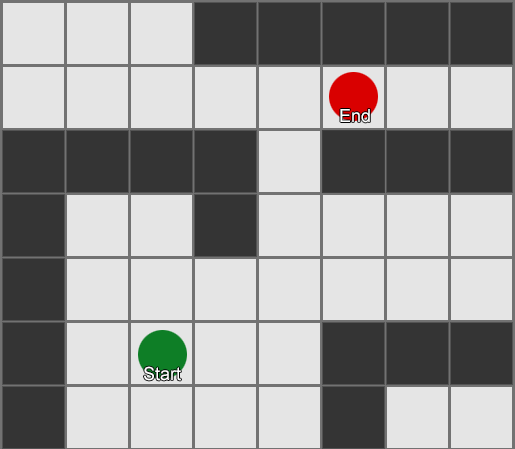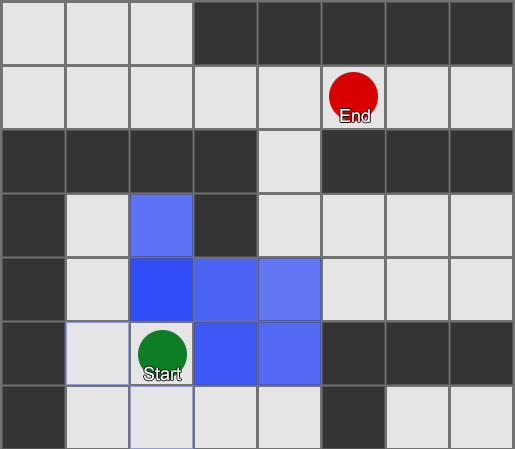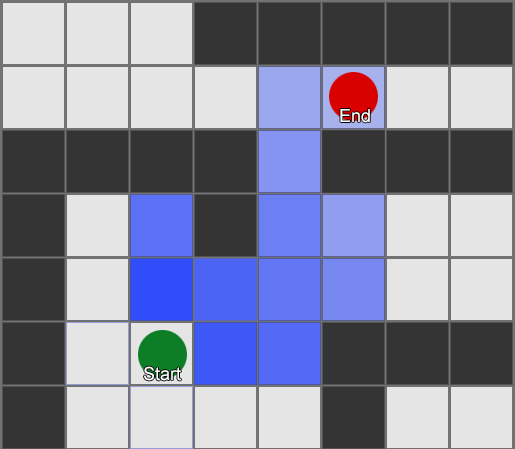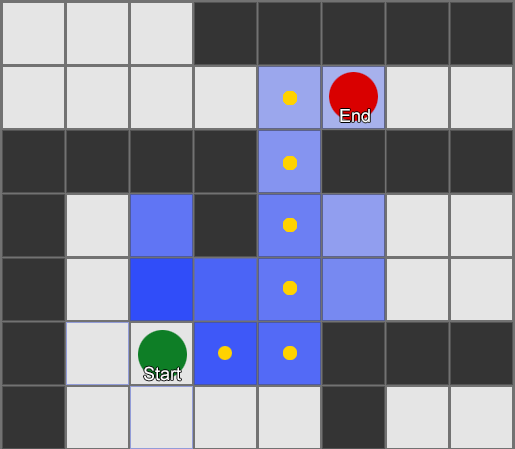
I det här exemplet visar vi hur agenten undersöker ett avsnitt i taget, varje gång väljer det det mest lovande grannfältet. Den resulterande vägen är densamma som vid BFS, men under processen har färre avsnitt övervägts - vilket är av stor betydelse för spelprestanda.
Rörelse utan rutnät
Men de flesta spel är inte uppbyggda på ett rutnät, och ofta går det inte att skapa ett utan att kompromissa med verklighetstrogenhet. Det krävs kompromisser. Vilka storlekar bör avsnitten ha? För stora - och de kan inte korrekt representera smala korridorer eller svängar, för små - det kommer att vara för många avsnitt att söka igenom, vilket kan ta mycket tid.
Det första att förstå är att ett rutnät ger oss en graf av sammankopplade noder. A* och BFS-algoritmer fungerar faktiskt på grafer och bryr sig överhuvudtaget inte om vårt rutnät. Vi skulle kunna placera noder var som helst i spelvärlden: om det finns en förbindelse mellan två sammankopplade noder, såväl som mellan start- och slutpunkt och minst en av noderna - algoritmen kommer att fungera lika bra som tidigare. Detta kallas ofta en waypoint-system, eftersom varje nod representerar en betydelsefull position i världen, vilket kan vara en del av ett antal hypotetiska vägar.
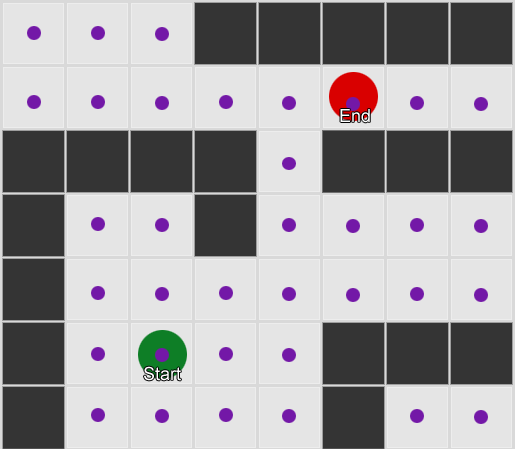
Exempel 1: en nod i varje avsnitt. Sökningen börjar från noden där agenten befinner sig och slutar i noden för det avsnitt som behövs.
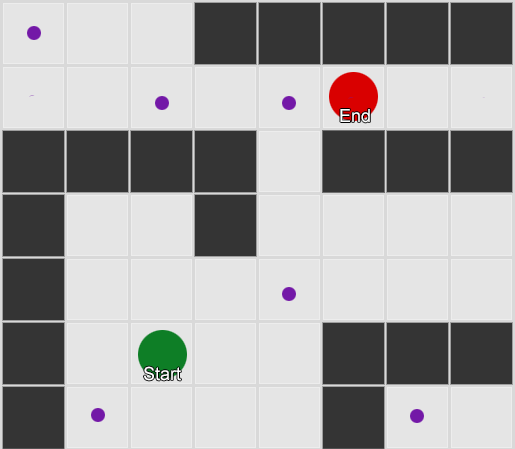
Exempel 2: en mindre uppsättning noder (waypoints). Sökningen börjar i avsnittet med agenten, passerar igenom nödvändiga noder och fortsätter sedan till målet.
Detta är ett ganska flexibelt och kraftfullt system. Men det krävs viss försiktighet när det gäller beslut om var och hur man placerar waypoints, annars kan agenterna helt enkelt missa den närmaste punkten och inte kunna börja sin väg. Det skulle vara enklare om vi kunde automatiskt placera waypoints baserat på världens geometri.
Här kommer navigation mesh eller navmesh (navigationsnät) in. Detta är vanligtvis ett 2D-nät av trianglar som läggs på världens geometri - överallt där agenterna har tillåtelse att gå. Varje triangel i nätet blir en nod i grafen och har upp till tre angränsande trianglar som blir grannnoder i grafen.
Den här bilden är ett exempel från Unity-motorn – den analyserade geometrin i världen och skapade en navmesh (visad i ljusblått på skärmdumpen). Varje polygon i navmesh är ett område där en agent kan stå eller röra sig från en polygon till en annan. I det här exemplet är polygonerna mindre än de våningar där de ligger – detta görs för att ta hänsyn till agentens storlek, som kan sträcka sig utanför dess nominella position.
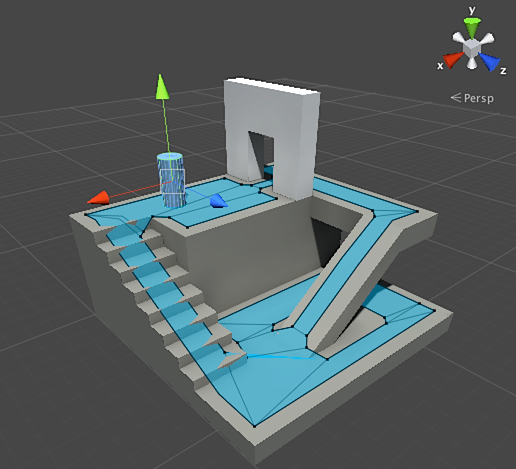
Vi kan söka efter en rutt genom detta nätverk, återigen med hjälp av A*-algoritmen. Detta ger oss en nästan perfekt rutt i världen som tar hänsyn till all geometri och samtidigt inte kräver onödiga noder eller skapande av waypoints.
Pathfinding är ett för stort ämne för att täckas av ett enda avsnitt. Om du vill studera det mer detaljerat kan detta hjälpa dig .
Planering
Vi har bekräftat med pathfinding att det ibland inte räcker med att bara välja en riktning och gå – vi måste välja en rutt och göra några svängar för att nå vårt mål. Vi kan sammanfatta denna idé: att nå ett mål är inte bara nästa steg, utan en hel sekvens där vi ibland måste titta framåt flera steg för att veta hur det första ska vara. Detta kallas planering. Pathfinding kan betraktas som en av flera tillägg till planering. Ur vårt perspektiv av cykeln Sense/Think/Act är detta där Think-planerade delar Act för framtiden.
Låt oss ta ett exempel från kortspelet Magic: The Gathering. Vi spelar först med följande kort i handen:
- Swamp – ger 1 svart mana (landskort).
- Forest – ger 1 grön mana (landskort).
- Fugitive Wizard – kräver 1 blå mana för att åkalla.
- Elvish Mystic – kräver 1 grön mana för att åkalla.
Vi ignorerar de tre återstående korten för enkelhetens skull. Enligt reglerna får spelaren spela ett landkort per tur, de kan "tappa" detta kort för att extrahera mana från det och sedan använda besvärjelser (inklusive åkallande av varelser) baserat på mängden mana. I den här situationen vet den mänskliga spelaren att de behöver spela Forest, "tappa" 1 grön mana och sedan åkalla Elvish Mystic. Men hur ska spelarkompjuter förstå detta?
Enkel planering
Det triviala tillvägagångssättet är att prova varje åtgärd i tur och ordning tills inga lämpliga alternativ återstår. När AI tittar på korten ser det att det kan spela Swamp. Och det spelar det. Finns det några andra åtgärder kvar att göra den här turen? Det kan inte spela varken Elvish Mystic eller Fugitive Wizard, eftersom det krävs grön och blå mana för att spela dem och Swamp ger endast svart mana. Och den kan inte spela Forest eftersom den redan har spelat Swamp. Så spel-IAn har följt reglerna, men gjort det dåligt. Det kan förbättras.
Planering kan hitta en lista över åtgärder som leder spelet till det önskade tillståndet. Precis som varje ruta på vägen hade grannar (i pathfinding) har varje åtgärd i planen också grannar eller efterföljande åtgärder. Vi kan söka efter dessa åtgärder och följande åtgärder tills vi når det önskade tillståndet.
I vårt exempel är det önskade resultatet "åberopa en varelse om möjligt". I början av turen ser vi bara två möjliga åtgärder som är tillåtna enligt spelets regler:
1. Spela Swamp (resultat: Swamp i spelet)
2. Spela Forest (resultat: Forest i spelet)
Varje åtgärd som vidtas kan leda till ytterligare åtgärder och stänga andra, beroende på spelets regler. Tänk dig att vi spelade Swamp — det skulle ta bort Swamp som steg (vi har redan spelat det), det skulle också ta bort Forest (eftersom man får spela en landkort per tur enligt reglerna). Efter detta lägger AI till som nästa steg — att få 1 svart mana, eftersom det inte finns några andra alternativ. Om den går vidare och väljer att aktivera Swamp, får den 1 enhet svart mana och kan ingenting göra med den.
1. Spela Swamp (resultat: Swamp i spelet)
1.1 «Aktivera» Swamp (resultat: Swamp «aktiverad», +1 enhet svart mana)
Inga tillgängliga åtgärder – SLUT
2. Spela Forest (resultat: Forest i spelet)
Listan över åtgärder blev kort, vi har kört fast. Vi upprepar processen för nästa åtgärd. Vi spelar Forest, öppnar åtgärden "få 1 grön mana", vilket i sin tur öppnar den tredje åtgärden — åkalla Elvish Mystic.
1. Spela Swamp (resultat: Swamp i spelet)
1.1 «Aktivera» Swamp (resultat: Swamp «aktiverad», +1 enhet svart mana)
Inga tillgängliga åtgärder – SLUT
2. Spela Forest (resultat: Forest i spelet)
2.1 «Aktivera» Forest (resultat: Forest «aktiverad», +1 enhet grön mana)
2.1.1 Åkalla Elvish Mystic (resultat: Elvish Mystic i spelet, -1 enhet grön mana)
Inga tillgängliga åtgärder – SLUT
Slutligen har vi studerat alla möjliga åtgärder och hittat en plan för att åkalla en varelse.
Detta är ett mycket förenklat exempel. Det är önskvärt att välja den bästa möjliga planen, snarare än någon som uppfyller vissa kriterier. Vanligtvis kan man bedöma potentiella planer baserat på slutresultatet eller den sammanlagda vinsten från att genomföra dem. Man kan ge sig själv 1 poäng för att spela en landkort och 3 poäng för att kalla på en varelse. Att spela Swamp skulle ge 1 poäng. Men att spela Forest → Tappa Forest → kalla på Elvish Mystic — skulle ge totalt 4 poäng.
Så här fungerar planering i Magic: The Gathering, men samma logik kan tillämpas i andra situationer. Till exempel, flytta en bonde för att frigöra utrymme för en löparens drag i schack. Eller gömma sig bakom en vägg för att säkert skjuta i XCOM så. I allmänhet förstår du poängen.
Förbättrad planering
Ibland finns det för många potentiella åtgärder för att överväga varje möjlig variant. Återigen till exemplet med Magic: The Gathering: antag att det i spelet finns flera landkort och varelser i din hand — antalet möjliga dragkombinationer kan uppgå till tiotals. Det finns flera lösningar på problemet.
Det första sättet är backwards chaining (bakåt kedjande). Istället för att gå igenom alla kombinationer, är det bättre att börja med det slutliga resultatet och försöka hitta en direkt väg. Istället för att gå från roten av trädet till ett visst blad, rör vi oss bakåt — från bladet till roten. Denna metod är enklare och snabbare.
Om motståndaren har 1 hälsa, kan man hitta en plan "att orsaka 1 eller fler skador". För att uppnå detta måste en serie villkor uppfyllas:
1. Skadan kan orsakas av en trollformel — den måste vara på handen.
2. För att spela trollformeln — behövs mana.
3. För att få mana — måste man spela ett landkort.
4. För att spela ett landkort — måste man ha det i handen.
Ett annat sätt är best-first search (bästa först sökning). Istället för att gå igenom alla vägar, väljer vi den mest passande. Detta sätt ger oftast en optimal plan utan onödiga sökningar. A* är en typ av bästa första sökning — genom att undersöka de mest lovande vägarna från början kan den redan hitta den bästa vägen utan att behöva kontrollera andra alternativ.
En intressant och alltmer populär variant av best-first search är Monte Carlo Tree Search. Istället för att gissa vilka planer som är bättre än andra vid valet av varje efterföljande åtgärd, väljer algoritmen slumpmässiga efterföljare vid varje steg tills den når slutet (när planen resulterar i vinst eller förlust). Slutresultatet används sedan för att öka eller minska bedömningen av "vikten" av de föregående alternativen. Genom att upprepa denna process flera gånger ger algoritmen en bra uppskattning av vilket nästa steg som är bättre, även om situationen förändras (om motståndaren vidtar åtgärder för att hindra spelaren).
I berättelsen om planering i spel kan vi inte undvika Goal-Oriented Action Planning eller GOAP (målinriktad handlingsplanering). Detta är en mycket använd och diskuterad metod, men förutom några distinkta detaljer är det i grunden en metod för backwards chaining, som vi redan har pratat om. Om uppgiften är att "eliminera spelaren", och spelaren gömmer sig, kan planen vara: kasta granat → ta fram den → kasta.
Det finns vanligtvis flera mål, var och en med sin egen prioritet. Om målet med högst prioritet inte kan uppfyllas (ingen kombination av åtgärder skapar planen "eliminera spelaren" eftersom spelaren inte är synlig), kommer AI:n att återgå till mål med lägre prioritet.
Inlärning och anpassning
Vi har redan nämnt att spel-AI vanligtvis inte använder maskininlärning, eftersom det inte passar för att styra agenter i realtid. Men det betyder inte att man inte kan låna något från detta område. Vi vill ha en motståndare i en shooter som vi kan lära oss något av. Till exempel, att få veta om de bästa positionerna på kartan. Eller en motståndare i en fighting som skulle blockera ofta använda komboattacker, vilket motiverar spelaren att använda andra. Så maskininlärning kan vara mycket användbart i sådana situationer.
Statistik och sannolikheter
Innan vi går vidare till mer komplexa exempel, låt oss överväga hur långt vi kan gå genom att ta några enkla mätningar och använda dem för beslutsfattande. Till exempel, strategin i realtid – hur kan vi bestämma om en spelare kan starta en attack inom de första minuterna av spelet och vilken försvar som ska förberedas mot detta? Vi kan studera spelarens tidigare erfarenheter för att förstå vilken potentiell reaktion som kan komma i framtiden. Låt oss börja med att vi inte har någon sådant utgångsmaterial, men vi kan samla det – varje gång AI spelar mot en människa kan den registrera tiden för den första attacken. Efter några sessioner kommer vi att få ett genomsnittligt värde för hur lång tid det tar innan spelaren attackerar i framtiden.
Det finns också ett problem med medelvärden: om en spelare har "rushat" 20 gånger och spelat långsamt 20 gånger, så kommer de nödvändiga värdena att ligga någonstans i mitten, vilket inte ger oss något användbart. En lösning är att begränsa ingångsdata – man kan överväga de senaste 20 styckena.
En liknande metod används för att bedöma sannolikheten för vissa handlingar, som antar att spelarens tidigare preferenser kommer att vara desamma i framtiden. Om en spelare attackerar oss fem gånger med en eldboll, två gånger med blixt och en gång i närstrid, är det uppenbart att han föredrar eldboll. Låt oss extrapolera och se sannolikheten för användning av olika vapen: eldboll=62,5%, blixt=25% och närstrid=12,5%. Vår spel-AI behöver förbereda sig på att skydda sig mot eld.
En annan intressant metod är att använda Naive Bayes Classifier (naiv bayesisk klassificerare) för att studera stora mängder ingångsdata och klassificera situationen så att AI reagerar på rätt sätt. Bayesianska klassificerare är mest kända för sin användning i skräppostfilter för e-post. Där undersöker de ord, jämför dem med var dessa ord tidigare förekommit (i skräppost eller inte), och drar slutsatser om inkommande e-post. Vi kan göra samma sak även med mindre ingångsdata. Baserat på all användbar information som AI ser (till exempel vilka fiendens enheter som skapades, eller vilka besvärjelser de använder, eller vilka teknologier de forskar på), och det slutliga resultatet (krig eller fred, "rush" eller försvara, osv.) – väljer vi det beteende som AI ska ha.
Alla dessa sätt att lära sig är tillräckliga, men det är att föredra att använda dem baserat på data från tester. AI kommer att lära sig att anpassa sig till olika strategier som dina playtestare har använt. AI som anpassar sig efter spelaren efter släppet kan bli förutsägbar eller å sin sida för svår att besegra.
Anpassning baserat på värden
Med tanke på innehållet i vår spelvärld och regler kan vi ändra uppsättningen värden som påverkar beslutsfattandet, istället för att bara använda indata. Vi gör så här:
- Låt AI samla in data om världens tillstånd och nyckelhändelser under spelets gång (som angivet ovan).
- Vi ändrar några viktiga värden baserat på dessa data.
- Vi genomför våra beslut baserat på bearbetningen eller utvärderingen av dessa värden.
Till exempel, agenten har flera rum att välja på i en förstapersonsskjutare-karta. Varje rum har ett värde som avgör hur önskvärt det är att besöka. AI väljer slumpmässigt vilket rum den ska gå till, baserat på värdet. Därefter minns agenten vilket rum han blev dödad i och minskar dess värde (sannolikheten att han går dit igen). Detsamma gäller för den omvända situationen - om agenten förstör många motståndare ökar värdet på rummet.
Markovmodell
Vad om vi använder de insamlade data för att förutsäga? Om vi kommer ihåg varje rum där vi ser spelaren under en viss tidsperiod, kan vi förutsäga vilket rum spelaren kan gå till. Genom att spåra och registrera spelarens rörelser mellan rummen (värden) kan vi göra prognoser.
Låt oss ta tre rum: röd, grön och blå. Och även observationerna som vi har registrerat under visningen av spelsessionen:
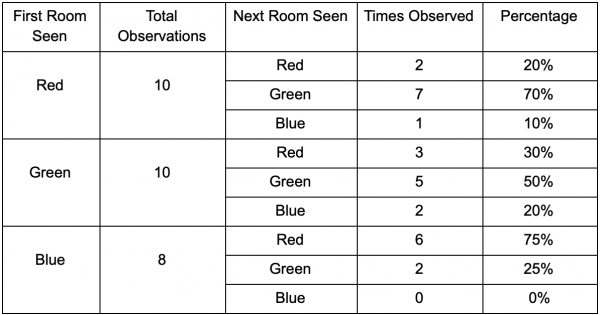
Antalet observationer av varje rum är nästan lika — var vi ska göra en bra plats för en överraskning vet vi fortfarande inte. Insamling av statistik försvåras också av respawn av spelare som dyker upp jämnt över hela kartan. Men data om nästa rum som de går in i efter att ha dykt upp på kartan är redan användbar.
Det är tydligt att det gröna rummet tilltalar spelarna – de flesta från det röda går över dit, och 50 % av dem stannar kvar där. Det blå rummet däremot är inte populärt, nästan ingen går dit, och om de gör det, stannar de inte länge.
Men uppgifterna säger oss något mer viktigt – när spelaren befinner sig i det blå rummet, är nästa rum där vi troligen kommer att se dem det röda, inte det gröna. Trots att det gröna rummet är populärare än det röda, förändras situationen om spelaren befinner sig i det blå. Det nästa tillståndet (alltså rummet som spelaren kommer att gå till) beror på det föregående tillståndet (det rum där spelaren befinner sig just nu). Genom att studera beroenden kommer vi att göra förutsägelser som är mer exakta än om vi bara räknade observationer oberoende av varandra.
Att förutsäga framtida tillstånd baserat på data från tidigare tillstånd kallas en Markov-modell, och sådana exempel (med rum) kallas Markovkedjor. Eftersom modellerna representerar sannolikheten för förändringar mellan konsekutiva tillstånd, visas de visuellt i form av FSM med sannolikhet för varje övergång. Tidigare använde vi FSM för att representera det beteendemässiga tillståndet hos agenten, men detta koncept sträcker sig till vilket tillstånd som helst, oavsett om det är kopplat till agenten eller inte. I detta fall representerar tillstånden rummet som agenten befinner sig i:
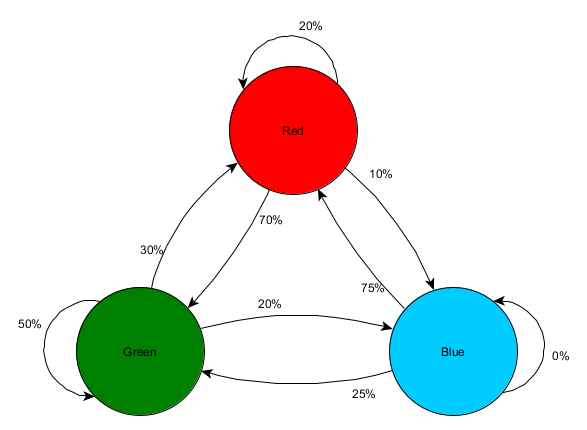
Detta är en enkel form av att representera relativ sannolikhet för förändringar av tillstånd, vilket ger AI en viss möjlighet att förutsäga nästa tillstånd. Flera steg framåt kan förutsägas.
Om spelaren är i det gröna rummet finns det 50 % chans att de stannar kvar där vid nästa observation. Men vad är sannolikheten att de fortfarande kommer att vara där även efteråt? Det finns inte bara en chans att spelaren stannade i det gröna rummet efter två observationer, utan också en chans att de lämnat och kommit tillbaka. Här är en ny tabell med hänsyn till de nya uppgifterna:
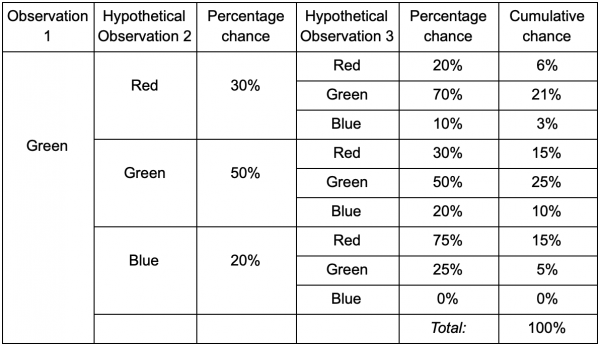
Av den framgår det att chansen att se spelaren i det gröna rummet efter två observationer kommer att vara 51 % – 21 % att de kommer från det röda rummet, 5 % av dem att spelaren besöker det blå rummet mellan dem, och 25 % att spelaren överhuvudtaget inte lämnar det gröna rummet.
Tabellen är ett enkelt visuellt verktyg – proceduren kräver endast att man multiplicerar sannolikheter vid varje steg. Det innebär att du kan se långt in i framtiden med ett förbehåll: vi förutsätter att chansen att komma in i ett rum helt beror på det aktuella rummet. Detta kallas Markov-egenskapen (Markov Property) – framtida tillstånd beror endast på nuvarande. Men detta är inte hundraprocentigt exakt. Spelare kan ändra beslut baserat på andra faktorer: hälsonivå eller mängd ammunition. Eftersom vi inte fastställer dessa värden kommer våra prognoser att vara mindre exakta.
N-Grams
Och vad sägs om exemplet med fightingspel och förutsägelse av spelarens kombinationer? Detsamma! Men istället för ett tillstånd eller en händelse kommer vi att undersöka hela sekvenser som kombinationsslaget består av.
Ett sätt att göra detta är att spara varje input (t.ex. Kick, Punch eller Block) i en buffer och registrera hela bufferten som en händelse. Så spelaren trycker flera gånger på Kick, Kick, Punch för att använda attacken SuperDeathFist, AI-systemet sparar alla inputs i bufferten och kommer ihåg de senaste tre som används vid varje steg.
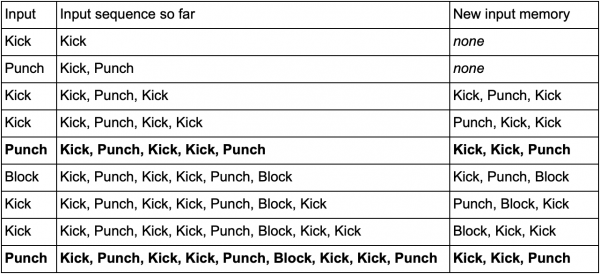
(Fetmarkerade rader indikerar när spelaren startar attacken SuperDeathFist.)
AI:n kommer att se alla alternativ när spelaren valde Kick, följt av en annan Kick, och därefter märk att nästa input alltid är Punch. Detta gör att agenten kan förutsäga kombinationen SuperDeathFist och blockera den om möjligt.
Dessa sekvenser av händelser kallas N-gram (N-grams), där N är antalet lagrade element. I det tidigare exemplet var det en 3-gram (trigram), vilket betyder att de första två inspelningarna används för att förutsäga den tredje. På samma sätt i en 5-gram förutsäger de första fyra inspelningarna den femte och så vidare.
Utvecklaren måste noggrant välja storleken på N-gram. Ett mindre antal N kräver mindre minne, men lagrar också en kortare historia. Till exempel, en 2-gram (bigram) kommer att registrera Kick, Kick eller Kick, Punch, men kan inte lagra Kick, Kick, Punch, så AI:n kommer inte att reagera på kombinationen SuperDeathFist.
Å andra sidan kräver större siffror mer minne och det blir svårare för AI:n att lära sig eftersom det kommer att finnas många fler möjliga alternativ. Om du hade tre möjliga inputs Kick, Punch eller Block, och vi använde en 10-gram, skulle det ge cirka 60 000 olika alternativ.
Bigrammodellen är en enkel Markovkedja - varje par "tidigare tillstånd/nuvarande tillstånd" är ett bigram, och du kan förutsäga det andra tillståndet baserat på det första. Trigram och större N-gram kan också betraktas som Markovkedjor, där alla element (förutom den sista i N-grammet) tillsammans bildar det första tillståndet, medan det sista elementet är det andra. Ett exempel med fighting visar övergångschanser från tillståndet Kick och Kick till tillståndet Kick och Punch. Genom att betrakta flera poster i ingångshistoriken som en enhet omvandlar vi i praktiken ingångssekvensen till en del av ett helt tillstånd. Detta ger oss Markovegenskapen, vilket gör det möjligt att använda Markovkedjor för att förutsäga nästa ingång och gissa vilken kombo-move som kommer att följas.
Slutsats
Vi har diskuterat de vanligaste verktygen och metoderna inom utveckling av artificiell intelligens. Vi har också gått igenom situationer där de ska tillämpas och där de är särskilt användbara.
Detta bör vara tillräckligt för att förstå de grundläggande aspekterna av spel-AI. Men självklart är detta långt ifrån alla metoder. Bland de mindre populära, men lika effektiva, finns:
- optimeringsalgoritmer, inklusive hill climbing, gradientnedstigning och genetiska algoritmer
- konkurrerande sök-/planeringsalgoritmer (minimax och alpha-beta pruning)
- klassificeringsmetoder (perceptron, neurala nätverk och stödvektormaskiner)
- system för att bearbeta perception och minne hos agenter
- arkitektoniska angreppssätt för AI (hybrida system, delmängd av arkitekturer och andra sätt att överlagra AI-system)
- animationsverktyg (planering och samordning av rörelse)
- prestandafaktorer (detaljnivå, anytime-algoritmer, och tidsdelning)
Internetresurser om ämnet:
1. På GameDev.net finns det , samt .
2. innehåller många presentationer och artiklar om ett brett spektrum av relaterade ämnen inom utveckling av spel-AI.
3. inkluderar ämnen från GDC AI-summit, många av vilka är tillgängliga gratis.
4. Användbara material kan också hittas på webbplatsen .
5. Tommy Thompson, AI-forskare och spelutvecklare, gör videor på YouTube-kanalen med förklaringar och hypoteser kring AI i kommersiella spel.
Böcker om ämnet:
1. Serien av böckerna Game AI Pro är samlingar av korta artiklar som förklarar hur man implementerar specifika funktioner eller hur man löser specifika problem.
2. Serien AI Game Programming Wisdom är föregångaren till serien Game AI Pro. Den innehåller äldre metoder, men nästan alla är fortfarande relevanta idag.
3. — det är en av de grundläggande texterna för alla som vill förstå det allmänna området för artificiell intelligens. Denna bok handlar inte om spelutveckling — den lär ut de grundläggande principerna för AI.
Källa: habr.com
