

Artikeln från Stitch Fix-teamet föreslår att använda en klinisk forskningsmetod med liknande effektivitet (non-inferiority trials) i marknadsförings- och produkt-A/B-tester. Denna metod är verkligen tillämplig när vi testar en ny lösning som har fördelar som inte mäts av testerna.
Det enklaste exemplet är minskning av kostnader. Till exempel automatiserar vi processen för att boka den första lektionen, men vill inte att den totala konversionen ska sjunka kraftigt. Eller vi testar förändringar som riktar sig till en specifik användarsegment, samtidigt som vi ser till att konversionerna för andra segment inte sjunker för mycket (när vi testar flera hypoteser, glömmer vi inte justeringar).
Valet av rätt gräns för icke-inferioritet tillför ytterligare svårigheter i testdesignfasen. Frågan om hur man väljer Δ behandlas inte särskilt bra i artikeln. Det verkar som om detta val inte är helt transparent och inom kliniska prövningar. Medicinska publikationer om non-inferiority rapporterar att bara i hälften av publikationerna motiveras valet av gräns, och ofta är dessa motiveringar tvetydiga eller otillräckligt detaljerade.
Hur som helst verkar denna metod intressant, eftersom den kan öka hastigheten på testningen genom att minska den nödvändiga urvalsstorleken, och därmed även hastigheten på beslutsfattande. Darya Mukhina, produktanalytiker för mobilapplikationen Skyeng.
Teamet på Stitch Fix gillar att testa olika saker. Hela teknikgemenskapen gillar i princip att göra tester. Vilken version av webbplatsen attraherar fler användare – A eller B? Genererar version A av rekommendationsmodellen mer intäkter än version B? Nästan alltid använder vi den enklaste metoden från grundkursen i statistik för att kontrollera hypoteser:
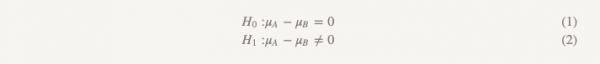
Även om vi sällan använder denna term kallas denna form av testning "hypotesprövning om överlägsenhet". Vid denna metod antar vi att det inte finns någon skillnad mellan de två alternativen. Vi håller fast vid denna idé och överger den endast om de erhållna uppgifterna är tillräckligt övertygande för detta – det vill säga visar att ett av alternativen (A eller B) är bättre än det andra.
Hypotesprövning av överlägsenhet är lämplig för att lösa många problem. Vi släpper version B av den rekommenderande modellen endast om den uppenbart är bättre än den befintliga versionen A. Men i vissa fall fungerar denna metod inte så bra. Låt oss granska några exempel.
1) Vi använder en tredje parts tjänst, som hjälper till att identifiera falska kreditkort. Vi har hittat en annan tjänst som kostar betydligt mindre. Om den billigare tjänsten fungerar lika bra som den vi använder nu, kommer vi att välja den. Den behöver inte nödvändigtvis vara bättre än den tjänst vi använder.
2) Vi vill avlägsna datakällan A och ersätta den med datakällan B. Vi skulle kunna skjuta upp avvecklingen av A om B ger mycket dåliga resultat, men det är inte möjligt att fortsätta använda A.
3) Vi skulle vilja gå från modelleringsteorinA till teori B, inte för att vi förväntar oss bättre resultat från B, utan för att det ger oss större operationell flexibilitet. Vi har inga skäl att tro att B kommer att vara sämre, men vi skulle inte göra övergången om det är fallet.
4) Vi har gjort flera kvalitativa ändringar i webbdesignen (version B) och anser att denna version överträffar version A. Vi förväntar oss inga förändringar i konversioner eller några nyckelprestandaindikatorer som vi vanligtvis bedömer webbplatsen mot. Men vi anser att det finns fördelar i parametrar som antingen är omätbara eller där vår teknik inte är tillräcklig för att mäta.
I alla dessa fall är forskning om överlägsenhet inte den mest lämpliga lösningen. Men de flesta specialister använder den som standard i sådana situationer. Vi genomför noggranna experiment för att korrekt fastställa effektens storlek. Om det skulle vara sant att versionerna A och B fungerar på mycket liknande sätt, är det troligt att vi inte kan förkasta nollhypotesen. Drar vi slutsatsen att A och B i allmänhet fungerar lika? Nej! Oförmågan att förkasta nollhypotesen och acceptansen av nollhypotesen är inte detsamma.
Beräkningar av urvalsvolym (som ni förstås har genomfört) görs som regel med strängare gränser för typ I-fel (sannolikheten för ett felaktigt avvisande av nollhypotesen, ofta kallad alfa) än för typ II-fel (sannolikheten för att inte avvisa nollhypotesen, förutsatt att nollhypotesen är felaktig, ofta kallad beta). Ett typiskt värde för alfa är 0,05, medan det typiska värdet för beta är 0,20, vilket motsvarar en statistisk kraft på 0,80. Det innebär att vi kan missa den verkliga effekten av storleken vi angav i våra kraftberäkningar med en sannolikhet på 20 %, vilket är ett betydande informationsgap. Låt oss som exempel betrakta följande hypoteser:
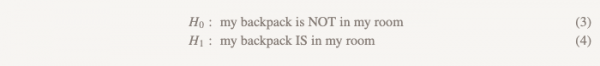
H0: min ryggsäck är INTE i mitt rum (3)
H1: min ryggsäck är i mitt rum (4)
Om jag har genomsökt mitt rum och hittar min ryggsäck — utmärkt, jag kan avvisa nollhypotesen. Men om jag har sett mig omkring i rummet och inte kunnat hitta min ryggsäck (figur 1), vilken slutsats bör jag dra? Är jag säker på att den inte är där? Har jag letat noggrant nog? Vad om jag bara har genomsökt 80 % av rummet? Att dra slutsatsen att ryggsäcken verkligen inte finns i rummet skulle vara ett förhastat beslut. Det är förståeligt att vi inte kan "acceptera nollhypotesen."
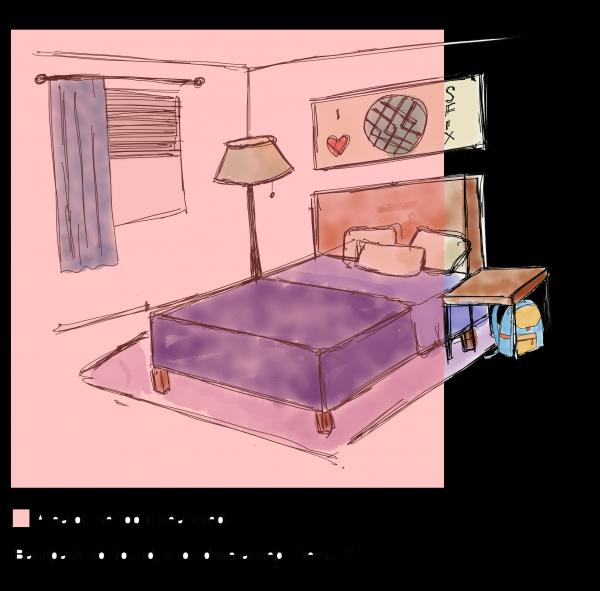
Området vi har genomsökt
Vi hittade ingen ryggsäck — bör vi acceptera nollhypotesen?
Figur 1. Att genomsöka 80 % av rummet är ungefär som att genomföra en studie med en kraft på 80 %. Om du inte hittade ryggsäcken efter att ha genomsökt 80 % av rummet, kan man då dra slutsatsen att den inte är där?
Vad bör då en datorspecialist göra i denna situation? Du kan avsevärt öka kraften i studien, men då behöver du en mycket större urvalsstorlek, och resultatet kommer fortfarande att vara otillfredsställande.
Lyckligtvis har sådana problem studerats länge inom klinisk forskning. Läkemedel B är billigare än läkemedel A; läkemedel B förväntas orsaka färre biverkningar än läkemedel A; läkemedel B är lättare att transportera eftersom det inte behöver förvaras i kylskåp, medan läkemedel A måste det. Låt oss kontrollera hypotesen om icke sämre effektivitet. Detta behövs för att visa att version B är lika bra som version A - åtminstone inom en viss förbestämd gräns för
Hypoteser om icke sämre effektivitet vänder på allt:
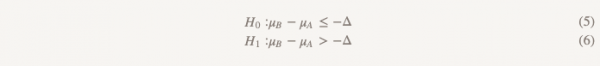
Nu, istället för att anta att det inte finns någon skillnad, antar vi att version B är sämre än version A, och vi kommer att hålla fast vid denna hypotes tills vi bevisar motsatsen. Det är precis vid detta tillfälle som det är meningsfullt att använda ett ensidigt hypotesprövning! I praktiken kan detta göras genom att bygga ett förtroendeintervall och avgöra om intervallet verkligen är större än (figur 2).
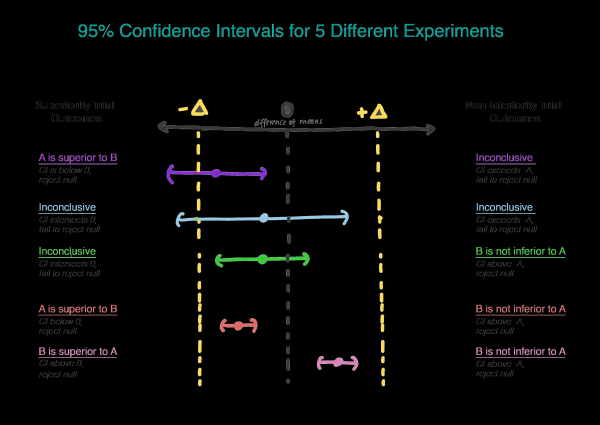
Val av
Hur väljer man på rätt sätt? Processen för att välja innehåller statistisk motivering och ämnesbedömning. Inom klinisk forskning finns det normativ vägledning som anger att delta bör representera den minsta kliniskt betydelsefulla skillnaden - en skillnad som har relevans i praktiken. Här är ett citat från den europeiska vägledningen som kan hjälpa dig att verifiera det: "Om skillnaden har valts korrekt, är ett förtroendeintervall som helt ligger mellan - och 0 ..., fortfarande tillräckligt för att visa icke sämre effektivitet. Om detta resultat inte verkar acceptabelt betyder det att inte har valts på rätt sätt."
Delta bör definitivt inte överskrida effekten av version A i förhållande till den sanna kontrollen (placebo / ingen behandling), eftersom det leder till att version B är sämre än den sanna kontrollen, samtidigt som den visar "inte mindre effektivitet". Anta att när version A introducerades, så fanns det ingen version 0 eller ingen funktion överhuvudtaget (se figur 3).
Enligt resultaten från hypotesprövningen av överlägsenhet har effekten E identifierats (dvs antagligen μ^A−μ^0=E). Nu är A vår nya standard, och vi vill säkerställa att B inte är sämre än A. Ett annat sätt att skriva μB−μA≤−Δ (nollhypotesen) är μB≤μA−Δ. Om vi antar att detta är lika med eller större än E, så är μB ≤ μA−E ≤ placebo. Nu ser vi att vår uppskattning för μB helt överskrider μA−E, vilket helt motbeviser nollhypotesen och tillåter oss att dra slutsatsen att B inte är sämre än A, men samtidigt kan μB vara ≤ μ placebo, vilket inte är vad vi vill ha. (figur 3).
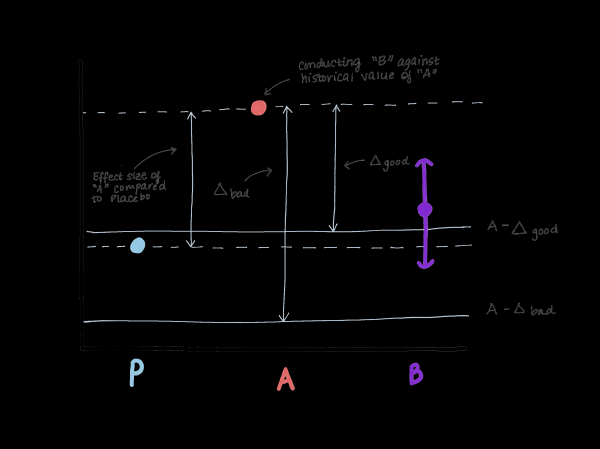
Figur 3. Demonstration av riskerna med att välja gränsen för inte mindre effektivitet. Om gränsen är för stor kan man dra slutsatsen att B inte är sämre än A, men samtidigt inte åtskiljbar från placebo. Vi skulle inte byta ut ett läkemedel som uppenbart är mer effektivt än placebo (A) mot ett läkemedel som har samma effektivitet som placebo.
Val av α
Låt oss gå vidare till valet av α. Det kan vara bra att använda det standardvärde α = 0,05, men det är inte helt rättvist. Som när du köper något online och använder flera rabattkoder på en gång, även om de inte ska kombineras – det var bara en bugg från utvecklarens sida, och det gick bra för dig. Enligt reglerna bör värdet av α vara hälften av det värde av α som används vid prövning av hypotesen om överlägsenhet, dvs 0,05 / 2 = 0,025.
Urvalsstorlek
Hur beräknar man urvalsstorleken? Om du tror att den sanna skillnaden i medelvärden mellan A och B är 0, då beräkningen av urvalsstorleken kommer att vara densamma som vid prövning av hypotesen om överlägsenhet, med undantag för att du ersätter effektstorleken med gränsen för inte mindre effektivitet, förutsatt att du använder αinte mindre effektivitet = 1/2αöverlägsenhet (αnon-inferiority=1/2αsuperiority). Om du har anledning att tro att alternativ B kan vara något sämre än alternativ A, men du vill bevisa att det inte är sämre än Δ, så har du tur! Faktum är att detta minskar storleken på ditt urval, eftersom det är lättare att visa att B är sämre än A om du faktiskt tycker att det är något sämre, snarare än likvärdigt.
Exempel med beslut
Anta att du vill övergå till version B under förutsättning att den är sämre än version A med högst 0,1 poäng på en femgradig skala för kundnöjdhet... Låt oss närma oss denna uppgift genom att använda hypotesen om överlägsenhet.
För att testa hypotesen om överlägsenhet skulle vi beräkna urvalsstorleken på följande sätt:
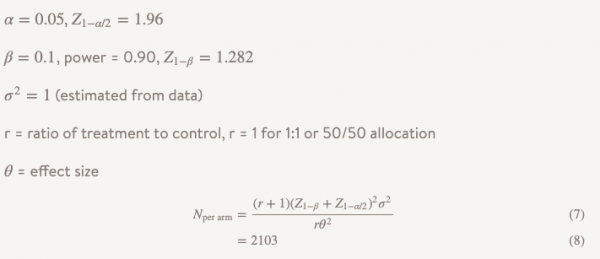
Det vill säga, om du har 2103 observationer i din grupp kan du vara 90 % säker på att du upptäcker en effekt av 0,10 eller mer. Men om 0,10 är för stort för dig, kanske det inte är värt att testa hypotesen om överlägsenhet. Kanske beslutar du att för tillförlitlighet utföra en studie för en mindre effektsstorlek, till exempel 0,05. I så fall behöver du 8407 observationer, vilket innebär att urvalet ökar nästan 4 gånger. Men vad händer om vi håller oss till vår ursprungliga urvalsstorlek men ökar styrkan till 0,99, så att vi inte tvivlar om vi får ett positivt resultat? I så fall blir n för en grupp 3676, vilket är bättre, men ökar urvalsstorleken med mer än 50 %. Och till slut kan vi fortfarande inte motbevisa nollhypotesen, utan att få svar på vår fråga.
Vad om vi istället testar hypotesen om icke-mindre effektivitet?
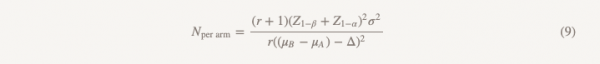
Urvalsstorleken kommer att beräknas med samma formel med undantag för nämnaren.
Skillnaderna från formeln som används för att testa hypotesen om överlägsenhet är följande:
— Z1−α/2 ersätts med Z1−α, men om du gör allt enligt reglerna byter du α = 0,05 till α = 0,025, det vill säga, det är samma nummer (1,96)
— i nämnaren infogas (μB−μA)
— θ (effektstorlek) ersätts med Δ (gränsen för icke-mindre effektivitet)
Om vi antar att µB = µA, så blir (µB − µA) = 0 och beräkningen av urvalsstorleken för gränsen av minst likvärdig effektivitet är precis vad vi skulle få om vi beräknade överlägsenheten för effektstorleken 0,1, utmärkt! Vi kan genomföra en studie av samma storlek med olika hypoteser och en annan metod för slutsatser, och vi kommer att få svaret på frågan som vi verkligen vill besvara.
Nu antar vi att vi faktiskt inte anser att µB = µA och
tänker att µB är lite sämre, kanske med 0,01 enheter. Detta ökar vår nämnare, vilket minskar urvalsstorleken till gruppen till 1737.
Vad händer om version B faktiskt är bättre än version A? Vi förkastar nollhypotesen att B är sämre än A med mer än Δ och accepterar den alternativa hypotesen att B, om det är sämre, inte är sämre än Δ, och kan vara bättre. Försök att inkludera denna slutsats i en tvärfunktionell presentation och se vad som händer (verkligen, försök). I en situation där man måste navigera framtiden, vill ingen gå med på "inte sämre än Δ och kanske bättre".
I så fall kan vi genomföra en studie som kort och gott kallas "hypotestestning av att ett av alternativen överträffar det andra eller är underlägset det". Den använder två uppsättningar hypoteser:
Den första uppsättningen (samma som vid hypotestestning om likvärdig effektivitet):
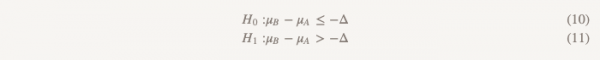
Den andra uppsättningen (samma som vid hypotestestning om överlägsenhet):
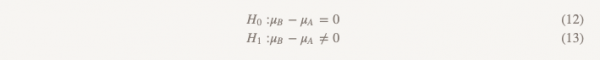
Vi testar den andra hypotesen endast om den första förkastas. Vid sekventiell testning behåller vi den totala typen I-felrat (α). I praktiken kan detta uppnås genom att skapa ett 95 % konfidensintervall för skillnaden mellan medelvärdena och kontrollera att hela intervallet överstiger -Δ. Om intervallet inte överstiger -Δ kan vi inte förkasta nollhypotesen och slutar där. Om hela intervallet verkligen överstiger −Δ fortsätter vi och ser om intervallet innehåller 0.
Det finns en annan typ av studier som vi inte har diskuterat – ekvivalensstudier.
Den här typen av studier kan ersättas av studier för att testa hypotesen om att den inte är mindre effektiv och vice versa, men det finns en viktig skillnad mellan dem. En studie för att testa hypotesen om att den inte är mindre effektiv syftar till att visa att variant B åtminstone är lika bra som A. En ekvivalensstudie syftar till att visa att variant B åtminstone är lika bra som A, och att variant A är lika bra som B, vilket är mer komplext. I grund och botten försöker vi bestämma om hela konfidensintervallet för skillnaden mellan medelvärdena ligger mellan −Δ och Δ. Sådana studier kräver större urvalsstorlekar och genomförs mer sällan. Så nästa gång du genomför en studie där ditt huvudsakliga mål är att säkerställa att den nya versionen inte är sämre, acceptera inte att "inte kunna motbevisa nollhypotesen". Om du vill testa en verkligen viktig hypotes, överväg olika alternativ.
Källa: habr.com
