

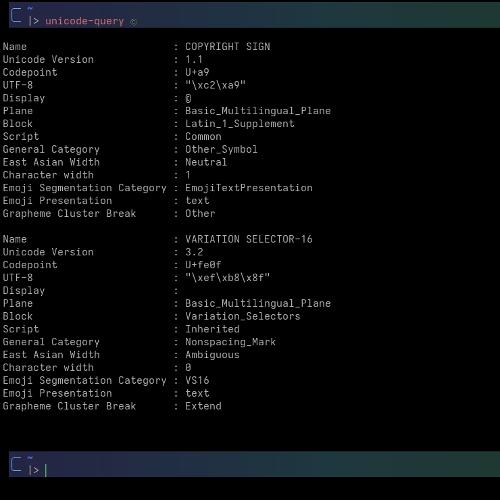
Version 0.9.0 av biblioteket för C++ (standard C++20) har släppts libunicode. Projektet utvecklas av ett team av utvecklare för terminalemulatorn Contour and the shell Endo (i aktiv utveckling), och distribueras under Apache 2.0-licensen.
Möjligheterna hos biblioteket:
- stöd för standarder Unicode 17.0:
- API för att hämta Unicode-egenskaper;
- SIMD-optimering av vissa funktioner (med användning av std::simd eller std::experimental::simd om de finns);
- optimerad konvertering mellan UTF-8 <-> UTF-16/UTF-32;
- motsvarar funktionen wcwidth (int unicode::width(char32_t));
- segmentering av text efter grafemer, tecken, emojis och skriftsystem;
- formatering och jämförelse av strängar;
- högnivå API för textsegmentering, lämplig för implementation av textformatering.
- testning av de flesta funktionerna i biblioteket (teckenbredd och segmentering).
Det levereras även med kommandoradsverktyget unicode-query för att hämta detaljerad information om strängar.
Ändringar:
- API för grapheme_cluster_width har lagts till;
- förbättringar i hanteringen av Unicode-versioner ("Age");
- fullt stöd UAX #15 Unicode Normalization Forms med stöd för strömmande behandling:
normalizer norm(Normalization_Form::NFC); // Mata in dekomponerat e + kombinerande akut, sedan en ny startare för att trigga emission auto result = norm.feed(U’e’); CHECK(result.empty()); // fortfarande buffring result = norm.feed(U’u0301′); CHECK(result.empty()); // fortfarande buffring (kombinerande mark) result = norm.feed(U’x’); // startare triggar emission av föregående segment REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + akut komponerat till e-akut result = norm.flush(); CHECK(result == U"x"); // slutsegment
- funktionen script_extensions returnerar nu std::optional<std::span<Script const>>;
- regeln GB9c för segmentering av grafemgrupper för teckenkombinationer på språk i den indiska gruppen har implementerats;
- i grapheme_segmenter har reglerna för GB11 och GB4/GB5 rättats; föråldrad API har tagits bort;
- SIMD-optimerad konvertering från UTF-8 till UTF-16/UTF-32 har implementerats;
- bredden på sammansatta Hangul-tecken V/T är nu noll;
- segmentering efter ordgränser har implementerats;
- fixar i C API;
- omstrukturering av byggsystemet och hjälpgeneratorn för tabeller i C++;
- komplexa tester av konvertering från UTF-16/UTF-32 har lagts till;
- en statisk byggnadsverktyg för unicode-query har lagts till i CI.
Källa: linux.org.ru
