

Nyligen släpptes , som visar trenden inom maskininlärning under de senaste åren. Kort sagt: antalet startups inom maskininlärning har minskat kraftigt de senaste två åren.
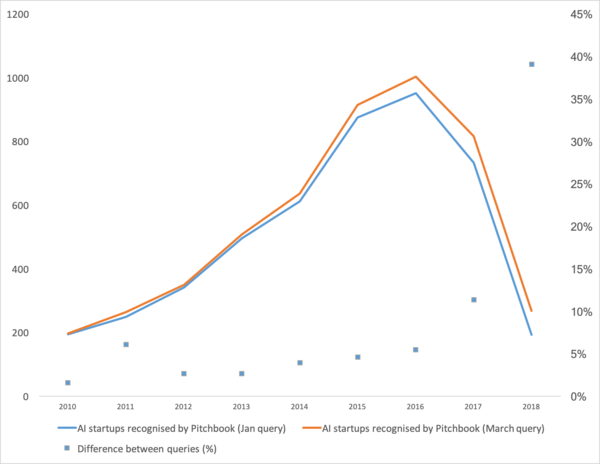
Nåväl. Låt oss ta reda på om "bubblan sprack", "hur man lever vidare" och diskutera hur denna situation överhuvudtaget uppstod.
Först pratar vi om vad som var en drivkraft bakom denna kurva. Var kom den ifrån? Antagligen kommer alla ihåg inom maskininlärning 2012 vid tävlingen ImageNet. Trots att detta var ett första globalt evenemang! Men i verkligheten var det inte så. Och tillväxtkurvan börjar faktiskt något tidigare. Jag skulle dela upp den i flera punkter.
- Året 2008 var då termen “stora data” dök upp. Riktiga produkter började från och med 2010. Stora data är direkt kopplade till maskininlärning. Utan stora data är det omöjligt att algoritmerna fungerar stabilt, som fanns vid den tidpunkten. Och det handlar inte om neurala nätverk. Fram till 2012 var neurala nätverk något som bara en marginaliserad minoritet sysslade med. Men då började helt andra algoritmer, som redan hade funnits i åratal, om inte decennier, att fungera: (1963, 1993) (1995), (2003),… Startups från dessa år handlade först och främst om automatisk behandling av strukturerade data: kassor, användare, reklam, mycket mer.
En avledning av denna första våg är uppsättningar av ramverk, såsom XGBoost, CatBoost, LightGBM, etc.
- Under 2011-2012 vann flera tävlingar inom bildigenkänning. Deras verkliga användning drog dock ut på tiden. Jag skulle säga att massiva, genomtänkta startups och lösningar började dyka upp från 2014. Det tog två år att bearbeta att neurala nätverk faktiskt fungerar, att skapa användarvänliga ramverk som kunde installeras och köras på rimlig tid samt att utveckla metoder för att stabilisera och snabba upp konvergensen.
Konvolutionella nätverk tillåter att lösa uppgifter inom maskinsyn: klassificering av bilder och objekt på bilder, detektering av objekt, igenkänning av objekt och människor, bildförbättring, med mera.
- 2015-2017. En boom av algoritmer och projekt kopplade till rekurrenta nätverk eller deras motsvarigheter (LSTM, GRU, TransformerNet etc.). Det dök upp effektiva algoritmer för "tal-till-text" och maskinöversättning. Delvis baseras de på konvolutionsnätverk för att extrahera grundläggande funktioner. Delvis på att vi har lärt oss att samla verkligt stora och bra datamängder.
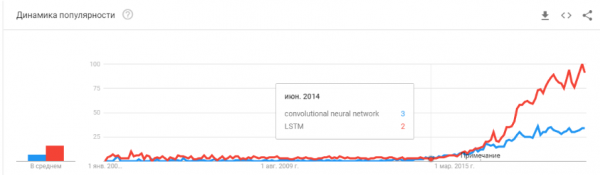
"Har bubblan spruckit? Är hypen överhettad? Har de dött som blockchain?"
Det kan hända! Imorgon slutar Siri att fungera på din telefon, och dagen efter kan Tesla inte skilja en sväng från en känguru.
Neurala nätverk är redan i bruk. De finns i tiotals enheter. De möjliggör faktiskt intäktsgenerering, förändrar marknaden och omvärlden. Hypen ser lite annorlunda ut:
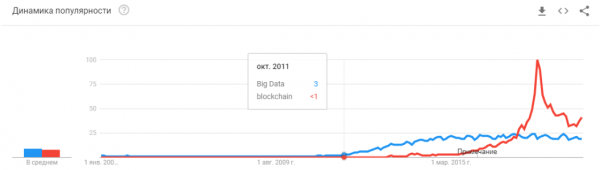
Neurala nätverk har helt enkelt slutat vara något nytt. Ja, många människor har en överdriven förväntan. Men ett stort antal företag har lärt sig att tillämpa neurala nätverk och skapa produkter baserade på dem. Neurala nätverk ger ny funktionalitet, tillåter att minska arbetskraft och sänka tjänstekostnader:
- Tillverkningsföretag integrerar algoritmer för att analysera defekter på produktionslinjen.
- Lantbrukare köper system för att övervaka kor.
- Automatiska skördemaskiner.
- Automatiserade callcenter.
- Filter i SnapChat. (något konkret i alla fall!)
Men det viktigaste, och inte det mest uppenbara: "Det finns inga nya idéer längre, eller de kommer inte att ge omedelbar avkastning". Neurala nätverk har löst tiotals problem. Och de kommer att lösa ännu fler. Alla uppenbara idéer som fanns har genererat många startups. Men allt som var uppenbart är redan samlat. Under de senaste två åren har jag inte stött på någon ny idé för tillämpning av neurala nätverk. Ingen ny metod (någorlunda, det finns lite krångel med GAN).
Och varje nästa startup blir allt svårare. Den kräver inte längre bara två killar som tränar ett neuralt nätverk med öppna data. Den kräver programmerare, servrar, ett team av annotatörer, komplex support, och så vidare.
Som resultat blir det färre startups. Men produktionen ökar. Behöver du implementera registreringsskännare? Det finns hundratals experter på marknaden med relevant erfarenhet. Du kan anställa och på ett par månader så kan din anställda utveckla systemet. Eller köpa ett färdigt. Men att starta en ny startup?.. Det är galet!
Det är nödvändigt att göra ett system för att spåra besökare — varför betala för en mängd licenser när man kan skapa sitt eget på 3-4 månader, skräddarsytt för sin verksamhet.
Just nu genomgår neurala nätverk samma väg som många andra teknologier har gjort.
Kommer ni ihåg hur begreppet "webbutvecklare" har förändrats sedan 1995? Marknaden hade inte ännu blivit mättad med specialister. Det finns mycket få professionella. Men jag kan nästan garantera att om 5-10 år kommer det inte vara någon stor skillnad mellan en Java-programmerare och en utvecklare av neurala nätverk. Båda typerna av specialister kommer att finnas i tillräckliga mängder på marknaden.
Det kommer helt enkelt att finnas en typ av uppgifter som ska lösas av neurala nätverk. När en uppgift uppstår — anställer man en specialist.
"Och vad händer sedan? Var är den utlovade artificiella intelligensen?"
Och här finns det en liten, men intressant oklarhet :)
Den tekniska stack som finns idag, verkar inte leda oss till artificiell intelligens. Idéerna, deras nyhet — har delvis uttömt sig. Låt oss prata om vad som håller den aktuella utvecklingsnivån tillbaka.
Begränsningar
Vi börjar med självkörande bilar. Det verkar som om det är tydligt att helt autonoma fordon kan skapas med dagens teknologi — men hur många år kommer det att ta innan det händer — är oklart. Tesla anser att det kommer att ske om ett par år —
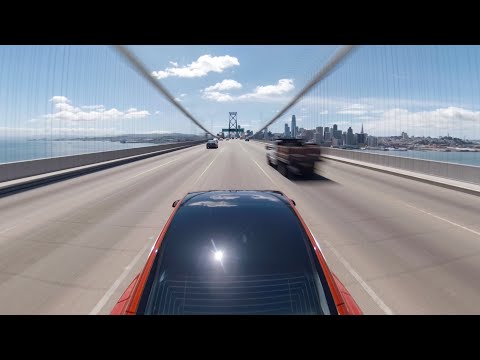
Det finns många andra , som uppskattar det till 5-10 år.
Sannolikt, enligt min åsikt, kommer städerna om cirka 15 år att förändras så mycket att företeelsen av autonoma fordon blir oundviklig, blir en fortsättning av infrastrukturen. Men det kan ju inte räknas som intelligens. Moderna Tesla är en mycket komplex konveyor av databehandling, datainsamling och omträning. Det är regler-regler-regler, insamling av data och filter på dem (här har jag skrivit mer om detta, eller titta med markeringen).
Det första problemet
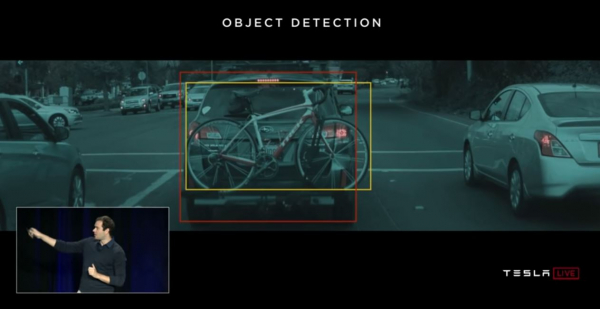
Och just här ser vi det första grundläggande problemet. Stora data. Det är precis detta som har gett upphov till den nuvarande vågen av neurala nätverk och maskininlärning. Nu, för att göra något komplext och automatiserat, behövs det mycket data. Inte bara mycket, utan extremt mycket. Automatiserade algoritmer för insamling, märkning och användning är nödvändiga. Om vi vill att maskinen ska se lastbilar mot solen — måste vi först samla tillräckligt många exemplar. Om vi vill att maskinen inte ska bli förvirrad av en cykel som är fäst vid bagageutrymmet — behövs ännu fler prover.
För ett exempel räcker det inte. Hundratals? Tusentals?
Det andra problemet
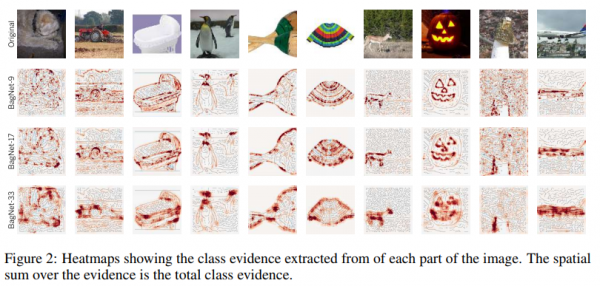
Det andra problemet — visualiseringen av vad vårt neurala nätverk har förstått. Det är en väldigt oöverskådlig uppgift. Ändå är det få som riktigt förstår hur man visualiserar detta. Dessa artiklar är ganska aktuella, och här är bara några exempel, om än avlägsna:
koncentration på texturer. Visar tydligt vad neurala nätverket tenderar att fokusera på + vad det uppfattar som grundläggande information.
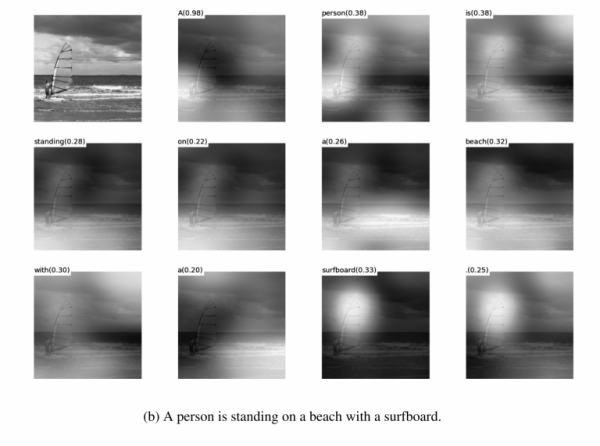
uppmärksamhet vid . Faktiskt kan uppmärksamhet ofta användas just för att visa vad som har orsakat nätverkets reaktion. Jag har stött på sådana saker både för debugging och för produktlösningar. Det finns många artiklar om detta ämne. Men ju mer komplexa data blir, desto svårare blir det att förstå hur man uppnår en stabil visualisering.
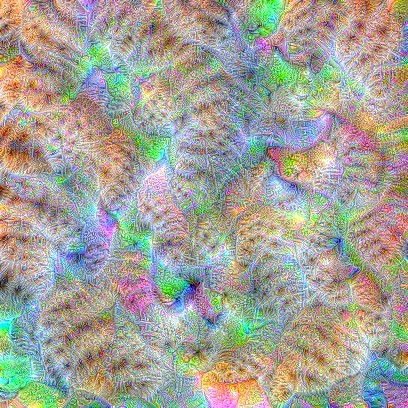
Och ja, den gamla hederliga samlingen av "titta på vad som finns inne i nätverket i ". Dessa bilder var populära för 3-4 år sedan, men alla insåg snabbt att bilderna var vackra, men inte särskilt meningsfulla.
Jag har inte nämnt dussintals andra knep, metoder, hacks och studier om hur man visualiserar nätverkets inre arbete. Fungerar dessa verktyg? Hjälper de en att snabbt förstå vad problemet är och debugga nätverket?.. Få ut de sista procenten? Ja, ungefär så här:
Du kan titta på vilken tävling som helst på Kaggle. Och beskrivningen av hur människor skapar sina slutliga lösningar. Vi staplade 100-500-800 miljoner modeller och det fungerade!
Jag överdriver naturligtvis. Men dessa metoder ger ingen snabb eller direkt lösning.
Med tillräcklig erfarenhet kan man, genom att pröva olika alternativ, åstadkomma en bedömning av varför ditt system gjorde det valet. Men att ändra systemets beteende blir svårt. Man kan sätta dit en lösning, justera tröskeln, lägga till en datasats, använda ett annat backend-nätverk.
Det tredje problemet
Det tredje grundläggande problemet — nätverk lär sig inte logik, utan statistik. Statistiskt sett är detta :
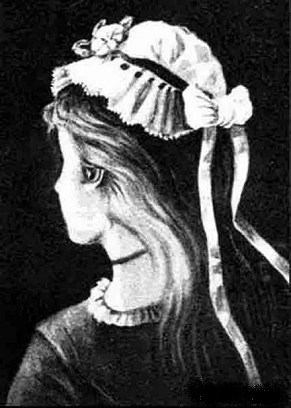
Logiskt sett ser det inte så likt ut. Neurala nätverk lär sig inte något komplext om de inte tvingas. De lär sig alltid maximalt enkla kännetecken. Finns det ögon, näsa, huvud? Då är det ett ansikte! Annars ge ett exempel där ögon inte skulle innebära ansikte. Och igen — miljoner exempel.
Det finns gott om plats längst ner
Jag skulle säga att det är just dessa tre globala problem som idag begränsar utvecklingen av neurala nätverk och maskininlärning. Och där dessa problem inte begränsade, används det redan aktivt.
Är det slutet? Har neurala nätverk stannat?
Det är oklart. Men självklart hoppas alla att det inte är så.
Det finns många metoder och riktningar för att lösa de grundläggande problem som jag nämnde ovan. Men hittills har ingen av dessa metoder lett till något fundamentalt nytt, löst något som ännu inte har lösts. Hittills görs alla grundläggande projekt på grundval av stabila metoder (Tesla), eller förblir testprojekt hos institutioner eller företag (Google Brain, OpenAI).
Om man talar grovt, så är det huvudsakliga riktningen — skapandet av en viss högre representation av ingångsdata. På något sätt en 'minne'. Det enklaste exemplet på minne är olika 'Embedding' — representationer av bilder. Till exempel, alla ansiktsigenkänningssystem. Nätverket lär sig att få en viss stabil representation av ett ansikte som inte påverkas av vridningar, belysning, upplösning. I grund och botten minimerar nätverket metrik 'olika ansikten — långt bort' och 'lika — nära'.
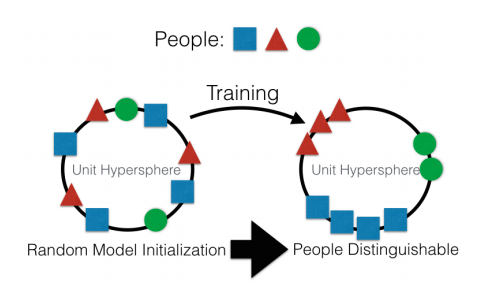
För sådan inlärning behövs tiotusentals och hundratusentals exempel. Men resultatet bär vissa frön av 'One-shot Learning'. Nu behöver vi inte hundratals ansikten för att komma ihåg en person. Bara ett ansikte, och allt — vi !
Men här finns ett problem... Nätverket kan bara lära sig tillräckligt enkla objekt. Vid försök att särskilja inte ansikten, utan till exempel 'personer efter kläder' (uppgift ) — faller kvaliteten flera ordningar. Och nätverket kan redan inte lära sig tillräckligt uppenbara förändringar av vinklar.
Och att lära sig på miljoner exempel — är också lite av en underhållning.
Det finns arbeten om betydande minskningar av urval. Till exempel kan man omedelbart minnas ett av de första arbetena om OneShot Learning :
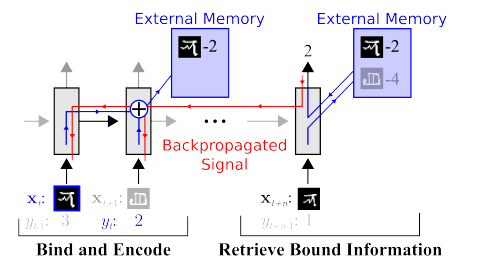
Det finns många sådana arbeten, till exempel eller eller .
En nackdel är att träning vanligtvis fungerar bra på enklare exempel, såsom ”MNIST”-exempel. Men när man går över till mer komplexa uppgifter behövs en stor databas, en modell av objekt eller någon sorts magi.
Arbete med One-Shot inlärning är överlag en mycket intressant ämne. Man hittar många idéer. Men i stor utsträckning hindrar de två problem som jag nämnde (förträning på en enorm dataset / instabilitet på komplexa data) lärande.
Å andra sidan passar GAN – generativa adversariella nätverk – in på ämnet Embedding. Ni har säkert läst massor av artiklar om detta på Habré., ,)
En särskiljande egenskap hos GAN är skapandet av ett visst inre tillståndsområde (i praktiken samma som Embedding), vilket gör att man kan rita en bild. Det kan vara , det kan vara .
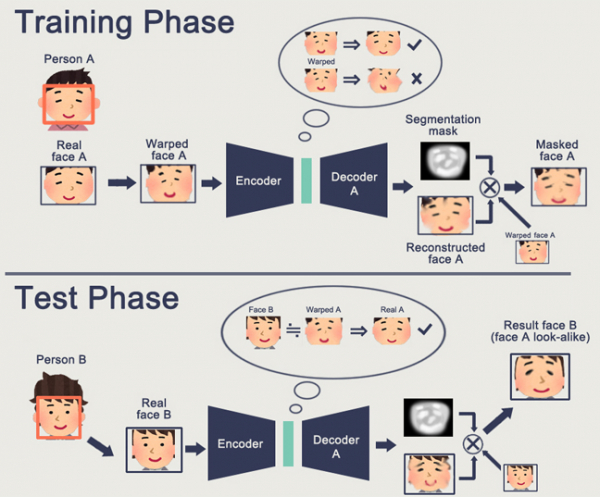
Problemet med GAN är att ju mer komplex det genererade objektet är, desto svårare är det att beskriva det i logiken "generator-diskriminator". Som resultat av detta är de enda verkliga tillämpningarna av GAN som är kända - DeepFake, vilket återigen manipulerar med representationer av ansikten (för vilka det finns en stor databas).
Jag har stött på mycket få andra nyttiga tillämpningar. Vanligtvis handlar det om små trick med att rita över bilder.
Och igen. Ingen har någon förståelse för hur detta kommer att låta oss gå mot en ljus framtid. Representationen av logik/rum i ett neuralt nätverk – är bra. Men det krävs ett enormt antal exempel, vi förstår inte hur neuronnätet representerar detta, vi förstår inte hur vi får neuronnätet att minnas en verkligt komplex representation.
Reinforcement learning är en helt annan infallsvinkel. Ni minns säkert hur Google slog alla i Go. Nyligen segrar i Starcraft och Dota. Men här är allt långt ifrån så rosenrött och lovande. Bäst av allt förklarar .
om man sammanfattar kort vad författaren skrev:
- Modeller av standardtyp passar inte / fungerar dåligt i de flesta fall.
- Praktiska problem kan enklare lösas på andra sätt. Boston Dynamics använder inte RL på grund av dess komplexitet/ovisshet/beräkningssvårigheter.
- För att RL ska fungera behövs en komplex funktion. Ofta är det svårt att skapa/skriva den.
- Det är svårt att träna modeller. Man måste spendera massor av tid för att få dem att fungera och ta dem ur lokala optima.
- Som en följd av detta är det svårt att upprepa modellen, modellen är ostabil vid minsta förändringar.
- Den tenderar ofta att överanpassa sig till slumpmässiga mönster, till och med till en slumptalsgenerator.
En avgörande punkt är att RL ännu inte fungerar i produktion. Google har vissa experiment ( , ). Men jag har inte sett något produktionssystem.
Minne. Nackdelen med allt ovanstående är ostruktureringen. Ett av de sätt som man försöker hantera detta på är att ge det neurala nätverket tillgång till separat minne. Så att det kan skriva och skriva över resultaten av sina steg. Då kan det neurala nätverket definieras av det aktuella tillståndet i minnet. Detta liknar mycket klassiska processorer och datorer.
Den mest kända och populära — från DeepMind:
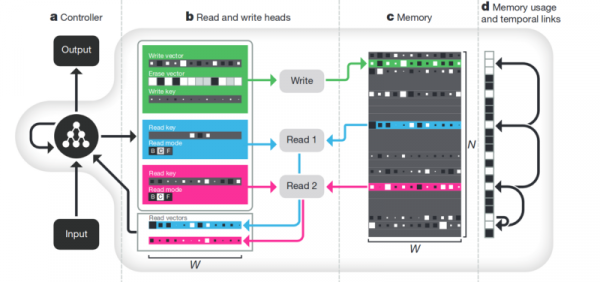
Det verkar som om detta är nyckeln till förståelse av intelligens? Men troligen inte. Systemet behöver fortfarande en enorm mängd data för träning. Och det fungerar mestadels med strukturerad tabellbaserad data. När Facebook ett liknande problem valde de att "skita i minnet, vi gör bara nätverket mer komplext, och fler exempel — så kommer det att lära sig självt".
Disentanglement. Ett annat sätt att skapa betydande minne är att ta samma inbäddningar, men vid träning införa ytterligare kriterier som skulle möjliggöra att särskilja "meningar" i dem. Till exempel vill vi träna det neurala nätverket att särskilja människors beteende i affären. Om vi hade följt den standardvägen skulle vi behöva skapa ett dussin nätverk. Ett som letar efter en person, ett annat som bestämmer vad den gör, ett tredje som bedömer åldern, ett fjärde för kön. Separat logik ser på den del av affären där personen befinner sig / tränas på detta. Det tredje avgör deras väg, och så vidare.
Eller, om det skulle finnas oändligt med data, skulle man kunna träna ett nätverk på alla möjliga utfall (uppenbarligen går det inte att samla en sådan datamängd).
Disentanglement-tilvägagångssättet säger oss att vi ska träna nätverket så att det kan särskilja begrepp. Att det genom video ska kunna skapa inbäddningar där ett område definierar en handling, ett annat - positionen på golvet i tid, ett annat - personens längd, och ett fjärde - dess kön. Vid träningen skulle man helst vilja knappt ge nätverket några ledtrådar för sådana nyckelbegrepp, utan låta det själv identifiera och gruppera områden. Det finns ganska få artiklar om detta (några av dem , , ) och generellt sett är de ganska teoretiska.
Men detta riktning, åtminstone teoretiskt, borde kunna lösa de problem som nämndes i början.
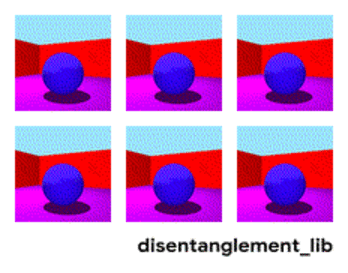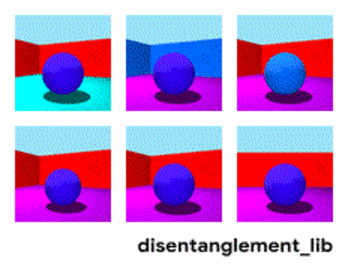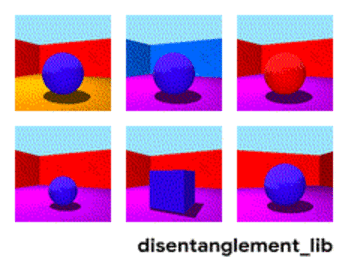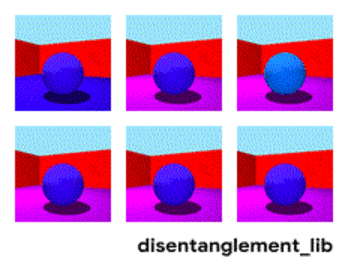
Nedbrytning av bilden efter parametrarna "väggfärg/gulvfärg/objektform/objektfärg/osv."
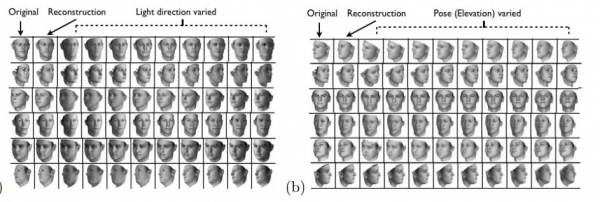
Nedbrytning av ansiktet efter parametrarna "storlek, ögonbryn, orientering, hudfärg, osv."
Övrigt
Det finns många andra, inte så globala, riktningar som på något sätt möjliggör att minska databaser, arbeta med mer heterogena data, osv.
Attention. Det kanske inte är meningsfullt att lyfta fram detta som en separat metod. Bara en metod som förstärker andra. Många artiklar är tillägnade det (,,). Poängen med Attention är att förstärka nätverkets reaktion på betydelsefulla objekt under träning. Ofta genom något extern mål eller en liten extern nätverk.
3D-simulering. Om man kan skapa en bra 3D-motor kan man ofta täcka in 90 % av träningsdata (jag har till och med sett exempel där nästan 99 % av data täcktes av en bra motor). Det finns många idéer och hacks för att få nätverket som tränats på 3D-motorn att fungera med verkliga data (Fine tuning, style transfer, osv.). Men ofta är det att skapa en bra motor - flera ordningar mer komplicerat än att samla in data. Exempel på när motorer skapades:
Träning av robotar (, )
Utbildning produkter i butiken (men i de två projekten vi genomförde - klarade vi oss utan detta).
Träning på Tesla (återigen videon som visades tidigare).
Slutsatser
Hela artikeln är på något sätt slutsatser. Kanske är det huvudbudskapet jag ville framföra - "snart slut, neuronnät ger inte längre enkla lösningar". Nu måste vi arbeta hårt för att bygga komplexa lösningar. Eller arbeta hårt med att göra komplex vetenskaplig forskning.
Överhuvudtaget är detta en diskussionspunkt. Kanske har läsarna mer intressanta exempel?
Källa: habr.com
