

Mozilla utvecklar verktyget för taligenkänning Whisperfile, vilket inkluderar en oberoende högpresterande implementering av maskininlärningsmodellen Whisper, utvecklad och öppen av organisationen OpenAI. Verktyget är byggt på whisper.cpp, en implementering av Whisper-modellen i C/C++, skapad av Georgi Gerganov (skaparen av llama.cpp). Koden är skriven i C++ och distribueras under MIT-licensen.
Whisperfile utvecklas av Mozilla Ocho-teamet och kompletterar projektet llamafile, som är avsett för att skapa universella körbara filer för körning av stora språkmodeller inom maskininlärning (LLM). På liknande sätt som llamafile möjliggör projektet whisperfile att generera en körbar fil baserat på en konfigurationsfil för maskininlärningsmodellen i GGUF-format, som kan köras på olika operativsystem på AMD64 och ARM64-hårdvara. Den kompilerade koden kan länkas med standard C-biblioteket Cosmopolitan, vilket möjliggör skapande av applikationsbyggnader som kan köras på Linux, FreeBSD, macOS, OpenBSD, NetBSD och Windows.
När den körbara filen startas, skickas en ljudfil i wav-, mp3-, ogg- eller flac-format som inparameter, och den igenkännda texten sparas på utdata. I praktiken kan projektet användas för att lösa uppgifter som att generera textundertexter för video, skapa loggar över röst- och videoklipp, omvandla inspelat röstmaterial till text och organisera röstinmatning. Med hjälp av Whisperfile kan sådana uppgifter lösas på det lokala systemet utan att behöva kontakta externa tjänster.
Dessutom stödjer den att fungera som en HTTP-server som hanterar förfrågningar om taligenkänning via Web API. För att snabba upp arbetet med modellen kan GPU:er och AVX-instruktioner användas. Verktyget kan också ge ut sannolikhetskoefficienter som gör det möjligt att markera igenkända ord baserat på noggrannheten i deras identifiering.
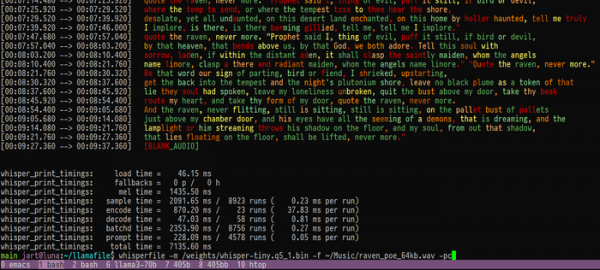
Den använda modellen Whisper har tränats på 680 000 timmar av taldata som täcker olika ämnesområden och språk (2/3 av datan är på engelska). Modellen hanterar väl tal med accent, känner igen teknisk jargong, stödjer automatisk språkigenkänning och kan fungera med bakgrundsljud. För engelskt tal visar systemet en pålitlighet och noggrannhet i automatisk taligenkänning som är nära mänsklig igenkänning. Utöver transkribering av tal till text kan modellen även användas för att översätta tal till ett annat språk.
Källa: opennet.ru
