

Moderna informationssystem är ganska komplexa. Inte minst beror deras komplexitet på den komplexitet av de data som behandlas i dem. Denna datakomplexitet beror ofta på mångfalden av de datamodeller som används. Till exempel, när data blir "stora", anses en av de besvärliga egenskaperna för dem inte bara vara deras volym, utan också deras variation.
Om du för närvarande inte hittar något fel i resonemangen, fortsätt att läsa.
Innehåll
Polyglot persistence
Det som sagts ovan leder till att det ibland inom även ett enda system är nödvändigt att använda flera olika databashanteringssystem för datalagring och behandling av olika uppgifter, var och en av dem stödjer sin egen datamodell. På rekommendation av M. Fowler, ett antal kända böcker och en av Agile Manifesto, fick denna situation namnet polyglot persistence. Fowler ger också följande exempel på datalagring i en fullt funktionsduglig och högbelastad applikation inom e-handel.
Detta exempel är givetvis något överdrivet, men det finns ändå vissa överväganden för att välja ett eller annat databashanteringssystem för ett visst syfte, exempelvis,
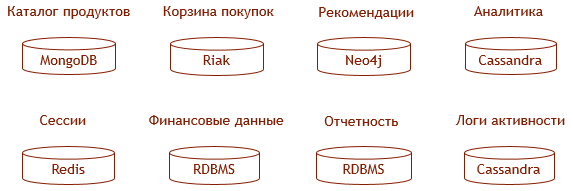
Det är uppenbart att det inte är lätt att vara en förvaltare i en sådan djurpark. .
Mängden kod som utför datalagring växer proportionellt med antalet använda databashanteringssystem; mängden kod som synkroniserar data växer, om än inte proportionellt med kvadraten av detta antal.
- Kostnaderna för att säkerställa företagsfunktioner (skalanvändbarhet, redundans, hög tillgänglighet) ökar med antalet använda databashanteringssystem.
- Det är omöjligt att säkerställa företagsfunktioner för lagringssystemet som helhet – särskilt transaktionalitet.
- Ur djurparkens direktörs perspektiv ser allt ut som följande:
Kraftig ökning av kostnaderna för licenser och support från databashanteringssystemets tillverkare.
- Ökad kostnad för licenser och stöd från databashanterarens tillverkare.
- Expansion of staff and increased timelines.
- Direct financial losses or penalties due to data inconsistency.
There is a significant increase in the total cost of ownership of the system (TCO). Is there any way out of the 'multi-model storage' situation?
Multimodellighet
The term 'multi-model storage' came into use in 2011. It took several years to recognize the problems with the approach and find a solution, and by 2015 analysts at Gartner formulated the answer:
- From '»:
The future of DBMS, their architectures, and usage methods — multi-modality.
- From '»:
Leading operational DBMS will offer several models — relational and non-relational — as part of a single platform.
It seems that this time the analysts at Gartner were not mistaken in their forecast. If you go to the page with the of DBMS on DB-Engines, you can see that thebästa resultatet (subjektiv åsikt).majority of its leaders position themselves specifically as multi-model DBMS. The same can be seen on the page with any specific rating.
The table below lists DBMS leaders in each specific rating that claim their multi-modality. For each DBMS, the originally supported model (once the only one) is indicated along with the models currently supported. There are also DBMS that position themselves as 'originally multi-model', stating that they have no initial inherited model according to their creators.
| DBMS | Original Model | Additional Models |
|---|---|---|
| Oracle | Relational | Graph, Document |
| MS SQL | Relational | Graph, Document |
| PostgreSQL | Relational | Graph*, Document |
| MarkLogic | Document | Graph, Relational |
| MongoDB | Document | Key-Value, Graph* |
| DataStax | Wide-Column | Document, Graph |
| Redis | Key-Value | Document, Graph* |
| ArangoDB | — | Graph, Document |
| OrientDB | — | Graph, Document, Relational |
| Azure CosmosDB | — | Graph, Document, Relational |
Notes to the table
Stars in the table denote statements that require clarification:
- The PostgreSQL DBMS does not support graph data model, however, a product , such as AgensGraph, does support it.
- In relation to MongoDB, it is more accurate to speak of the presence of graph operators in the query language (, ), rather than support for the graph model, although, of course, their introduction required certain optimizations at the physical storage level in the direction of supporting the graph model.
- Beträffande Redis syftar detta på en utvidgning .
För varje av klasserna kommer vi att visa hur stöd för flera modeller implementeras i databashanteringssystem (DBMS) av denna klass. Vi kommer att anse att de mest betydelsefulla modellerna är relations-, dokument- och grafmodeller, och vi kommer att visa genom exempel från specifika DBMS hur "de saknade" implementeras.
Multimodella databashanteringssystem baserade på relationsmodellen
De ledande DBMS i dag är för närvarande relationsdatabaser, Gartner-prognosen skulle inte få anses ha infriats om relationsdatabaserna inte visade tecken på rörelse mot multimodularitet. Och de visar det. Nu kan tankar om att multimodala DBMS är som en schweizisk armékniv, där inget kan göras bra, riktas direkt mot Larry Ellison.
Författaren föredrar emellertid implementeringen av multimodularitet i Microsoft SQL Server, på vilket exempel stöd för dokument- och grafmodellerna i relationsdatabaserna kommer att beskrivas.
Dokumentmodellen i MS SQL Server
Om hur dokumentmodellsstödet är implementerat i MS SQL Server har det redan funnits två utmärkta artiklar på Habré, jag ska nöja mig med en kort sammanfattning och kommentar:
Stödet för dokumentmodellen i MS SQL Server är ganska typiskt för relationsdatabaser: JSON-dokument föreslås lagras i vanliga textfält. Stödet för dokumentmodellen består av att tillhandahålla speciella operatorer för att analysera dessa JSON:
- för att extrahera skalära värden av attribut,
- för att extrahera underdokument.
Det andra argumentet för båda operatorerna är ett uttryck i JSONPath-liknande syntax.
Kopplat kan man säga att dokument som lagras på detta sätt inte är "första klassens entiteter" i en relationsdatabas, i motsats till tupler. Specifikt finns det i nuläget inga index över fälten i JSON-dokument i MS SQL Server, vilket gör operationer för att förena tabeller baserat på värden i dessa fält och även urval av dokument baserat på dessa värden problematiska. Det är dock möjligt att skapa en beräknad kolumn baserat på ett sådant fält och ett index för det.
Dessutom erbjuder MS SQL Server möjligheten att enkelt konstruera ett JSON-dokument från innehållet i tabellerna med hjälp av operatorn — möjlighet, på ett sätt motsatt den tidigare, vanliga lagringen. Det är klart att hur snabb RDBMS än må vara, så strider ett sådant tillvägagångssätt mot ideologin hos dokumentdatabaser, som i princip lagrar färdiga svar på populära frågor, och kan endast lösa problem med utvecklingsvänlighet, men inte hastighet.
Slutligen tillåter MS SQL Server att lösa uppgiften som är motsatt dokumentkonstruktion: man kan bryta ner JSON i tabeller med hjälp av . Om dokumentet inte är helt platt, kommer det att kräva användning av CROSS APPLY.
Grafmodellen i MS SQL Server
Stödet för grafmodellen (LPG) realiseras i Microsoft SQL Server också ganska : det föreslås att använda speciella tabeller för att lagra noder och för att lagra grafens kanter. Sådana tabeller skapas med hjälp av uttryck CREATE TABLE AS NODE och CREATE TABLE AS EDGE respektive.
Tabeller av den första typen liknar vanliga tabeller för att lagra poster med den enda yttre skillnaden att tabellen innehåller ett systemfält $node_id — en unik identifierare för grafens nod inom databasen.
På liknande sätt har tabeller av den andra typen systemfält $from_id och $to_id, poster i sådana tabeller anger därmed på ett förståeligt sätt relationer mellan noder. För att lagra relationer av varje typ används en separat tabell.
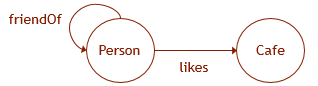 Låt oss illustrera det sagda med ett exempel. Anta att grafdata har en struktur som i den angivna bilden. Då för att skapa den motsvarande strukturen i databasen måste följande DDL-frågor utföras:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Den huvudsakliga speciella funktionen hos sådana tabeller är att grafmönster med Cypher-liknande syntax kan användas i förfrågningar mot dem (dock stöds "*" och så vidare fortfarande inte). Utifrån prestandamätningar kan man också anta att sättet att lagra data i dessa tabeller skiljer sig från mekanismen för datalagring i vanliga tabeller och är optimerat för att utföra sådana graffrågor.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Dessutom är det ganska svårt att arbeta med sådana tabeller utan att använda dessa grafmönster, eftersom vanliga SQL-frågor för att lösa liknande uppgifter kräver ytterligare ansträngningar för att få systemade "graf"-identifierare för noderna ($node_id, $from_id, $to_id; av samma anledning finns det inga indatafrågor här, då de skulle vara för omständliga).
Sammanfattande angående beskrivningen av implementeringen av dokument- och grafmodeller i MS SQL Server, skulle jag vilja påpeka att sådana implementeringar av en modell ovanpå en annan inte verkar lyckade främst ur språklig design. Det krävs att ett språk expanderar ett annat, språken är inte riktigt "ortogonala", sammansättningsreglerna kan vara ganska märkliga.
Multimodella databashanteringssystem baserade på dokumentmodellen
I detta avsnitt vill jag illustrera implementeringen av multimodularitet i dokumentdatabaser med ett exempel på en av de mindre populära av dem, MongoDB (som nämnts, har den endast villkorligt grafiska operatörer $lookup och $graphLookup, som inte fungerar med sharderade kollektioner), utan med ett exempel på en mer mogen och "enterprise"-databas, .
Låt oss säga att kollektionen innehåller en uppsättning XML-dokument av följande slag (MarkLogic tillåter också lagring av JSON-dokument):
John
  Smith
Relationsmodellen i MarkLogic
Ett relationsmässigt representativ av dokumentkollektionen kan skapas med hjälp av (innehållet i elementen value i exemplet nedan kan vara valfri XPath):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
Det skapade representationen kan adresseras av en SQL-fråga (till exempel via ODBC):
SELECT name, surname FROM Person WHERE name="John"Tyvärr är den relationsmässiga representationen som skapats med hjälp av avbildningsmallen endast skrivskyddad. När en förfrågan bearbetas försöker MarkLogic att använda . Tidigare fanns det och begränsade relationsrepresentationer i MarkLogic som helt baserades på index, och tillgängliga för inspelning, men de betraktas nu som deprecated.
Grafmodellen i MarkLogic
Med stöd för grafmodellen (RDF) fungerar det ungefär på samma sätt. Återigen kan man med hjälp av skapa en RDF-representation av dokumentkollektionen från exemplet ovan:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
En SPARQL-fråga kan adresseras till den resulterande RDF-grafen:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Till skillnad från relationsmodellen stödjer MarkLogic grafmodellen på ytterligare två sätt:
- DBMS kan vara ett fullständigt separat lagringssystem för RDF-data (tripplar i det kommer att kallas i motsats till de som beskrivits ovan ).
- RDF i en speciell serialisering kan helt enkelt infogas i XML- eller JSON-dokument (och tripplarna kommer då att kallas ). Troligtvis är detta ett alternativ till mekanismerna
idrefoch så vidare.
En bra bild av hur "det verkligen" fungerar i MarkLogic ges av , i den meningen är det låg nivå, även om syftet snarare är det motsatta – att försöka abstrahera från den använda datamodellen, säkerställa en konsekvent hantering av data i olika modeller, transaktionsprocesser och så vidare.
Multimodella databashanteringssystem "utan en huvudmodell"
Det finns också DBMS på marknaden som positionerar sig som ursprungligen multimodala, utan någon ärvd grundmodell. Några av dem inkluderar , (från och med 2018 ägs av SAP) och (tjänst inom Microsoft Azures molnplattform).
I själva verket finns det "grundläggande" modeller i ArangoDB och OrientDB. I båda fallen är det egna datamodeller som är generaliseringar av dokumentmodellen. Generaliseringarna handlar främst om att underlätta möjligheten att göra graf- och relationsfrågor.
Dessa modeller är de enda som är tillgängliga för användning i de angivna DBMS, och det finns specifika frågespråk avsedda för att arbeta med dem. Självklart är sådana modeller och DBMS lovande, men avsaknaden av kompatibilitet med standardmodeller och språk gör det omöjligt att använda dessa DBMS i ärvda system — att ersätta dem med redan använda DBMS där.
Om ArangoDB och OrientDB har det redan skrivits en fantastisk artikel på Habr: .
ArangoDB
ArangoDB deklarerar stöd för grafdata modellen.
Grafens noder i ArangoDB är vanliga dokument, medan kanterna är dokument av en speciell typ, som har vanliga systemfält som (_key, _id, _rev) systemfält _from och _to. Dokument i dokumentbaserade DBMS grupperas traditionellt i samlingar. Samlingar av dokument som representerar kanter i ArangoDB kallas edge-samlingar. För att nämna något, är dokument i edge-samlingar också dokument, så kanter i ArangoDB kan också fungera som noder.
Ursprungliga data
Låt oss ha en samling persons, vars dokument ser ut så här:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Låt oss också ha en samling cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Då kan samlingen likes se ut så här:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Frågor och resultat
Frågan i grafstil på det språk som används i ArangoDB, som returnerar information om vilket café varje person gillar i ett läsbart format, ser ut så här:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
I relationell stil, när vi snarare "beräknar" relationer än lagrar dem, kan denna fråga skrivas om så här (för att nämna, skulle det kunna göras utan samlingen likes man skulle kunna klara sig utan):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Resultatet i båda fallen blir detsamma:
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Fler frågor och resultat
Om det verkar som att resultatformatet ovan är mer karaktäristiskt för en relationsdatabas än för en dokumentdatabas, kan du prova en sådan fråga (eller du kan använda ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Resultatet kommer att se ut så här:
[
  { "person" : "Alice" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
Grunden för implementeringen av en grafmodell ovanpå dokumentmodellen i OrientDB ligger i dokumentfälten kan ha, förutom mer eller mindre standardiserade skalära värden, även värden av typer som LINK, LINKLIST, LINKSET, LINKMAP och LINKBAG. Värden av dessa typer är referenser eller samlingar av referenser till dokument.
Den systemgenererade dokumentidentifieraren har en "fysisk betydelse", som anger positionen för posten i databasen och ser ungefär ut så här: @rid : #3:16. På så sätt är värdena för referensens egenskaper faktiskt mer som pekare (som i grafmodellen) snarare än urvalsvillkor (som i relationsmodellen).
Som i ArangoDB representeras kanterna i OrientDB som separata dokument (även om en kant utan egna egenskaper kan göras , och det kommer inte att finnas något separat dokument för den).
Ursprungliga data
I ett format som ligger nära för OrientDB skulle data från det tidigare exemplet för ArangoDB se ut ungefär så här:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alice",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Som vi ser, lagrar även noderna information om inkommande och utgående kanter. Vid Document API för referensintegritet måste man följa själv, medan Graph API tar hand om det arbetet. Men låt oss se hur förfrågningar till OrientDB ser ut på "rena", icke-integrerade frågespråk.
Frågor och resultat
Förfrågan, som är analog med exemplet för ArangoDB, ser ut så här i OrientDB:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Resultatet kommer att erhållas i följande format:
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Om resultatformatet återigen verkar alltför "relationsbaserat", bör man ta bort raden med :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Frågespråket för OrientDB kan karaktäriseras som SQL med Gremlin-liknande inslag. I version 2.2 introducerades en Cypher-liknande frågeform. :
MATCH {CLASS: Person, AS: person}-likes-> {CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Resultatformatet kommer att vara detsamma som i den tidigare frågan. Tänk på vad som behöver tas bort för att göra det mer "relationsbaserat", som i den allra första frågan.
Azure CosmosDB
I mindre grad gäller det som ovan om ArangoDB och OrientDB Azure CosmosDB. CosmosDB erbjuder följande API:er för datatillgång: SQL, MongoDB, Gremlin och Cassandra.
SQL API och MongoDB API används för att få tillgång till data i dokumentmodellen. Gremlin API och Cassandra API är för att få tillgång till data i graf- respektive kolonnmodellen. Data i alla modeller lagras i formatet för den interna modellen CosmosDB: ("atom-record-sequence"), som också är nära dokumentmodellen.
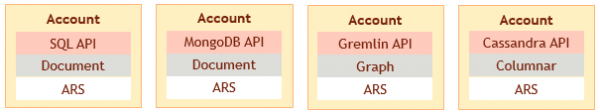
Men den datamodell som användaren väljer och det användargränssnitt som används fastställs vid skapandet av kontot för tjänsten. Det går inte att få tillgång till data som laddades upp i en modell i formatet för en annan modell, vilket skulle illustreras av en bild ungefär som denna:
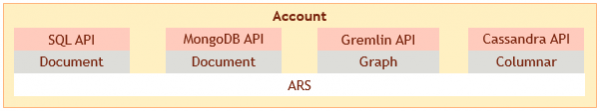
På så sätt är multimodellfunktionsförmågan i Azure CosmosDB för närvarande endast en möjlighet att använda flera databaser som stödjer olika modeller, från en och samma leverantör, vilket inte löser alla problem med varierande lagring.
Multimodella databashanteringssystem baserade på grafmodellen?
Det är anmärkningsvärt att det än så länge inte finns några multimodell-Databashanterare på marknaden som har grafmodellen som grund (om man inte räknar multimodell som stöd för två grafmodeller samtidigt: RDF och LPG; se mer om detta i ). De största svårigheterna uppstår vid implementeringen av den dokumentära modellen ovanpå en grafmodell snarare än en relationsmodell.
Frågan om hur man implementerar en relationsmodell ovanpå en grafmodell har diskuterats sedan relationsmodellens tidiga dagar. Som , sa :
Det finns inget inneboende i grafmetoden som hindrar skapandet av ett lager (t.ex. genom lämplig indexering) på en grafdatabas som möjliggör en relationell vy med (1) återhämtning av tupler från de vanliga nyckel-värde-paren och (2) gruppering av tupler efter relationstyp.
Vid implementeringen av den dokumentära modellen ovanpå grafen måste man ha i åtanke, till exempel, följande:
- JSON-arrayelement anses vara ordnade, vilket inte är fallet för topparna på grafens kanter;
- Data i den dokumentära modellen är vanligtvis denormaliserade; man vill trots allt inte lagra flera kopior av samma inbäddade dokument, och underdokumenten har vanligtvis inga identifierare;
- Å andra sidan handlar ideologin för dokumentdatabaser om att dokumenten är färdiga "aggregat" som inte behöver byggas om från grunden varje gång. Det krävs en möjlighet i grafmodellen att snabbt få fram en undergraf som motsvarar det färdiga dokumentet.
Lite reklam
Författaren av artikeln är involverad i utvecklingen av databasen NitrosBase, vars interna modell är grafisk och externa modeller — relations- och dokumentmodeller — är dess representationer. Alla modeller är likvärdiga: praktiskt taget alla data är tillgängliga i vilken som helst av dem med hjälp av dess naturliga frågespråk. Dessutom kan data ändras i vilken som helst av representationerna. Ändringar återspeglas i den interna modellen och därmed i de andra representationerna.
Hur överensstämmelsen mellan modellerna i NitrosBase ser ut — hoppas jag kunna beskriva i en av de kommande artiklarna.
Slutsats
Jag hoppas att de allmänna konturerna av det som kallas multimodularitet har blivit något klarare för läsaren. Multimodularitet kallas för olika databaser, och "stödet för flera modeller" kan se olika ut. För att förstå vad som menas med "multimodularitet" i varje enskilt fall är det värdefullt att svara på följande frågor:
- Handlar det om stöd för traditionella modeller eller för en viss "hybrid"-modell?
- "Är modellerna likvärdiga, eller är en av dem underställd de andra?
- Är modellerna "likgiltiga" inför varandra? Kan data som skrivits in i en modell läsas av en annan eller till och med skrivas över?
Jag tror att vi nu kan ge ett positivt svar på frågan om relevansen av multimodella DBMS, men det är intressant att fråga sig vilka specifika typer som kommer att vara mest efterfrågade under den närmaste tiden. Det verkar som att multimodella DBMS som stöder traditionella modeller, framför allt relationsmodeller, kommer att vara mer efterfrågade; populariteten hos multimodella DBMS som erbjuder nya modeller, som kombinerar fördelarna med olika traditionella, är en fråga för mer avlägset framtid.
Endast registrerade användare kan delta i omröstningen. , tack.
Använder ni multimodella DBMS?
Vi använder inte det, vi lagrar all data i en och samma DBMS och modell
Vi använder de multimodala möjligheterna hos traditionella DBMS
Vi praktiserar polyglot persistence
Vi använder nya multimodella DBMS (Arango, Orient, CosmosDB)
19 användare röstade. 4 användare avstod.
Källa: habr.com
