

Artikeln består av två delar:
- En kort beskrivning av vissa arkitekturer i nätverk för objektigenkänning på bilder och segmentering av bilder med de mest lättförståeliga länkarna till resurser för mig. Jag försökte välja videoförklaringar, helst på ryska.
- Den andra delen går ut på att förstå utvecklingen av arkitekturerna för neuronnät. Och teknologier baserade på dem.
Bild 1 – Det är inte lätt att förstå arkitekturerna för neuronnät.
Allt började med att jag skapade två demonstrationsapplikationer för klassificering och objektigenkänning på Android-telefonen:
- , där data behandlas på servern och skickas till telefonen. Klassificering av bilder (image classification) av tre typer av björnar: brun, svart och plysch.
- , där data behandlas på själva telefonen. Objektigenkänning (object detection) av tre typer: hasselnöt, fikon och dadel.
Det finns en skillnad mellan uppgifter för bildklassificering, objektigenkänning på en bild och . Därför blev det nödvändigt att få veta vilka arkitekturer för neuronnät som upptäcker objekt på bilder och vilka som kan segmentera. Jag har hittat följande exempel på arkitekturer med de mest lättförståeliga länkarna till resurser:
- En serie arkitekturer baserade på R-CNN (Regioner med Convolution Neural Networks-funktioner): R-CNN, Fast R-CNN, , . För objektigenkänning på en bild används en mekanism för Region Proposal Network (RPN) för att markera begränsade områden (bounding boxes). Initialt användes en långsammare mekanism, Selective Search, istället för RPN. Därefter matas de markerade begränsade regionerna in i ett vanligt neuronnät för klassificering. I R-CNN-arkitekturen finns det tydliga "for"-loopar för att gå igenom de begränsade regionerna, totalt upp till 2000 genomgångar genom det interna nätet AlexNet. På grund av dessa tydliga "for"-loopar sänks hastigheten på bildbehandlingen. Antalet tydliga loopar, genomgångar genom det interna neuronnätet, minskar med varje ny version av arkitekturen, och dessutom görs dussintals andra förändringar för att öka hastigheten och byta uppgift från objektigenkänning till segmentering av objekt i Mask R-CNN.
- (You Only Look Once) – den första neurala nätverksarkitekturen som kunde känna igen objekt i realtid på mobila enheter. En särskiljande funktion är förmågan att särskilja objekt på ett enda lopp (man behöver bara se på det en gång). Det finns inga explicita "for"-loopar i YOLO:s arkitektur, vilket gör att nätverket fungerar snabbt. En liknelse är att i NumPy, vid operationer med matriser, finns det inte heller några explicita "for"-loopar, som i NumPy hanteras på lägre nivåer genom programmeringsspråket C. YOLO använder ett gitter av förutbestämda rutor. För att undvika att samma objekt identifieras flera gånger, används en överlappningskoefficient för rutorna (IoU, Intersection over Union). Denna arkitektur fungerar över ett brett intervall och har hög : modellen kan tränas på fotografier men fungerar även bra på ritade bilder.
- (Single Shot MultiBox Detector) – de mest framgångsrika "hacken" av YOLO-arkitekturen används (till exempel non-maximum suppression) och nya läggs till för att neuronnätet ska fungera snabbare och mer noggrant. En särskiljande funktion är att särskilja objekt på ett enda lopp med hjälp av ett angivet nät av rutor (default box) på en bildpyramid. Bildpyramiden kodas i konvolutionella tensorkopplingar under successive konvolutions- och poolingoperationer (vid max-pooling minskar den rumsliga dimensionen). Således kan både stora och små objekt identifieras på ett enda lopp av nätverket.
- MobileSSD (MobileNetV2 + SSD) – en kombination av två neurala nätverksarkitekturer. Den första nätverket fungerar snabbt och ökar noggrannheten i igenkänning. MobileNetV2 tillämpas istället för VGG-16, som ursprungligen användes i . Den andra nätverksarkitekturen SSD identifierar objektens placering på bilden.
- – ett mycket litet men exakt neuronnätverk. Självt löser det inte problemet med objektigenkänning. Men det kan användas i kombination med olika arkitekturer. Och användas i mobila enheter. En särskiljande funktion är att data först komprimeras till fyra 1×1 konvolutionsfilter, och sedan expanderas till fyra 1×1 och fyra 3×3 konvolutionsfilter. En sådan kompressions-expansionsiteration kallas "Fire Module".
- (Semantic Image Segmentation with Deep Convolutional Nets) – segmentering av objekt på bilden. En särskiljande egenskap hos arkitekturen är den glesa (dilated convolution) konvolutionen, som bevarar den spatiala upplösningen. Sedan följer en efterbehandlingsfas med hjälp av en grafisk sannolikhetsmodell (conditional random field) som möjliggör att avlägsna små störningar i segmenteringen och förbättra kvaliteten på den segmenterade bilden. Bakom det skrämmande namnet «grafisk sannolikhetsmodell» döljer sig ett vanligt Gauss-filter, som är aproximera med fem punkter.
- Försökte förstå hur den är konstruerad (Single-Shot Refinement Neural Network for Object Detektion), men jag förstod inte mycket.
- Jag tittade också på hur tekniken «uppmärksamhet» (attention) fungerar: , , . En särskiljande egenskap hos arkitekturen «uppmärksamhet» är automatisk identifiering av områden med ökad uppmärksamhet på bilden (RoI, Regions of Interest) med hjälp av ett neuralt nätverk som kallas Attention Unit. Områdena med ökad uppmärksamhet liknar begränsade områden (bounding boxes), men till skillnad från dem är de inte fixerade på bilden och kan ha diffus gränser. Sedan utvinner man egenskaper (features) från de områdena med ökad uppmärksamhet, som «matas» till rekurrenta neurala nätverk med arkitekturer . Rekurrenta neurala nätverk kan analysera relationerna mellan egenskaper i en sekvens. Rekurrenta neurala nätverk användes ursprungligen för att översätta text till andra språk, och nu även för att översätta och .
När jag studerade dessa arkitekturer insåg jag att jag inte förstod något. Och det handlar inte om att mitt neurala nätverk har problem med uppmärksamhetsmekanismen. Skapandet av alla dessa arkitekturer liknar någon sorts enorm hackathon, där skaparna tävlar i hacks. Hack (hack) – en snabb lösning på en svår programvaruuppgift. Det finns ingen synlig och förståelig logisk koppling mellan alla dessa arkitekturer. Allt som förenar dem är en uppsättning av de mest framgångsrika hacks som de lånat från varandra, plus en gemensam för alla (bakåtriktad felpropagering, backpropagation). Det finns inget ! Det är oklart vad som ska förändras och hur man optimerar de befintliga prestationerna.
Som resultat av avsaknaden av logisk koppling mellan hacket är de extremt svåra att minnas och tillämpa i praktiken. Det handlar om fragmenterad kunskap. Som bäst minns man några intressanta och oväntade punkter, men det mesta av det förstådda och oförstådda försvinner ur minnet redan efter några dagar. Det vore bra om man efter en vecka i alla fall kommer ihåg namnet på arkitekturen. Och ändå har man lagt flera timmar och till och med dagar av arbetskraft på att läsa artiklar och se översiktsvideor!
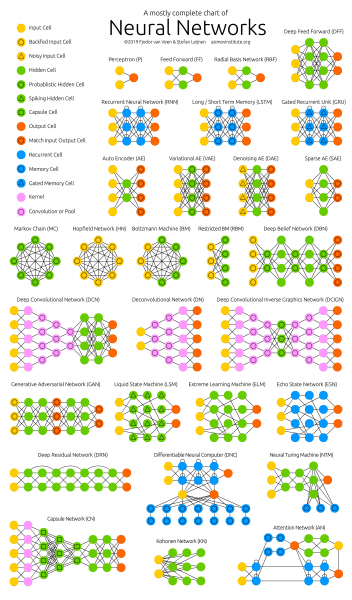
Figur 2 –
De flesta författare av vetenskapliga artiklar, enligt min personliga åsikt, gör allt för att även denna fragmenterade kunskap ska vara svår att förstå för läsaren. Men gerundkonstruktioner i tio linjära meningar med formler som är tagna "från taket" – det är ett ämne för en separat artikel (problemet ).
Av denna anledning uppstod behovet att systematisera informationen om neuronnät och därigenom öka kvaliteten på förståelse och minne. Därför blev det huvudsakliga temat för analysen av olika teknologier och arkitekturer av artificiella neuronnät den följande uppgiften: att ta reda på vart allt detta är på väg, snarare än att förstå konstruktionen av ett specifikt neuronnät separat.
Vart allt detta är på väg. Huvudsakliga resultat:
- Antalet startups inom maskininlärning har under de senaste två åren . En möjlig anledning: "neuronnät har slutat vara något nytt."
- Var och en kan skapa ett fungerande neuronnät för att lösa en enkel uppgift. För detta tar man en färdig modell från "djurparken av modeller" (model zoo) och tränar det sista lagret av neuronnätet () på färdiga data från eller från i den gratis .
- Stora tillverkare av neuronnät har börjat skapa "djurparker av modeller" (model zoo). Med deras hjälp kan man snabbt skapa en kommersiell applikation: för TensorFlow, för PyTorch, för Caffe2, för Chainer och .
- Neuronnät som fungerar i real-tid på mobila enheter. Från 10 till 50 bildrutor per sekund.
- Användning av neuronnät i telefoner (TF Lite), i webbläsare (TF.js) och i (IoT, Iinternet of Tav saker). Särskilt i telefoner som redan stödjer neuronnät på hårdvarunivå (neuroacceleratorer).
- Varje enhet, klädesplagg och kanske till och med mat kommer att ha IP-v6 adress och kommunicera med varandra» – .
- Ökningen av publikationer inom maskininlärning har börjat (dubblade varje två år) sedan 2015. Det är uppenbart att neurala nätverk för artikelanalys behövs.
- Följande teknologier ökar i popularitet:
- PyTorch – populariteten växer snabbt och verkar överträffa TensorFlow.
- Automatisk hyperparameterjustering AutoML – populariteten växer långsamt.
- Gradvis minskning av noggrannhet och ökning av beräkningshastighet: , algoritmer , inaktuell (approximerande) beräkningar, kvantisering (när vikterna i det neurala nätverket omvandlas till heltal och kvantiseras), neuroacceleratorer.
- Översättning och .
- Skapande , nu i realtid.
- Det huvudsakliga inom DL – är stora mängder data, men att samla och märka dem är inte lätt. Därför utvecklas automatisering av märkning () för neurala nätverk med hjälp av neurala nätverk.
- Med neurala nätverk har datavetenskap plötsligt blivit en experimentell vetenskap och en .
- IT-pengar och populariteten av neurala nätverk uppstod samtidigt när beräkningar blev ett marknadsvärde. Ekonomin går från guld/valuta till guld-valuta-beräknings. Se min artikel om och orsaken till uppkomsten av IT-pengar.
Gradvis dyker en ny (Maskininlärning & Djupinlärning), som baseras på att betrakta programmet som en uppsättning tränade neurala nätverksmodeller.
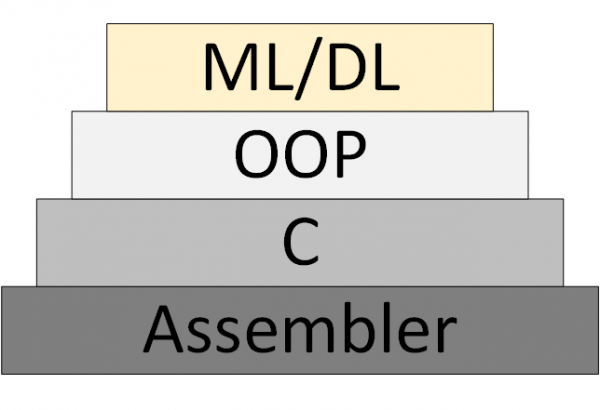
Bild 3 – ML/DL som en ny programmeringsmetodologi
Men det har fortfarande inte kommit någon «teori för neurala nätverk», inom vilken man kan tänka och arbeta systematiskt. Vad som nu kallas
teori
- är egentligen experimentella, heuristiska algoritmer.
- Länkar till mina och andra resurser: En allmän
- , som jag har gått och som jag skulle vilja gå. .
- , där alla kan hitta något intressant för sig själva.
- Mycket användbara har visat sig vara videokanaler för analys av vetenskapliga artiklar inom Data Science. Hitta dem, prenumerera på dem och dela länkar med dina kollegor och mig också. Exempel:
- som med steg-för-steg-instruktioner och öppen källkod.
Tack för uppmärksamheten!
Källa: habr.com
