

tl;dr:
- Maskininlärning letar efter mönster i data. Men artificiell intelligens kan vara 'partisk' — det vill säga, den kan hitta felaktiga mönster. Till exempel kan ett system för att upptäcka hudcancer via fotografier fästa särskild uppmärksamhet vid bilder tagna i läkarmottagningar. Maskininlärning kan inte förstå: dess algoritmer identifierar bara mönster i siffror, och om data inte är representativa kommer resultatet av deras bearbetning att vara detsamma. Att fånga sådana buggar kan vara svårt på grund av själva mekaniken i maskininlärning.
- Det mest uppenbara och skrämmande проблемområdet är människors mångfald. Det finns många skäl till varför data om människor kan förlora objektivitet redan vid insamlingsstadiet. Men man bör inte tro att detta problem bara gäller människor: liknande svårigheter uppstår också vid försök att upptäcka en översvämning på ett lager eller en trasig gasturbin. Vissa system kan ha fördomar mot hudfärg, medan andra kan vara partiska mot Siemens-sensorer.
- Dessa problem är inte nya för maskininlärning, och de är inte unika för bara den. Felaktiga antaganden görs i alla komplexa strukturer, och att förstå varför ett visst beslut fattades är alltid en utmaning. Detta måste bekämpas på ett holistiskt sätt: skapa verktyg och processer för verifiering — och utbilda användarna så att de inte blint följer AI:s rekommendationer. Maskininlärning gör verkligen vissa saker mycket bättre än vi gör — men hundar, till exempel, är betydligt effektivare än människor på att upptäcka droger, vilket inte alls är en anledning att använda dem som vittnen och döma baserat på deras vittnesmål. Och hundar, för att nämna det, är mycket smartare än något system för maskininlärning.
Maskininlärning är idag en av de viktigaste grundläggande teknologiska trenderna. Det är ett av de främsta sätten som teknologin kommer att förändra världen omkring oss under det kommande decenniet. Vissa aspekter av dessa förändringar väcker oro. Till exempel, den potentiella påverkan av maskininlärning på arbetsmarknaden, eller dess användning för oetiska syften (till exempel av auktoritära regimer). Det finns ytterligare ett problem, vilket detta inlägg handlar om: partiskhet hos artificiell intelligens.
Det här är en komplex historia.
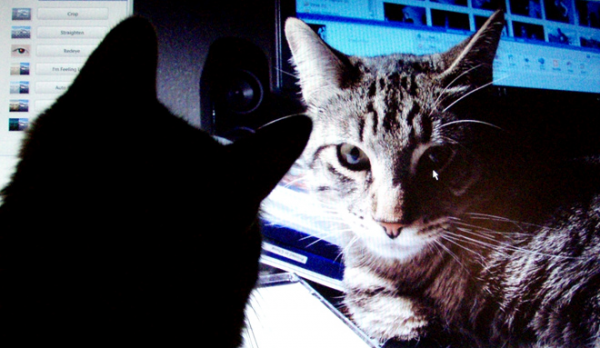
Google AI kan hitta katter. Denna nyhet från 2012 var då något speciellt.
Vad är "AI-bias"?
"Rådata" är både en oxymoron och en dålig idé; data måste bearbetas noggrant och med omsorg. —Jeffrey Boker
Fram till 2013, för att skapa ett system som, säg, känner igen katter på fotografier, behövde du beskriva logiska steg. Hur man hittar hörn i bilden, känner igen ögon, analyserar texturer för päls, räknar fötter och så vidare. Sedan sammanställde man alla komponenter – och insåg att det knappt fungerade. Ungefär som en mekanisk häst – teoretiskt möjligt, men praktiskt sett för komplicerat att beskriva. I slutändan fick man hundratals (eller till och med tusentals) handskrivna regler. Och ingen fungerande modell.
Med maskininlärning slutade vi använda "manuella" regler för att känna igen olika objekt. Istället tar vi tusen exempel av "det", X, tusen exempel av "det andra", Y, och får datorn att bygga en modell baserad på deras statistiska analys. Sedan ger vi denna modell ett exempel på data, och den bestämmer med viss precision om det passar någon av uppsättningarna. Maskininlärning genererar en modell baserat på data, snarare än med hjälp av en människa som skriver den. Resultaten är imponerande, särskilt inom bild- och mönsterigenkänning, och det är därför hela teknikbranschen nu går över till maskininlärning (ML).
Men det är inte så enkelt. I verkliga livet innehåller dina tusen exempel X eller Y också A, B, J, L, O, R och även L. De kan vara ojämnt fördelade, och vissa av dem kan förekomma så ofta att systemet lägger mer vikt vid dem än vid de objekt som du är intresserad av.
Vad betyder det här i praktiken? Mitt favoritexempel är när bildigenkänningssystem . Det är tydligt varför: de flesta exempelbilder på "får" tas på ängar där de bor, och på dessa bilder tar gräset upp mycket mer utrymme än de små vita fluffiga fåren, och just gräset bedöms som det viktigaste av systemen.
Det finns också allvarligare exempel. Ett av de senaste är ett i upptäckten av hudcancer på fotografier. Det visade sig att dermatologer ofta fotograferar en linjal tillsammans med manifestationer av hudcancer för att dokumentera storleken på formationerna. På exempelbilder av frisk hud finns det inga linjaler. För ett AI-system blev dessa linjaler (mer exakt, pixlar som vi identifierar som "linjal") en av skillnaderna mellan uppsättningarna av exempel, och ibland viktigare än små utslag på huden. Så systemet, som skapades för att känna igen hudcancer, kände ibland igen linjaler istället för det.
Den centrala punkten här är att systemet inte har en semantisk förståelse för vad det tittar på. Vi ser ett antal pixlar och identifierar dem som en får, hud eller linjaler, medan systemet endast ser en numerisk sträng. Det ser inte tredimensionellt utrymme, ser varken objekt, texturer eller får. Det ser bara mönster i datan.
Svårigheten med att diagnostisera sådana problem är att neurala nätverk (modellen som genererats av ditt maskininlärningssystem) består av tusentals hundratusentals noder. Det finns inget enkelt sätt att titta in i modellen och se hur den fattar beslut. Att ha ett sådant sätt skulle innebära att processen är tillräckligt enkel för att beskriva alla regler manuellt, utan att använda maskininlärning. Människor oroar sig för att maskininlärning har blivit någon slags "svart låda". (Jag förklarar snart varför denna jämförelse ändå är överdriven.)
Detta är i stora drag problemet med fördomar i artificiell intelligens eller maskininlärning: systemet för att hitta mönster i data kan hitta felaktiga mönster, och du kan omöjligt märka det. Detta är en grundläggande egenskap hos teknologin, och det är uppenbart för alla som arbetar med den inom vetenskapliga kretsar och stora teknikföretag. Men dess konsekvenser är komplexa, och våra möjliga lösningar på dessa konsekvenser är också.
Låt oss först prata om konsekvenserna.
AI kan implicit göra val för oss till förmån för olika kategorier av människor baserat på ett stort antal osynliga signaler.
Scenarier för AI-fördomar.
Det mest uppenbara och skrämmande är att detta problem kan visa sig när det handlar om mänsklig mångfald. Nyligen , som Amazon försökte bygga ett system för maskininlärning för primär urval av jobbkandidater. Eftersom det finns fler män bland Amazons anställda, var exempel på "lyckad rekrytering" också oftare av manligt kön, och i urvalet av CV:n som systemet föreslog fanns det fler män. Amazon märkte detta och släppte inte systemet i produktion.
Det viktigaste i detta exempel är att systemet, enligt rykten, föredrog manliga kandidater, trots att kön inte angavs i CV:n. Systemet såg andra mönster i exemplen på "lyckad rekrytering": till exempel kan kvinnor använda speciella ord för att beskriva prestationer, eller ha särskilda hobbyer. Självklart visste inte systemet vad "hockey" var, vem "människor" var, eller vad "framgång" var – det utförde bara statistisk analys av texten. Men de mönster som det såg skulle troligen förbli obemärkta av en människa, och vissa av dem (till exempel att människor av olika kön beskriver framgång på olika sätt) skulle vi troligen ha svårt att se, även om vi tittade på dem.
Det blir värre. Ett maskininlärningssystem som mycket bra upptäcker cancer på ljus hud kan fungera sämre på mörk hud, eller tvärtom. Inte nödvändigtvis på grund av partiskhet, utan för att du troligen behöver bygga en separat modell för en annan hudfärg och välja andra egenskaper. Maskininlärningssystem är inte utbytbara ens i en så snäv sfär som bildigenkänning. Du måste anpassa systemet, ibland bara genom försök och misstag, för att bra kunna lägga märke till egenskaperna i de data som intresserar dig, tills du når önskad noggrannhet. Men du kanske inte märker att systemet är 98 % korrekt när det arbetar med en grupp och bara 91 % (även om det är mer exakt än en mänsklig analys) med en annan.
Jag har hittills mest använt exempel som rör människor och deras egenskaper. Det är detta tema som diskussionen runt detta problem i huvudsak fokuserar på. Men det är viktigt att förstå att partiskhet mot människor bara är en del av problemet. Vi kommer att använda maskininlärning för många saker, och urvalsfelet kommer att vara relevant för alla dessa. Å andra sidan, om du arbetar med människor, kan datapartiskhet vara orelaterad till dem.
För att förstå detta, låt oss återvända till exemplet med hudcancer och överväga tre hypotetiska sätt som systemet kan bryta ner.
- Ojämt fördelad befolkning: en obalanserad mängd fotografier av hud av olika nyanser, vilket leder till falskt positiva eller falskt negativa resultat relaterade till pigmentering.
- De data som systemet tränas på innehåller en frekvent och ojämt fördelad egenskap som inte är relaterad till människor och saknar diagnostiskt värde: en linjal på fotografier av hudcancer eller gräs på fotografier av får. I det här fallet kommer resultatet att skilja sig om systemet hittar pixlar av något som det mänskliga ögat skulle identifiera som "linjal".
- Data innehåller en extern egenskap som en människa inte kan se, även om hen letar efter den.
Vad innebär detta? Vi vet i förväg att data kan representera olika grupper av människor på olika sätt och att vi åtminstone kan planera för att söka efter sådana undantag. Med andra ord finns det många sociala skäl att anta att data om grupper av människor redan innehåller en viss fördom. Om vi tittar på fotot med en linjal ser vi den linjalen — vi har helt enkelt ignorerat den tidigare, med vetskap om att den inte är relevant, och glömt att systemet vet ingenting.
Men vad händer om alla dina fotografier av ohälsosam hud tas i ett kontor där glödlampor används, medan de friska tas under fluorescerande ljus? Vad händer om du efter att ha filmat den friska huden uppdaterade operativsystemet på din telefon innan du fotograferade den ohälsosamma huden, och Apple eller Google ändrade algoritmen för brusreducering något? En människa skulle inte märka detta, oavsett hur mycket hen letar efter sådana egenskaper. Men systemet för maskininlärning ser genast detta och använder det. Det vet ingenting.
Även om vi har talat om falska korrelationer kan det också hända att både data är korrekta och resultaten är riktiga, men att du inte vill använda dem av etiska, juridiska eller förvaltningsmässiga skäl. I vissa jurisdiktioner får man till exempel inte ge kvinnor rabatt på försäkringar, trots att kvinnor kanske kör säkrare. Vi kan enkelt föreställa oss ett system som, när det analyserar historiska data, tilldelar kvinnliga namn en lägre riskkoefficient. Okej, låt oss ta bort namnen från urvalet. Men kom ihåg exemplet med Amazon: systemet kan identifiera kön baserat på andra faktorer (även om det inte vet vad kön är, eller vad en bil är), och du kommer inte att märka det förrän en regulatorbacktrackar och analyserar de erbjudanden du presenterat och ålägger dig böter.
Till sist antas det ofta att vi endast kommer att använda sådana system för projekt som är relaterade till människor och sociala interaktioner. Så är inte fallet. Om du tillverkar gasturbiner vill du förmodligen använda maskininlärning på telemetri som överförs av dussintals eller hundratals sensorer i din produkt (ljud-, video-, temperatur- och andra sensorer genererar data som lätt kan anpassas för att skapa en maskininlärningsmodell). Hypotetiskt kan du säga: "Här är data om tusen trasiga turbiner som samlades in före deras fel, och här är data från tusen turbiner som inte har gått sönder. Bygg en modell som säger vad som skiljer dem åt." Men nu tänk dig att Siemens-sensorer finns på 75 % av de dåliga turbinerna och endast 12 % av de bra (utan samband med felen). Systemet kommer att bygga en modell för att hitta turbiner med Siemens-sensorer. Oops!

Bild — Moritz Hardt, UC Berkeley
Hantering av AI-bias
Vad kan vi göra åt detta? Vi kan närma oss frågan från tre håll:
- Metodologisk noggrannhet vid insamling och hantering av data för att träna systemet.
- Tekniska verktyg för att analysera och diagnostisera modellens beteende.
- Utbildning, träning och försiktighet vid implementering av maskininlärning i produkter.
I boken "Mästaren i adel" av Molière finns det ett skämt: en man får veta att litteratur delas in i prosa och dikt, och han upptäcker med förundran att han hela sitt liv har talat prosa utan att veta om det. Antagligen känner statistiker sig också så idag: utan att märka det har de ägnat sina karriärer åt artificiell intelligens och urvalsfel. Att söka felet i urvalet och oroa sig över det är inget nytt problem; vi måste helt enkelt närma oss lösningen på det systematiskt. Som nämnt ovan är det i vissa fall verkligen lättare att studera problem relaterade till data om människor. Vi utgår per definition från att vi kan ha fördomar gentemot olika grupper av människor, men att ha fördomar om Siemens-sensorer kan vi knappt ens föreställa oss.
Det nya i allt detta är förstås att människor inte längre sysslar med statistisk analys direkt. Det utförs av maskiner som skapar stora, komplexa modeller som är svåra att förstå. Frågan om transparens är en av de grundläggande aspekterna av problematiken med partiskhet. Vi är rädda för att systemet inte bara är partiskt, utan att det inte finns någon möjlighet att upptäcka dess partiskhet, och att maskininlärning skiljer sig från andra former av automatisering, som förväntas bestå av tydliga logiska steg som kan verifieras.
Här finns det två problem. Vi kan kanske ändå genomföra någon form av granskning av maskininlärningssystem. Och att granska vilket annat system som helst är faktiskt inte lättare.
För det första är en av riktningarna inom modern forskning inom maskininlärning att hitta metoder för att identifiera viktig funktionalitet hos maskininlärningssystem. Samtidigt är maskininlärning (i sitt nuvarande tillstånd) ett helt nytt vetenskapsområde som förändras snabbt, så det är inte klokt att tro att idag omöjliga saker snart kan bli helt reella. Projektet är ett intressant exempel på detta.
För det andra, idén att man kan kontrollera och förstå beslutsprocessen i befintliga system eller organisationer är bra i teorin, men inte så mycket i praktiken. Att förstå hur beslut fattas i en stor organisation är inte enkelt. Även om det finns en formell beslutsprocess, återspeglar den inte hur människor faktiskt interagerar, och de själva har ofta inte en logisk systematisk metod för sina beslut. Som min kollega sa , människor är också svarta lådor.
Ta tusen personer i flera överlappande företag och institutioner, och problemet blir ännu mer komplicerat. Vi vet i efterhand att "Space Shuttle" var dömd att splittras vid återkomsten, och enskilda individer inom NASA hade information som gav dem anledning att tro att något dåligt kunde hända, men systemet i stort sett visste inte detta. NASA hade även just genomfört en liknande granskning och förlorat den tidigare rymdfärjan, och ändå förlorade man ännu en — av en mycket liknande anledning. Det är lätt att påstå att organisationer och människor följer tydliga logiska regler som kan kontrolleras, förstås och förändras — men erfarenheten säger något annat. Det är "».
Jag jämför ofta maskininlärning med databaser, särskilt relationella — en ny fundamentalt teknologi som förändrade möjligheterna inom datavetenskap och världen omkring den, som blev en del av allt, som vi konstant använder utan att vara medvetna om det. Även databaser har problem som liknar dessa: systemet kan vara byggt på felaktiga antaganden eller dåliga data, men det är svårt att upptäcka, och de som använder systemet kommer att göra vad det säger utan att ifrågasätta. Det finns många gamla skämt om skattemyndighetens anställda som felaktigt skrev ditt namn en gång, och att övertyga dem att rätta till felet är mycket svårare än att verkligen ändra ditt namn. Man kan tänka på detta på olika sätt, men det är oklart vad som är bäst: som ett tekniskt problem i SQL, eller som ett fel i en Oracle-version, eller som ett misslyckande hos byråkratiska institutioner? Hur svårt är det att hitta ett misstag i processen som ledde till att systemet inte har en funktion för att rätta stavfel? Kunde det ha förståtts innan folk började klaga?
Detta illustreras ännu enklare genom historier om förare som på grund av föråldrade data i navigatörer kör ner i floder. Okej, kartorna måste uppdateras kontinuerligt. Men hur mycket skuld har TomTom för att din bil dras ut i havet?
Jag säger detta för att ja - fördomar i maskininlärning kommer att skapa problem. Men dessa problem kommer att likna de vi har ställts inför tidigare, och de kan märkas och lösas (eller inte) ungefär lika bra som vi har lyckats med tidigare. Därför är scenariot där AI-fördomar skadar osannolikt att inträffa med ledande forskare som arbetar inom stora organisationer. Troligtvis kommer någon obetydlig teknisk entreprenör eller programvaruleverantör att skriva något hastigt, med okända open-source-komponenter, bibliotek och verktyg. Och den olycklige kunden kommer att gå på frasen "artificiell intelligens" i produktbeskrivningen och, utan att ställa för många frågor, dela det med sina lågavlönade arbetare, och ålägga dem att göra vad AI säger. Det är precis vad som hände med databaser. Detta är inte ett problem med artificiell intelligens, och inte ens ett problem med programvara. Det är en mänsklig faktor.
Slutsats
Maskininlärning kan göra allt som du kan lära en hund - men du kan aldrig vara säker på vad du faktiskt har lärt hunden.
Jag får ofta känslan av att termen «artificiell intelligens» bara hindrar oss från att delta i diskussioner som dessa. Den här termen ger en falsk uppfattning om att vi faktiskt har skapat den — denna intelligens. Att vi är på väg mot HAL9000 eller Skynet — till något som faktiskt förstår. Men nej. Det är bara maskiner, och det är mycket mer korrekt att jämföra dem, låt oss säga, med en tvättmaskin. Den klarar tvätten mycket bättre än en människa, men om du lägger disken istället för kläder i den kommer den att… tvätta den. Disken blir till och med ren. Men det blir inte det du hade förväntat dig, och detta kommer att hända inte för att systemet har några fördomar mot disken. Tvättmaskinen vet varken vad en disk är eller vad kläder är — det är bara ett exempel på automatisering, konceptuellt inte annorlunda än hur processer automatiserades tidigare.
Oavsett vad ämnet handlar om — om maskiner, flygplan eller databaser — kommer dessa system att vara både mycket kraftfulla och mycket begränsade. De kommer helt att bero på hur människor använder dessa system, oavsett om deras avsikter är goda eller dåliga och hur väl de förstår deras funktion.
Därför är det helt fel att säga att «artificiell intelligens är matematik, så den kan inte ha några fördomar». Men det är lika felaktigt att påstå att maskininlärning «är subjektiv av sin natur». Maskininlärning hittar mönster i data, och vilka mönster den hittar beror på datan, och datan beroende av oss. Liksom vad vi gör med den. Maskininlärning gör faktiskt några saker mycket bättre än vi gör — men hundar, till exempel, är mycket effektivare än människor på att upptäcka droger, vilket inte ger någon anledning att använda dem som vittnen och döma på grundval av deras vittnesmål. Och hundar är för övrigt mycket smartare än något system för maskininlärning.
Översättning: .
Redigering: .
Gemenskap: .
Källa: habr.com
