

Ett detaljerat dokument har publicerats om hur man optimerar Linux-miljön för att uppnå maximal prestanda vid behandling av HTTP-förfrågningar. De föreslagna metoderna har möjliggjort en ökning av prestandan för JSON-handlaren baserat på libreactor-biblioteket i Amazon EC2-miljö (4 vCPU) från 224 000 API-förfrågningar per sekund med standardinställningarna för Amazon Linux 2 med kernel 4.14 till 1,2 miljoner förfrågningar per sekund efter genomförda optimeringar (en ökning på 436%), samt resulterat i en minskning av latensen vid behandling av förfrågningar med 79%. De föreslagna metoderna är inte specifika för libreactor och fungerar med andra HTTP-servrar, inklusive nginx, Actix, Netty och Node.js (libreactor användes i testerna eftersom lösningen baserad på det visade den bästa prestandan).
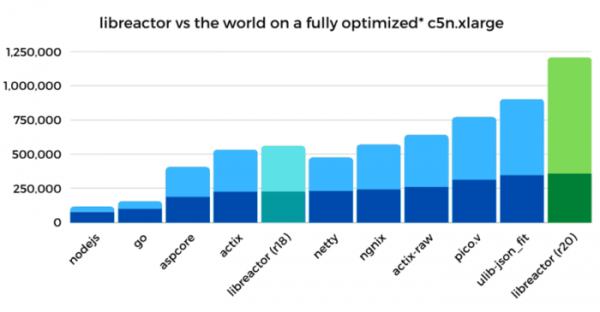
Huvudoptimeringar:
- Optimering av libreactor-koden. En variant av R18 från Techempower-settet användes som grund, som har förbättringar genom att ta bort koden för att begränsa antalet använda CPU-kärnor (optimeringen ökade hastigheten med 25-27%), kompilering i GCC med alternativen "-O3" (ökning 5-10%) och "-march-native" (5-10%), ersättning av read/write-anrop med recv/send (5-10%) och minskning av overhead vid användning av pthreads (2-3%). Den totala prestandaökningen efter kodoptimeringen var 55%, och genomströmningen ökade från 224k req/s till 347k req/s.
- Deaktivering av skydd mot sårbarheter orsakade av spekulativ exekvering av instruktioner. Användning av parametrar vid inläsning av kernel "nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off" gjorde det möjligt att öka prestandan med 28%, och genomströmningen ökade från 347k req/s till 446k req/s. För parameter "nospectre_v1" (skydd mot Spectre v1 + SWAPGS) var ökningen 1-2%, "nospectre_v2" (skydd mot Spectre v2) – 15-20%, "pti=off" (Spectre v3/Meltdown) – 6%, "mds=off tsx_async_abort=off" (MDS/Zombieload och TSX Asynchronous Abort) – 6%. Inställningarna för skydd mot L1TF/Foreshadow-attacker (l1tf=flush), iTLB multihit, Speculative Store Bypass och SRBDS lämnades oförändrade, vilket inte påverkade prestandan, eftersom de inte korsade med den testade konfigurationen (t.ex. specifika för KVM, inbäddad virtualisering och andra CPU-modeller).
- Deaktivering av granskning och blockering av systemanrop med kommandot "auditctl -a never,task" och angivelse av alternativet "—security-opt seccomp=unconfined" vid körning av docker-kontainern. Den totala prestandaökningen var 11%, och genomströmningen ökade från 446k req/s till 495k req/s.
- Avaktivering av iptables/netfilter genom att avlägsna de relaterade kärnmodulerna. Idén att stänga av brandväggen, som inte användes i en specifik serverlösning, kom från profileringsresultat som visade att funktionen nf_hook_slow använde 18% av tiden. Det noteras att nftables fungerar mer effektivt än iptables, men iptables fortsätter att användas i Amazon Linux. Efter att ha stängt av iptables ökade prestandan med 22%, och kapaciteten steg från 495k req/s till 603k req/s.
- Minskning av migreringen av hanterare mellan olika CPU-kärnor för att öka effektiviteten i användningen av processorcache. Optimering har genomförts både på nivån av processbinding med libreactor till CPU-kärnor (CPU Pinning) och genom att binda nätverksbehandlare på kärnnivå (Receive Side Scaling). Till exempel har irqbalance stängts av och köernas kopplingar har ställts in i /proc/irq/$IRQ/smp_affinity_list. För att använda samma CPU-kärna för att hantera libreactor-processen och nätverkskön av inkommande paket har en egen BPF-behandlare använts, ansluten genom att sätta flaggan SO_ATTACH_REUSEPORT_CBPF vid skapandet av sockeln. För att binda utgående paketköer till CPU har inställningarna i /sys/class/net/eth0/queues/tx-<n>/xps_cpus ändrats. Den totala prestandaökningen var 38%, och kapaciteten steg från 603k req/s till 834k req/s.
- Optimering av avbrottshantering och användning av polling. Aktivering av läget adaptive-rx i ENA-drivrutinen och manipulationer med sysctl net.core.busy_read har möjliggjort en prestandaökning på 28% (kapaciteten ökade från 834k req/s till 1.06M req/s, och latensen minskade från 361μs till 292μs).
- Avaktivering av systemtjänster som orsakar onödiga blockeringar i nätverksstacken. Stängning av dhclient och installation IP-adresser manuellt ledde till en prestandaökning på 6%, och kapaciteten ökade från 1.06M req/s till 1.12M req/s. Orsaken till dhclients påverkan på prestanda i trafikanalysen med hjälp av raw-socket.
- Kamp mot Spin Lock. Övergång av nätverksstacken till läget "noqueue" via sysctl "net.core.default_qdisc=noqueue" och "tc qdisc replace dev eth0 root mq" resulterade i en prestandaökning på 2%, och kapaciteten ökade från 1.12M req/s till 1.15M req/s.
- Avslutande småoptimeringar, såsom att stänga av GRO (Generic Receive Offload) med kommandot «ethtool -K eth0 gro off» och byta algoritm för överbelastningskontroll från cubic till reno med hjälp av sysctl «net.ipv4.tcp_congestion_control=reno». Den totala prestandaökningen uppgick till 4%. Genomströmningen ökade från 1.15M req/s till 1.2M req/s.
Förutom de framgångsrika optimeringarna diskuteras i artikeln också metoder som inte ledde till den förväntade prestandaökningen. Till exempel visade sig följande vara ineffektiva:
- En separat körning av libreactor uppvisade ingen skillnad i prestanda jämfört med körning i en container. Att byta writev mot send, öka maxevents i epoll_wait, och experimentera med versioner och flaggor i GCC påverkade inte prestandan (effekten var endast märkbar för flaggorna «-O3» och «-march-native»).
- Uppdatering av Linux-kärnan till versioner 4.19 och 5.4, användning av schemaläggarna SCHED_FIFO och SCHED_RR, samt manipulationer med sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 och clocksource=tsc påverkade inte prestandan.
- I ENA-drivrutinen påverkade inte aktivering av Offload-lägen (segmentation, scatter-gather, rx/tx checksum), kompilering med flaggan «-O3» och tillämpning av parametrarna ena.rx_queue_size och ena.force_large_llq_header.
- Ändringar i nätverksstacken ledde inte till en ökning av prestandan:
- Stänga av IPv6: ipv6.disable=1
- Stänga av VLAN: modprobe -rv 8021q
- Stänga av paketsurskontrollen
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (negativ effekt)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Källa: opennet.ru
