

Efter fem månaders utveckling har version 1.1 av projektet IncidentRelay publicerats. Den utvecklar ett öppet system för att organisera vaktarbete, routa aviseringar och hantera incidenter, vilket körs på egen server (self-hosted). IncidentRelay 1.1 har markerats som den första stabila versionen (gren 1.0 hade beta-status). Projektet är riktat mot SRE, DevOps och infrastrukturteam som behöver en lokalt distribuerbar alternativ till SaaS-tjänster för hantering av vaktarbete (on-call management), tillämpning av eskaleringspolicyer och reaktion på incidenter. Projektets kod är skriven i Python och distribueras under MIT-licensen.
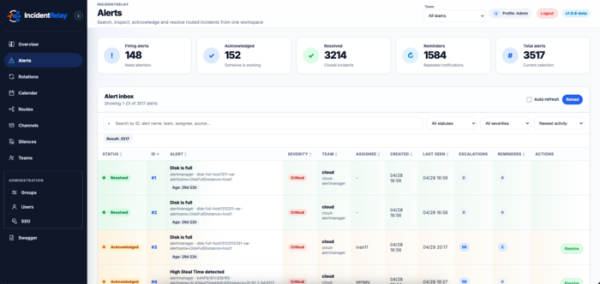
IncidentRelay mottar händelser från övervakningssystem och matchar dem med tjänster, team och rotationer, och levererar sedan aviseringar till ansvariga vakter eller team. Systemet har scheman för vakter, rotationer, omprioriteringar av skift, bekräftelse av mottagande av incidenter, ACK/Resolve-statusar, påminnelser, eskaleringar, tidsbegränsade ersättningar av vakter, bestämning av tid för planerat arbete och undertryckning av bullriga aviseringar.
Det främsta fördelarna med projektet är fullständig kontroll över infrastrukturen och logiken för routing. IncidentRelay körs i sin egen miljö, arbetar med sin egen databas och möjliggör en tydlig separation av inkommande rutter, team, rotationer och leveranskanaler. Inkommande token tillhör rutterna, och inte kanalerna, vilket gör det lättare att förstå vilken extern källa som har rätt att skicka händelser till ett specifikt team.
IncidentRelay stödjer mottagande av händelser från Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch och godtyckliga webhooks. För att skicka aviseringar finns det kanaler som Mattermost, Slack, Telegram, Discord, Microsoft Teams, e-post, webhooks, browser/PWA push och leverantörer av röstuppringningar. I Mattermost och Telegram kan aviseringarna innehålla åtgärder för att bekräfta och lösa problem, vilket möjliggör hantering av incidenter utan att gå till ett separat gränssnitt.
Projektet kan köras via Docker Compose, RPM-paket för Red Hat-liknande distributioner, manuellt via systemd, samt i Kubernetes med hjälp av Helm-diagram. För små installationer kan SQLite användas, medan PostgreSQL rekommenderas för produktionssystem och högre belastningar.
I den nya versionen föreslås följande ändringar:
- Flera nivåer av jourrotationer har lagts till med tidsbegränsningar, prioriteringar av lager och hänsyn till tillfälliga ersättningar;
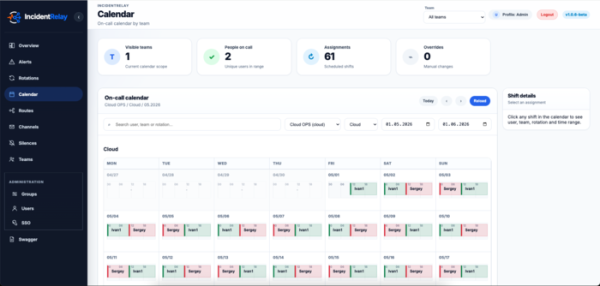
- Det har införts en jourkalender, CalDAV och ICS-prenumerationer för externa kalendrar;
- Incidenteskalationspolicyer med flerstegs kedjor för nivåhöjning har implementerats;
- Varningsgrupper, händelsegruppering, fördröjda meddelanden och manuell sammanslagning av relaterade varningar har lagts till;
- Fönster för planerade arbeten och 'tysta' varningar har införts;
- Möjligheten att lägga till kommentarer till varningar har lagts till;
- Incidentprioriteringar (P1-P5) och automatisk prioriteringshöjning baserat på vikten har lagts till;
- Tjänstekatalog, tjänstberoenden, SLI/SLO, historik över påverkan på systemens funktion (Service Impact History) och affärstjänster (Business Services) har implementerats;
- Explain Trace har lagts till för att analysera routing: varför en varning kom in eller inte kom in i teamet, grupperades, tystades eller skickades till en specifik kanal;
- Kontroller (Heartbeats/dead-man-switch) för watchdog, backup, ETL och andra uppgifter där avsaknaden av förväntad signal är ett problem har lagts till.
Källa: opennet.ru
