

Projektet DBOS (DBMS-orienterat operativsystem) har presenterats, vilket utvecklar ett nytt operativsystem för att köra skalbara distribuerade applikationer. En särskilt egenskap vid projektet är användningen av en databas för att lagra applikationer och systemtillstånd, samt att åtkomst till tillståndet endast organiseras genom transaktioner. Projektet utvecklas av forskare från Massachusetts Institute of Technology, University of Wisconsin, Stanford University, Carnegie Mellon University och företagen Google och VMware. Resultatet sprids under MIT-licensen.
Komponenter för interaktion med hårdvara och låg nivå tjänster för minneshantering har flyttats till mikro-kärnan. De funktioner som erbjuds av mikro-kärnan används för att starta ett lager med databashantering. Högnivå systemtjänster som möjliggör körning av applikationer interagerar endast med den distribuerade databasen och är åtskilda från mikro-kärnan och specifika komponenter för det aktuella systemet.
Att bygga ovanpå den distribuerade databasen tillåter systemtjänster att från början vara distribuerade och oberoende av en specifik nod, vilket särskiljer DBOS från traditionella klustersystem, där varje nod kör sin egen instans av operativsystemet, ovanpå vilket separata klusterplanerare, distribuerade filsystem och nätverkschefer körs.
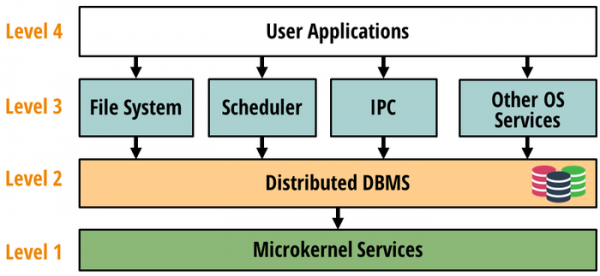
Det påpekas att användning av moderna distribuerade databaser som bas för DBOS, som lagrar data i minnet och stöder transaktioner, såsom VoltDB och FoundationDB, kan ge prestanda tillräcklig för att effektivt köra många systemtjänster. I databasen kan även data från planeraren, filsystemet och IPC placeras. Dessa databaser kan dessutom skalas väl, säkerställa atomäritet och isolering av transaktioner, hantera petabyte av data och tillhandahålla verktyg för åtkomsthantering och spårning av datastreamar.
Bland de fördelar med den föreslagna arkitekturen nämns en betydande utvidgning av analysmöjligheterna och minskad kodkomplexitet genom användning av vanliga frågor till databashanteringssystemet i tjänsterna i operativsystemet, där implementeringen av transaktioner och medel för att säkerställa hög tillgänglighet flyttas till databashanteringssystemet (liknande funktionalitet kan implementeras på databashanteringssystemets sida en gång och användas i operativsystemet och applikationerna).
Till exempel kan en klusterplanerare spara information om uppgifter och hanterare i databashanteringssystemets tabeller och utföra planeringsoperationer som vanliga transaktioner, vilket blandar imperativ kod och SQL. Användningen av transaktioner förenklar lösningen på problem som hantering av flera trådar och återställning efter fel, eftersom transaktioner garanterar konsistens och stabilitet i tillståndet. I sammanhanget med exemplet med planeraren gör transaktioner det möjligt att organisera samtidig åtkomst till delade data och garantera bevaring av tillståndets integritet i händelse av fel.
De mekanismer som tillhandahålls av databashanteringssystemet för loggning och dataanalys kan användas för att spåra åtkomst och förändringar av applikationers tillstånd, övervakning, debug och säkerhetsunderhåll. Till exempel, efter upptäckten av obehörig åtkomst till systemet kan man genom att köra SQL-frågor bestämma omfattningen av läckan, genom att identifiera alla operationer som genomförts av processer som fått åtkomst till konfidentiell information.
Projektet har utvecklats i mer än ett år och är i stadiet av att skapa prototyper av olika komponenter i arkitekturen. För närvarande har en prototyp av tjänster som fungerar ovanpå databashanteringssystemet, såsom filsystem, IPC och planerare, förberetts, och det utvecklas också en programmiljö som erbjuder ett gränssnitt för att köra applikationer baserat på FaaS-modellen (function-as-a-service).
I nästa utvecklingsfas planeras det att tillhandahålla en fullständig programvarustack för distribuerade applikationer. VoltDB används som databas i experiment, men det pågår diskussioner om att skapa ett eget lager för datalagring eller att implementera saknade funktioner i befintliga databaser. Frågan om vilka komponenter som ska köras på kärnnivå och vilka som kan implementeras ovanpå databasen är också under diskussion.
Källa: opennet.ru
