

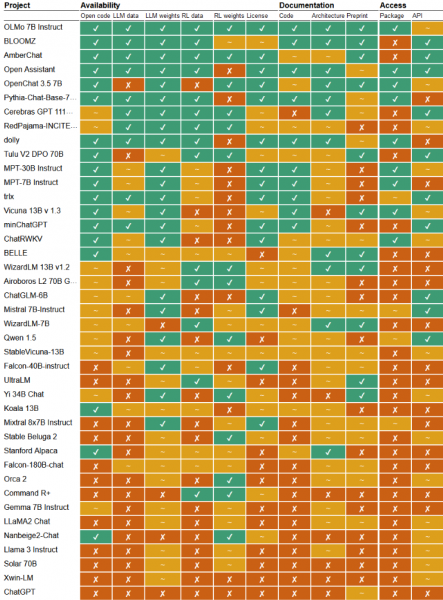
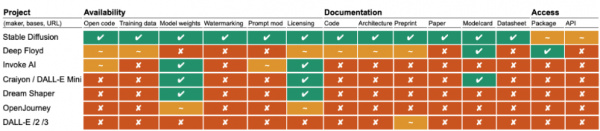
Forskare från Radboud universitetet i Nijmegen (Nederländerna) har sammanställt en rankning av öppenheten hos 40 stora språkmodeller och 7 modeller för att generera bilder från textbeskrivningar, som utges av tillverkarna som öppna. Eftersom kriterierna för öppenhet kring maskininlärningsmodeller fortfarande håller på att formas har en situation skapats där modeller som utger sig för att vara öppna ofta har licenser som begränsar användningsområdet (till exempel förbjuder många modeller användning i kommersiella projekt). Ofta tillhandahåller inte tillverkarna heller tillgång till de data som använts vid träningen, avslöjar inte implementeringsdetaljer eller öppnar helt den tillhörande koden.
De flesta modeller som marknadsförs som "öppna" bör i själva verket uppfattas som "öppna vikter" eller mer korrekt "åtkomliga vikter", eftersom de sprids under begränsade licenser som förbjuder användning i kommersiella produkter. Tredjepartsforskare kan experimentera med sådana modeller, men har ingen möjlighet att anpassa modellen efter sina behov eller inspektera implementeringen. Mer än hälften av modellerna tillhandahåller inte detaljerad information om de data som använts för träning, samt publicerar ingen information om den interna strukturen och arkitekturen.
De mest öppna modellerna är BloomZ, AmberChat, OLMo, Open Assistant och Stable Diffusion, som publicerats under öppna licenser tillsammans med källdata, kod och implementering av API. Modeller från Google (Gemma 7B), Microsoft (Orca 2) och Meta (Llama 3) som marknadsförs som öppna, hamnade längre ner på rankingen eftersom de inte tillhandahåller tillgång till källdata, avslöjar inte tekniska detaljer om implementeringen, och modellerna sprids under licenser som begränsar användningen. Den populära modellen Mistral 7B hamnade ungefär i mitten av rankingen, eftersom den levereras under en öppen licens, men är endast delvis dokumenterad, avslöjar inte de data som användes vid träning och har inte helt öppen tillhörande kod.
Forskare har föreslagit 14 kriterier för öppenhet av AI-modeller, som omfattar villkor för spridning av kod, träningsdata, vikter, datavarianter och koefficienter optimerade med hjälp av förstärkningsinlärning (RL), samt tillgång till färdiga paket, API:er, dokumentation och detaljerade implementeringsbeskrivningar.
I enlighet med det utkast till definition av öppen AI som föreslagits av OSI (Open Source Initiative) är de huvudsakliga kriterierna för öppenheten av ett AI-system att ge möjligheter till användning för alla ändamål utan behov av särskilt tillstånd; att studera systemets funktion och inspektera dess komponenter; att göra ändringar för alla syften; och att överföra både källversionen och redigerad version efter att ändringar gjorts.
För att möjliggöra ändringar måste AI-systemet inkludera:
- Detaljerad information om de data som användes för träning och träningsmetodologin. Informationen måste vara tillräcklig så att en professionell utvecklare kan återskapa ett motsvarande AI-system med hjälp av samma eller liknande data.
- Tillgång till källkoden, vilket möjliggör både att köra AI-systemet och genomföra dess träningsprocess (i tabellen ovan, i kolumnen "kod" är det angivet "~" för många modeller, vilket innebär partiell tillgång till koden, då koden för att köra modellen är tillgänglig men koden för att träna eller skapa modellen saknas). Koden bör också omfatta områden som förbearbetning, datakontroll och tokenisering. Dessutom bör en detaljerad beskrivning av modellens arkitektur tillhandahållas.
- Modellens parametrar (vikter), vilket innebär att det finns ett färdigt användningsbart tillstånd efter träning eller en slutlig optimerad version av modellen.
Källa: opennet.ru
