

Vi har gjort det!
Målet med den här kursen är att förbereda dig för din tekniska framtid.
 Hej, Habr. Kommer du ihåg den fantastiska artikeln (+219, 2588 i bokmärken, 429k läsningar)?
Så här är det med Hamming (ja, ja, självkorrigerande och självkontrollerande ) har det hela , skriven baserat på hans föreläsningar. Vi översätter den, för killen har poänger.
Det här är inte bara en bok om IT, det handlar om sättet att tänka på fantastiskt begåvade människor. Det handlar inte bara om att ha en positiv inställning; den beskriver de förhållanden som ökar chansen att göra stort arbete.
Tack till Andrey Pakhomov för översättningen.
Informationsteori utvecklades av C. E. Shannon i slutet av 1940-talet. Ledningen för Bell Laboratories insisterade på att han skulle kalla den "Kommunikationsteori", eftersom det var en betydligt mer exakt benämning. Av uppenbara skäl har namnet "Informationsteori" en mycket större påverkan på allmänheten, så Shannon valde det och det är det vi känner till idag. Själva namnet antyder att teorin handlar om information, och det är det som gör den viktig, eftersom vi alltmer fördjupar oss i informationsåldern. I detta kapitel kommer jag att ta upp några grundläggande slutsatser från denna teori, ge inte strikta, utan snarare intuitivt begripliga bevis för vissa enskilda påståenden i denna teori, så att ni förstår vad "Informationsteori" egentligen är, var ni kan tillämpa den och var ni inte kan.
Först och främst, vad är "information"? Shannon identifierar information med osäkerhet. Han valde den negativa logaritmen av sannolikheten för en händelse som ett mått på den information som du får när en händelse med sannolikhet p inträffar. Till exempel, om jag säger till dig att det är dimmigt väder i Los Angeles, då är p nära 1, vilket i stort sett inte ger oss mycket information. Men om jag säger att det regnar i Monterey i juni, så finns det osäkerhet i detta påstående och det innehåller mer information. En säker händelse innehåller ingen information, eftersom log 1 = 0.
Vi ska gå djupare in på detta. Shannon ansåg att den kvantitativa mått på information måste vara en kontinuerlig funktion av sannolikheten för händelsen p, och för oberoende händelser måste den vara additiv – mängden information erhållen från att utföra två oberoende händelser måste vara lika med mängden information erhållen från att utföra en gemensam händelse. Till exempel betraktas resultaterna av kast av tärningar och mynt vanligtvis som oberoende händelser. Låt oss översätta det ovanstående till matematikens språk. Om I(p) är mängden information som finns i en händelse med sannolikheten p, så för gemensam händelse som består av två oberoende händelser x med sannolikheten p1 och y med sannolikheten p2 får vi
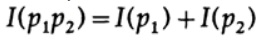
(x och y oberoende händelser)
Detta är Cauchys funktionella ekvation, sann för alla p1 och p2. För att lösa denna funktionella ekvation, antag att
p1 = p2 = p,
detta ger
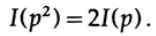
Om p1 = p2 och p2 = p, då
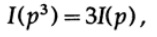
osv. Genom att utöka denna process, med hjälp av standardmetoden för exponenter, är följande sant för alla rationella tal m/n
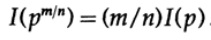
Från den antagna kontinuiteten i informationsmåttet följer att den logaritmiska funktionen är den enda kontinuerliga lösningen av Cauchys funktionella ekvation.
Inom informationsteori antas logaritmens bas vara 2, så en binär val innehåller exakt 1 bit information. Därför mäts information enligt formeln
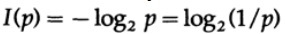
Låt oss stanna upp och se vad som har hänt ovan. För det första har vi fortfarande inte gett en definition av begreppet "information", vi har bara definierat formeln för dess kvantitativa mått.
För det andra beror detta mått på osäkerhet, och även om det är tillräckligt lämpligt för maskiner – till exempel telefon- och radiosystem, television, datorer osv. – så återspeglar det inte det normala mänskliga förhållandet till information.
För det tredje är detta ett relativt mått, det beror på ditt nuvarande tillstånd av kunskap. Om du tittar på en ström av "slumptal" från en slumptalsgenerator, antar du att varje följande nummer är osäkert, men om du känner till formeln för att beräkna "slumptalen", kommer nästa nummer att vara känt och därmed kommer det inte att innehålla någon information.
Således passar den definition av information som Shannon ger många gånger för maskiner, men verkar inte överensstämma med människors förståelse av detta ord. Just av denna anledning borde "Informationsteorin" ha kallats "Kommunikationsteorin". Ändå är det redan för sent att ändra definitioner (som gjorde att teorin blev populär från början, och som fortfarande får människor att tro att denna teori handlar om "information"), därför måste vi acceptera dem, men du måste klart förstå hur långt Shannons definition av information avviker från dess allmänna betydelse. Shannons information handlar om något helt annat, nämligen osäkerhet.
Detta är något att tänka på när du föreslår någon terminologi. Hur väl överensstämmer den föreslagna definitionen, till exempel definitionen av information som ges av Shannon, med din ursprungliga idé och hur mycket avviker den? Nästan inget begrepp slutsatser exakt det som din tidigare uppfattning av konceptet, men i slutändan återspeglar den använda terminologin betydelsen av konceptet, så formaliseringen av något genom tydliga definitioner skapar alltid lite brus.
Låt oss överväga ett system vars alfabet består av symboler q med sannolikheter pi. I detta fall den genomsnittliga mängden information i systemet (dess förväntade värde) är lika med:
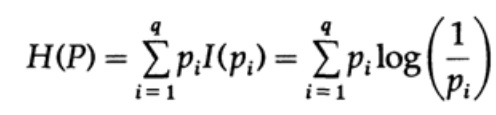
Detta kallas entropin hos systemet med sannolikhetsfördelningen {pi}. Vi använder termen "entropi" eftersom samma matematiska form dyker upp inom termodynamik och statistisk mekanik. Det är därför termen "entropi" skapar en viss aura av betydelse omkring sig, vilken i slutändan inte är berättigad. Att ha samma matematiska form av registrering betyder inte att symbolerna tolkas på samma sätt!
Entropin av sannolikhetsfördelningen spelar en central roll i kodningsteorin. Gibbs olikhet för två olika sannolikhetsfördelningar pi och qi är en av de viktiga följderna av denna teori. Så vi måste bevisa att
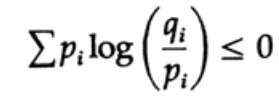
Beviset bygger på den uppenbara grafen, fig. 13.I, som visar att
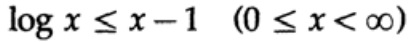
och likhet uppnås endast när x = 1. Låt oss tillämpa olikheten på varje term i summan från den vänstra sidan:
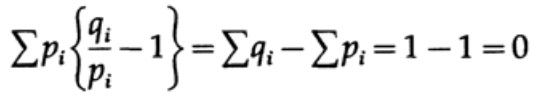
Om alfabetet i kommunikationssystemet består av q symboler, så genom att anta att sannolikheten för att överföra varje symbol är qi = 1/q och sätta in q, får vi från Gibbs olikhet.
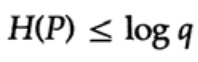
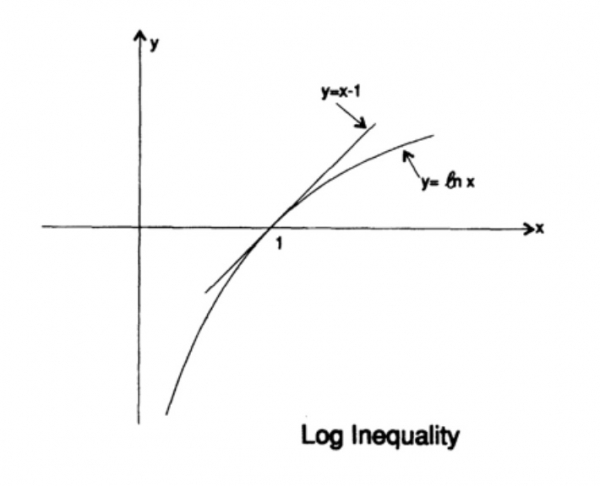
Figur 13.I
Detta innebär att om sannolikheten för att överföra alla q symboler är samma och lika med 1 / q, så är den maximala entropin lika med ln q. Annars gäller olikheten.
I fallet med ett entydigt avkodningsbart kodsystem har vi Krafts olikhet.
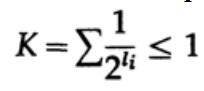
Nu, om vi definierar pseudoproblemen
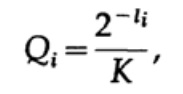
där det är begränsat 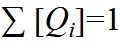 = 1, vilket följer av Gibbs olikhet,
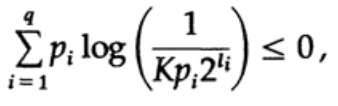
och tillämpar lite algebra (kom ihåg att K ≤ 1, så vi kan utelämna den logaritmiska termen och eventuellt förstärka olikheten senare), får vi
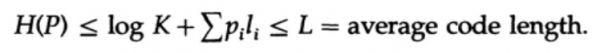
där L är den genomsnittliga längden på koden.
Således är entropi den minimiövre gränsen för varje teckenbaserat kodsystem med en genomsnittlig kodordslängd L. Detta är Shannons teorem för en pålitlig kanal.
Nu betraktar vi huvudteoremet om begränsningar i kommunikationssystem där information överförs som en ström av oberoende bitar och där brus förekommer. Det antas att sannolikheten för korrekt överföring av en bit P > 1 / 2, och sannolikheten för att bitens värde kommer att inverteras under överföringen (ett fel inträffar) är Q = 1 - P. För bekvämlighet antas vi att felen är oberoende och felaktigheten är densamma för varje skickad bit - det vill säga att det finns
En lång ström av n bitar, kodade som ett meddelande - n-dimensionell expansion av en-bitars koden. Värdet n fastställs senare. Vi betraktar meddelandet som består av n bitar som en punkt i ett n-dimensionellt rum. Eftersom vi har ett n-dimensionellt rum - och för enkelhetens skull kommer vi att anta att varje meddelande har samma sannolikhet för uppkomst - finns det M möjliga meddelanden (M kommer också att definieras senare), föregår därför sannolikheten för varje skickat meddelande

(avsändare)
Diagram 13.II
Vi kommer nu att diskutera idén om kanalens bandbredd. Utan att gå in på detaljer definieras bandbredden som den maximala mängden information som kan överföras på ett pålitligt sätt över kommunikationskanalen, med beaktande av användningen av det mest effektiva kodningsförfarandet. Det finns inga bevis för att mer information kan överföras genom en kommunikationskanal än dess kapacitet. Detta kan bevisas för en binär symmetrisk kanal (som vi använder i vårt fall). Kanalens kapacitet vid bit-för-bit överföring ges som
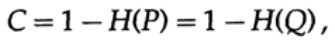
där, som tidigare, P är sannolikheten för att det inte förekommer ett fel i någon av de skickade bitarna. Vid överföring av n oberoende bitar definieras kanalens kapacitet som
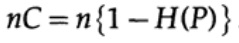
Om vi är nära kanalens bandbredd, måste vi skicka nästan den mängd information för varje symbol ai, i = 1, …, M. Med beaktande av att sannolikheten för varje symbol ai är 1 / M, får vi
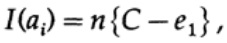
när vi skickar något av de M likasannolika meddelandena ai, har vi
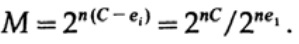
Vid överföring av n bitar förväntar vi oss att nQ fel kommer att inträffa. I praktiken, för ett meddelande som består av n bitar, kommer vi att ha ungefär nQ fel i det mottagna meddelandet. För stora n kommer den relativa variationen (variation = bredden på fördelningen,)
fördelningen av antalet fel blir allt snävare med ökande n.
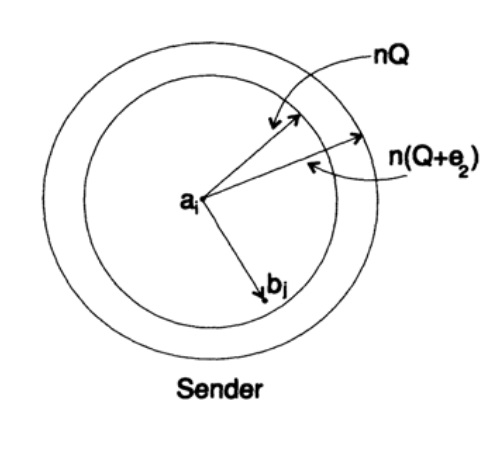
Så, från sändarens sida, tar jag meddelandet ai för att skicka det och drar en sfär runt det med en radie av
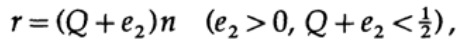
som är lite större med en mängd lika med e2 än det förväntade antalet fel Q, (figur 13.II). Om n är tillräckligt stort, finns det en godtyckligt liten sannolikhet för att meddelandepunkten bj på mottagarens sida kommer att hamna utanför denna sfär. Låt oss avbilda situationen som jag ser den från sändarens perspektiv: vi har vilka radier som helst från det skickade meddelandet ai till det mottagna meddelandet bj med en fel sannolikhet som är (eller nästan är) normalfördelad, vilket når sin topp vid nQ. För vilken given e2 som helst finns det ett n som är så stort att sannolikheten för att punkten bj, som ligger utanför min sfär, kommer att vara så liten som du vill.
Låt oss nu titta på samma situation från din sida (figur 13.III). På mottagarens sida finns en sfär S( r) med samma radie r runt den mottagna punkten bj i n-dimensionellt rum, så att om det mottagna meddelandet bj ligger inom min sfär, då ligger det meddelande som jag skickat ai inom din sfär.
Hur kan ett fel uppstå? Fel kan uppstå i de fall som beskrivs i tabellen nedan:
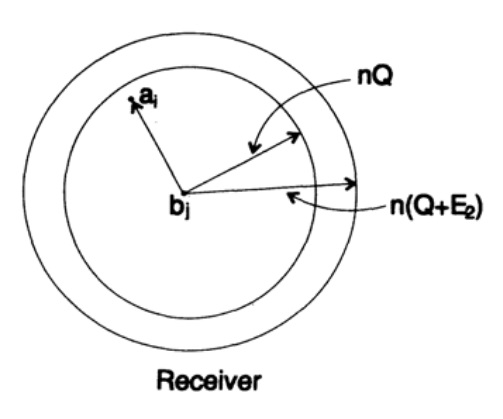
Figur 13.III
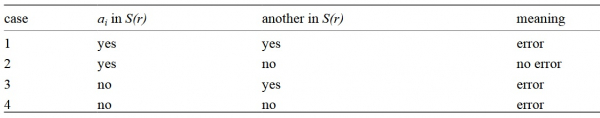
Här ser vi att om det finns minst en annan punkt inom sfären som byggts runt den mottagna punkten, som motsvarar ett möjligt skickat okodat meddelande, så har ett fel inträffat under överföringen, eftersom du inte kan avgöra vilket av dessa meddelanden som faktiskt har skickats. Det skickade meddelandet innehåller inget fel om och endast om punkten som motsvarar det ligger i sfären och det inte finns några andra punkter, möjliga i detta kod, som ligger i samma sfär.
Vi har en matematisk ekvation för fel sannolikhet Pe, om ett meddelande ai har skickats.
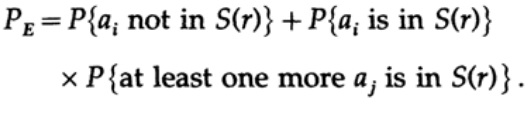
Vi kan bortse från den första faktorn i det andra ledet och anta att den är 1. Således får vi en olikhet.
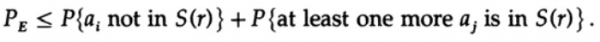
Det är uppenbart att
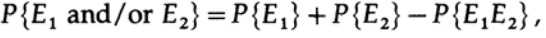
därför
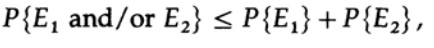
återanvänder vi för det sista ledet till höger.
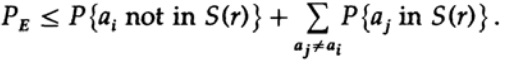
Genom att anta att n är tillräckligt stort, kan den första termen antas vara hur liten som helst, säg, mindre än ett visst tal d. Således har vi
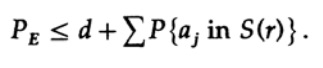
Låt oss nu överväga hur man kan bygga en enkel substitutionskod för att koda M meddelanden bestående av n bitar. Utan att ha en uppfattning om hur man bygger koden (koder för felkorrigering hade ännu inte uppfunnits), valde Shannon att använda slumpmässig kodning. Kast mynt för varje av de n bitarna i meddelandet och upprepa processen för M meddelanden. Totalt måste nM myntkast genomföras, så det är möjligt

kodordböcker som har samma sannolikhet ½nM. Naturligtvis innebär den slumpmässiga processen av att skapa en kodordbok att det finns en sannolikhet för dubbletter, samt kodpunkter som kommer att vara nära varandra och därmed kommer att vara en källa till sannolika fel. Det måste bevisas att om detta inte inträffar med en sannolikhet högre än någon liten vald felprocent, så är det givna n tillräckligt stort.
Det avgörande ögonblicket ligger i att Shannon genomsnittade alla möjliga kodböcker för att hitta det genomsnittliga felet! Vi kommer att använda symbolen Av [.], för att beteckna medelvärdet över en mängd av alla möjliga slumpmässiga kodordssamlingar. Att medelvärdera över konstanten d ger naturligtvis en konstant, eftersom varje medlem i medelvärdet överensstämmer med varje annan medlem i summan.
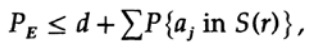
som kan ökas (M–1 går till M)
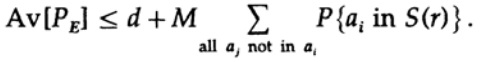
För vilket specifikt meddelande som helst, när man genomsnittar alla kodböcker, kör kodningen genom alla möjliga värden, så den genomsnittliga sannolikheten att punkten ligger inom sfären är förhållandet mellan sfärens volym och den totala volymen av rummet. Volymen för sfären är
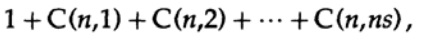
där s=Q+e2 <1/2 och ns måste vara ett heltal.
Det sista termerna till höger är det största i denna summa. Låt oss först uppskatta dess värde enligt Stirling-formeln för fakulteter. Därefter kommer vi att titta på minskningskoefficienten för termet före det, notera att denna koefficient ökar när man rör sig åt vänster, och därför kan vi: (1) begränsa värdet av summan till summan av en geometrisk serie med denna initiala koefficient, (2) utvidga den geometriska serien med ns led till oändligt antal led, (3) beräkna summan av den oändliga geometriska serien (standardalgebra, inget avgörande) och slutligen få gränsvärdet (för tillräckligt stort n):
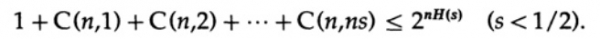
Observera hur entropin H(s) dök upp i det binomiska identiteten. Notera att Taylorserien H(s)=H(Q+e2) ger en uppskattning som erhålls med endast första derivatan och ignorera alla andra. Nu ska vi sätta ihop det slutliga uttrycket:
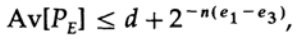
w
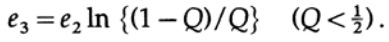
Allt vi behöver göra är att välja e2 så att e3 < e1, och då kommer den sista termen att bli hur liten som helst, vid tillräckligt stort n. Därför kan det genomsnittliga felet PE göras så litet som helst vid en kanalens bandbredd som är hur nära C som helst.
Om det genomsnittliga värdet för alla koder har en tillräckligt låg felmarginal, måste åtminstone en kod vara lämplig, vilket innebär att det finns åtminstone ett lämpligt kodningssystem. Detta är en viktig slutsats från Shannon – "Shannons teorem för brusiga kanaler", även om det bör påpekas att han bevisade detta för ett mycket mer allmänt fall än för den enkla binära symmetriska kanalen som jag har använt. För det allmänna fallet är de matematiska härledningarna mycket mer komplexa, men idéerna skiljer sig inte så mycket, så det är ofta möjligt att avslöja den sanna innebörden av teoremet genom att använda ett specifikt exempel.
Låt oss kritisera resultatet. Vi har upprepade gånger sagt: "Vid tillräckligt stora n". Men hur stort värde ska n vara? Väldigt, väldigt stort, om du verkligen vill vara nära kanalens kapacitet samtidigt som du är säker på att data överförs korrekt! Så stort att du i praktiken kommer att tvingas vänta mycket länge på att samla ett meddelande av så många bitar att du senare kan koda det. Samtidigt kommer storleken på ordboken för den slumpmässiga koden att vara oerhört stor (eftersom en sådan ordbok inte kan representeras i en kortare form än den fullständiga listan av alla Mn bitar, givet att n och M är mycket stora)!
Felkorrekteringskoder undviker att vänta på ett mycket långt meddelande, med dess efterföljande kodning och dekodning genom mycket stora kodböcker, eftersom de undviker kodböcker helt och hållet och istället använder vanliga beräkningar. I enkel teori förlorar sådana koder vanligtvis sin förmåga att närma sig kanalens kapacitet och samtidigt behålla en tillräckligt låg felkvot; men när en kod korrigerar ett stort antal fel ger de bra resultat. Med andra ord, om du avsätter en viss kapacitet för kanalen för felrättning, måste du använda felrättningskapaciteten det mesta av tiden, dvs i varje skickat meddelande måste ett stort antal fel korrigeras, annars slösar du bort denna kapacitet.
Ändå är teoremet ovan inte meningslöst! Det visar att effektiva överföringssystem måste använda väl genomtänkta kodningsscheman för mycket långa bitsekvenser. Ett exempel är satelliter som har rest bortom de yttre planeterna; när de avlägsnar sig från jorden och solen tvingas de rätta till allt fler fel i datablocket: vissa satelliter använder solpaneler som ger cirka 5 W, andra använder atomkraftkällor som ger ungefär samma effekt. Den svaga effekten från strömkällan, de små størrelserna på sändarparaboler och de begränsade storlekarna på mottagarparaboler på jorden, det enorma avståndet som signalen måste färdas — allt detta kräver användning av koder med hög felkorrigering för att bygga ett effektivt kommunikationssystem.
Låt oss återgå till det n-dimensionella rummet som vi använde i beviset ovan. Under diskussionen visade vi att nästan hela volymen av sfären är koncentrerad runt den yttre ytan - därmed kommer det nästan garanterat att den skickade signalen ligger vid ytan av sfären som byggts runt den mottagna signalen, även vid ett relativt litet radie av en sådan sfär. Därför är det inte förvånande att den mottagna signalen, efter att ha rättat ett godtyckligt stort antal fel, nQ, visar sig vara hur nära som helst till signalen utan fel. Kapaciteten hos kommunikationskanalen som vi diskuterade tidigare är nyckeln till att förstå detta fenomen. Observera att sådana sfärer, som byggs för Hamming-koder med felkorrigering, inte överlappar varandra. Ett stort antal praktiskt ortogonala mätningar i det n-dimensionella utrymmet visar varför vi kan anpassa M sfärer i rummet med litet överlapp. Om man tillåter ett litet, hur litet som helst, överlapp som bara kan leda till ett litet antal fel vid avkodning, kan man få en tät placering av sfärerna i rummet. Hamming garanterade en viss nivå av felkorrigering, Shannon – en låg felprocent, men med bevarad faktisk kapacitet som är hur nära som helst till kapaciteten hos kommunikationskanalen, något Hamming-koder inte kan göra.
Informationsteorin handlar inte om hur man designar effektiva system, men den pekar i riktning mot effektiva kommunikationssystem. Det är ett värdefullt verktyg för att bygga kommunikationssystem mellan maskiner, men som nämnts tidigare har det inte mycket att göra med hur människor utbyter information sinsemellan. I vilken utsträckning biologisk arv liknar tekniska kommunikationssystem är helt enkelt okänt, så för närvarande är det oklart hur tillämpbar informationsteorin är på gener. Vi har inget annat val än att försöka, och om framgång visar oss den maskinliknande karaktären hos fenomenet, kommer misslyckandet att peka på andra betydelsefulla aspekter av informationens natur.
Låt oss ta en liten avstickare. Vi har sett att alla ursprungliga definitioner, i större eller mindre utsträckning, måste uttrycka kärnan av våra ursprungliga övertygelser, men de är förenade med en viss grad av förvrängning och är därför inte tillämpbara. Det är traditionellt accepterat att slutligen det definiering vi använder faktiskt definierar essensen; men detta anger bara hur vi ska hantera saker och bär ingen betydelse för oss. Den postulativa ansatsen, som är så starkt godkänd inom matematiska kretsar, lämnar mycket att önska i praktiken.
Nu ska vi titta på ett exempel på IQ-test där definitionen är så cyklisk som du önskar, vilket i sin tur kan vara förvirrande. Ett test skapas som antas mäta intelligens. Därefter revideras det för att göras så konsekvent som möjligt och publiceras sedan, kalibrerat på ett enkelt sätt så att den mätta "intelligensen" blir normalt fördelad (naturligtvis enligt kalibreringskurvan). Alla definitioner måste dubbelkontrolleras, inte bara när de först föreslås utan även mycket senare när de används i de dragna slutsatserna. I vilken utsträckning är gränserna för definitionerna lämpliga för den aktuella uppgiften? Hur ofta börjar definitioner, som ges under vissa omständigheter, tillämpas i tillräckligt olika situationer? Detta inträffar ganska ofta! Inom humaniora, med vilka du oundvikligen kommer att ställas inför i ditt liv, händer detta oftare.
Därför var ett av syftena med denna presentation av informationsteori, förutom att demonstrera dess användbarhet, att varna er för denna fara, eller att visa hur man faktiskt använder den för att uppnå det önskade resultatet. Det har länge observerats att de initiala definitionerna i hög grad påverkar vad du faktiskt hittar i slutändan, mer än vad som verkar. De initiala definitionerna kräver att du är mycket uppmärksam, inte bara i nya situationer utan även inom områden där du har arbetat länge. Detta hjälper dig att förstå i vilken grad de resultat som erhållits är tautologier snarare än något användbart.
Den välkända historien om Eddington handlar om människor som fiskade i havet med ett nät. Efter att ha studerat storleken på de fiskar de fångade bestämde de det minimi mått som en fisk kan ha i havet! Deras slutsats var beroende av det använda verktyget, inte av verkligheten.
Fortsättning följer…
Den som vill hjälpa till med översättning, layout och publicering av boken — skriv till mig i privatmeddelande eller på e-post magisterludi2016@yandex.ru
Förresten, vi har även lanserat översättningen av en annan fantastisk bok — )
Vi letar särskilt efter dem som kan hjälpa till att översätta . (vi översätter i 10-minuterssegment, de första 20 har vi redan tagit)
Innehållet i boken och de översatta kapitlen
- Intro till The Art of Doing Science and Engineering: Learning to Learn (28 mars 1995)
- «Foundations of the Digital (Discrete) Revolution» (30 mars 1995)
- «Historien om datorer — Hårdvara» (31 mars 1995)
- «Historien om datorer — Programvara» (4 april 1995)
- «Historien om datorer — Appar» (6 april 1995)
- «Artificiell Intelligens — Del I» (7 april 1995)
- «Artificiell Intelligens — Del II» (11 april 1995)
- «Artificiell Intelligens III» (13 april 1995)
- «n-Dimensionellt Rum» (14 april 1995)
- «Kodningsteori — Representation av information, Del I» (18 april 1995)
- «Kodningsteori — Representation av information, Del II» (20 april 1995)
- «Felrättande Koder» (21 april 1995)
- «Informationsteori» (25 april 1995)
- «Digitala Filter, Del I» (27 april 1995)
- «Digitala Filter, Del II» (28 april 1995)
- «Digitala Filter, Del III» (2 maj 1995)
- «Digitala Filter, Del IV» (4 maj 1995)
- «Simulation, Del I» (5 maj 1995)
- «Simulation, Del II» (9 maj 1995)
- «Simulation, Del III» (11 maj 1995)
- «Fiberoptik» (12 maj 1995)
- «Datorstödd Undervisning» (16 maj 1995)
- «Matematik» (18 maj 1995)
- «Kvantmekanik» (19 maj 1995)
- «Kreativitet» (23 maj 1995). Översättning:
- «Experter» (25 maj 1995)
- «Otillförlitliga Data» (26 maj 1995)
- «Systemteknik» (30 maj 1995)
- «Du får vad du mäter» (1 juni 1995)
- (2 juni 1995) översätter i 10-minuters block
- Hamming, «Du och din forskning» (6 juni 1995).
Den som vill hjälpa till med översättning, layout och publicering av boken — skriv till mig i privatmeddelande eller på e-post magisterludi2016@yandex.ru
Källa: habr.com
