

SciPy (uttalas som "sai pai") är ett paket med tillämpade matematiska procedurer som bygger på Numpy Python. Med SciPy förvandlas en interaktiv Python-session till en fullvärdig miljö för databehandling och prototyptillverkning av komplexa system, liknande MATLAB, IDL, Octave, R-Lab och SciLab. Idag vill jag kort berätta om hur man bör tillämpa vissa kända optimeringsalgoritmer i paketet scipy.optimize. Mer detaljerad och aktuell information om användningen av funktioner kan alltid fås med hjälp av kommandot help() eller med hjälp av Shift+Tab.
Introduktion
För att spara mig själv och läsarna besväret med att söka och läsa originalkällor, kommer referenserna till metodbeskrivningarna huvudsakligen att vara till Wikipedia. Som regel är denna information tillräcklig för att få en allmän förståelse av metoderna och villkoren för deras tillämpning. För att förstå de matematiska metodernas kärna går vi via länkar till mer auktoritativa publikationer som går att hitta i slutet av varje artikel eller i din favoritsökmotor.
Modulen scipy.optimize innehåller implementeringen av följande procedurer:
- Villkorlig och ovillkorlig minimering av skalära funktioner med flera variabler (minim) med hjälp av olika algoritmer (Nelder-Mead simplex, BFGS, Newtons konjugerade gradienter, och )
- Global optimering (till exempel: , )
- Minimering av residualer (least_squares) och algoritmer för kurvpassning med icke-linjär MNLK (curve_fit)
- Minimering av skalära funktioner med en variabel (minim_scalar) och rotletande (root_scalar)
- Mångdimensionella lösare för ekvationssystem (root) med hjälp av olika algoritmer (hybrid Powell, eller storskaliga metoder, såsom ).
I denna artikel kommer vi enbart att behandla den första punkten i hela denna lista.
Ovillkorlig minimering av en skalär funktion med flera variabler
Funktionen minim från paketet scipy.optimize erbjuder ett allmänt gränssnitt för att lösa problem med villkorlig och ovillkorlig minimering av skalära funktioner med flera variabler. För att demonstrera dess funktionalitet behöver vi en lämplig funktion med flera variabler som vi kommer att minimera på olika sätt.
För dessa syften är Rosenbrokks funktion med N variabler av mycket god passform, som har följande form:

Trots att Rosenbrock-funktionen och dess Jacobi- och Hessianmatriser (första och andra derivatan) redan är definierade i scipy.optimize, låt oss definiera den själva.
import numpy as np

def rosen(x):
    """Rosenbrock-funktionen"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
För tydlighetens skull, låt oss rita ut värdena för Rosenbrock-funktionen i 3D för två variabler.
Koden för att rita ut
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Ställer in 3D-diagrammet
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Ställ in vyvinkeln
ax.view_init(45, 30)

# Skapa data för diagrammet
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Rita ytan
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
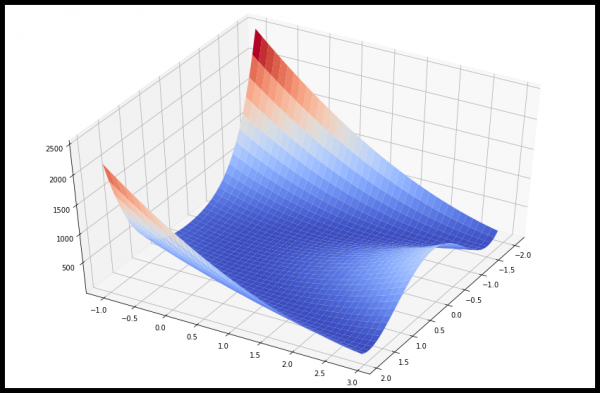
Genom att veta att minimi värdet är 0 för  , låt oss titta på exempel på hur man kan bestämma minimivärdet för Rosenbrock-funktionen med olika procedurer i scipy.optimize.
Nelder-Mead simplexmetod
Anta att vi har en startpunkt x0 i ett 5-dimensionellt rum. Låt oss hitta den närmaste minimumpunkten för Rosenbrock-funktionen med hjälp av algoritmen (algoritmen anges som värde på parametern method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimering avslutades framgångsrikt.
Nuvarande funktionsvärde: 0.000000
Iterationer: 339
Funktionsutvärderingar: 571
[1. 1. 1. 1. 1.]Simplexmetoden är det enklaste sättet att minimera en tydligt definierad och ganska slät funktion. Den kräver inte att funktionens derivator beräknas, det räcker med att bara ange dess värden. Nelder-Mead metoden är ett bra val för enkla minimaliseringsproblem. Men eftersom den inte använder gradientuppskattningar kan det ta längre tid att hitta minimivärdet.
Powell-metoden
En annan optimeringsalgoritm där endast funktionsvärden beräknas är . För att använda den, sätt method = ‘powell’ i minim-funktionen.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimering avslutades framgångsrikt.
Nuvarande funktionsvärde: 0.000000
Iterationer: 19
Funktionsutvärderingar: 1622
[1. 1. 1. 1. 1.]Broyden-Fletcher-Goldfarb-Shanno-algoritmet (BFGS)
För att uppnå snabbare konvergens till lösningen, utförs proceduren använder gradienten av målfunktionen. Gradient kan anges som en funktion eller beräknas med hjälp av förstahandsdifferenser. I vilket fall som helst kräver BFGS-metoden vanligtvis färre funktionsanrop än simplexmetoden.
Låt oss beräkna derivatan av Rosenbrock-funktionen analytiskt:


Detta uttryck är giltigt för derivator av alla variabler, utom den första och sista, som definieras som:


Låt oss titta på en Python-funktion som beräknar denna gradient:
def rosen_der (x):
    xm = x [1: -1]
    xm_m1 = x [: - 2]
    xm_p1 = x [2:]
    der = np.zeros_like (x)
    der [1: -1] = 200 * (xm-xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1-xm)
    der [0] = -400 * x [0] * (x [1] -x [0] ** 2) - 2 * (1-x [0])
    der [-1] = 200 * (x [-1] -x [-2] ** 2)
    return der
Gradientberäkningsfunktionen anges som värdet på parametern jac i minim-funktionen, som visas nedan.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Optimering avslutades framgångsrikt.
Nuvarande funktionsvärde: 0.000000
Iterationer: 25
Funktionsutvärderingar: 30
Gradientutvärderingar: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]Algoritm för kongruenta gradienter (Newton)
Algoritm är en modifierad Newton-metod.
Newton-metoden är baserad på att approximera funktionen i ett lokalt område med ett polynom av andra graden:

w  är Hessianmatrisen (andra derivatornas matris).
Om Hessianen är positivt definit kan det lokala minimum av denna funktion hittas genom att sätta gradienten av kvadratisk form till noll. Resultatet blir ett uttryck:

Den inverterade Hessian beräknas med hjälp av kongruenta gradientmetoden. Här är ett exempel på användning av denna metod för att minimera Rosenbrock-funktionen. För att använda Newton-CG-metoden måste en funktion anges som beräknar Hessian.
Hessianen av Rosenbrock-funktionen i analytisk form är lika med:


w  och
 , definierar matrisen
 .
De övriga icke-noll elementen i matrisen är lika med:


Till exempel, i femdimensionellt rum N = 5, har Hessianmatrisen för Rosenbrock-funktionen ett bandformat:

Koden som beräknar denna Hessian tillsammans med koden för att minimera Rosenbrock-funktionen med hjälp av kongruenta gradientmetoden (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimering avslutad framgångsrikt.
Nuvarande funktionsvärde: 0.000000
Iterationer: 24
Funktionsutvärderingar: 33
Gradientutvärderingar: 56
Hessianutvärderingar: 24
[1. 1. 1. 0.99999999 0.99999999]Exempel med definition av Hessianprodukten och en godtycklig vektor
I verkliga uppgifter kan beräkning och lagring av hela Hessianmatrisen kräva betydande resurser i tid och minne. Det är faktiskt inte nödvändigt att definiera själva Hessianmatrisen, eftersom för minimeringsproceduren behövs endast en vektor som är lika med produkten av Hessianen med en annan godtycklig vektor. Därför är det ur beräkningssynpunkt mycket mer fördelaktigt att direkt definiera en funktion som returnerar resultatet av produktens beräkning av Hessianen med en godtycklig vektor.
Låt oss titta på funktionen hess, som tar minimeringsvektorn som första argument, och en godtycklig vektor som det andra argumentet (tillsammans med andra argument i den minimerade funktionen). I vårt fall är det inte särskilt svårt att beräkna produkten av Hessianen för Rosenbrockfunktionen med en godtycklig vektor. Om p är en godtycklig vektor, så har produkten  följande uttryck:

Funktionen som beräknar produkten av Hessianen och en godtycklig vektor skickas som värdet av argumentet hessp i funktionen minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
Optimering avslutad framgångsrikt.
         Nuvarande funktionsvärde: 0.000000
         Iterationer: 24
         Funktionsutvärderingar: 33
         Gradientutvärderingar: 56
         Hessianutvärderingar: 66
Algoritm för förtroendeområde (trust region) för konjugerade gradienter (Newton)
En dålig konditionering av Hessianmatrisen och felaktiga sökriktningar kan leda till att algoritmen för konjugerade gradienter enligt Newton kan bli ineffektiv. I sådana fall föredras (trust-region) för konjugerade gradienter för Newton.
Exempel med definition av Hessianmatris:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimering avslutades framgångsrikt.
Aktuellt funktionsvärde: 0.000000
Iterationer: 20
Funktionsutvärderingar: 21
Gradientutvärderingar: 20
Hessianutvärderingar: 19
[1. 1. 1. 1. 1.]Exempel med produkten av hessianen och en godtycklig vektor:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimering avslutades framgångsrikt.
Aktuellt funktionsvärde: 0.000000
Iterationer: 20
Funktionsutvärderingar: 21
Gradientutvärderingar: 20
Hessianutvärderingar: 0
print(res.x)
[1. 1. 1. 1. 1.]Krylovtypmetoder
Likt trust-ncg-metoden är Krylovtypmetoder väl lämpade för att lösa storskaliga problem, eftersom de endast använder matris-vektor-produkter. Deras kärna är att lösa problemet inom ett förtroendeområde som begränsas av ett avkortat Krylov-subrum. För odefinierade problem är det bättre att använda denna metod, då den kräver färre icke-linjära iterationer på grund av färre matris-vektor-produkter per delproblem, jämfört med trust-ncg-metoden. Dessutom är lösningen för det kvadratiska delproblemet mer exakt än med trust-ncg.
Exempel med definition av Hessianmatris:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Optimering avslutades framgångsrikt.
         Aktuellt funktionsvärde: 0.000000
         Iterationer: 19
         Funktionsutvärderingar: 20
         Gradientutvärderingar: 20
         Hessianutvärderingar: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Exempel med produkten av hessianen och en godtycklig vektor:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Optimering avslutades framgångsrikt.
         Aktuellt funktionsvärde: 0.000000
         Iterationer: 19
         Funktionsutvärderingar: 20
         Gradientutvärderingar: 20
         Hessianutvärderingar: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritm för approximativ lösning inom ett förtroendeområde
Alla metoder (Newton-CG, trust-ncg och trust-krylov) är väl lämpade för att lösa storskaliga problem (med tusentals variabler). Detta beror på att den underliggande algoritmen för konjugerade gradienter innebär en approximativ beräkning av den omvända Hessian-matrisen. Lösningen hittas iterativt, utan ett explicit förfarande för Hessianen. Eftersom det endast krävs att definiera en funktion för produkten av Hessianen och en godtycklig vektor, är denna algoritm särskilt bra för arbete med sparsamma (band-diagonala) matriser. Detta ger låg minnesanvändning och betydande tidsbesparingar.
I medelstora problem är kostnaderna för lagring och faktorisering av Hessianen inte avgörande. Detta innebär att man kan få en lösning med färre iterationer genom att lösa deluppgifter i nästan exakt område. För detta löses vissa icke-linjära ekvationer iterativt för varje kvadratisk deluppgift. En sådan lösning kräver vanligtvis 3 eller 4 Cholesky-faktoriseringar av Hessianmatrisen. Som ett resultat konvergerar metoden med färre iterationer och kräver färre funktionsutvärderingar jämfört med andra implementerade metoder för förtroendeområden. Denna algoritm förutsätter endast att hela Hessianmatrisen bestäms och stöder inte möjlighet att använda Hessianens produktfunktion och en godtycklig vektor.
Exempel på optimering av Rosenbrock-funktionen:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Optimering avslutades framgångsrikt.
Nuvarande funktionsvärde: 0.000000
Iterationer: 13
Funktionsutvärderingar: 14
Gradientutvärderingar: 13
Hessianutvärderingar: 14
array([1., 1., 1., 1., 1.])Vi stannar här. I nästa artikel ska jag försöka berätta det mest intressanta om villkorlig minimisering, tillämpningen av minimisering i lösningen av approximationsproblem, minimisering av en variabel, godtyckliga minimizörer och sökandet efter rötter i system av ekvationer med hjälp av paketet scipy.optimize.
Källa:
Källa: habr.com
