

I den här artikeln kommer vi att diskutera funktionella beroenden i databaser - vad det är, var det tillämpas och vilka algoritmer som finns för att hitta dem.
Vi kommer att betrakta funktionella beroenden i sammanhanget av relationella databaser. Om vi ska tala mycket förenklat, så lagras informationen i sådana databaser i form av tabeller. Vi kommer att använda ungefärliga begrepp som i strikt relationell teori inte är utbytbara: själva tabellen kallar vi en relation, kolumnerna - attribut (mängden av dessa - schemat för relationen), och mängden av värden i en rad på en delmängd av attribut är en tuppel.
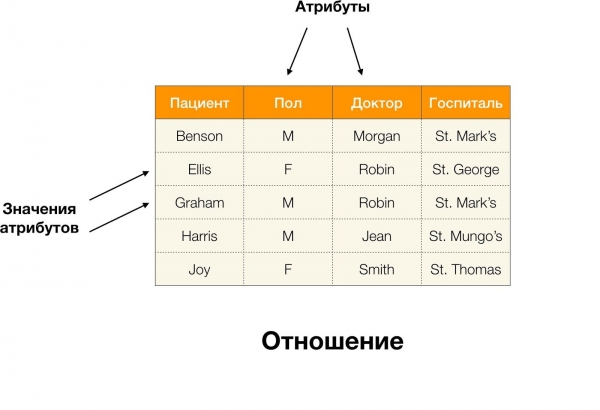
Till exempel, i tabellen ovan, (Benson, M, M organ) är en tuppel av attributen (Patient, Kön, Läkare).
Mer formellt skrivs detta på följande sätt:  [Patient, Kön, Läkare] = (Benson, M, M organ).
Nu kan vi införa begreppet funktionellt beroende (FB):
Definition 1. Relation R uppfyller FB X → Y (där X, Y ⊆ R) om och endast om för alla tupple  ,
 ∈ R gäller: om
 [X] =
 [X], då
 [Y] =
 [Y]. I så fall säger vi att X (determinant eller definierande mängd av attribut) funktionellt definierar Y (beroende mängd).
Med andra ord, existensen av FB X → Y betyder att om vi har två tupple i R och de överensstämmer med attributen X, så kommer de även att överensstämma med attributen Y.
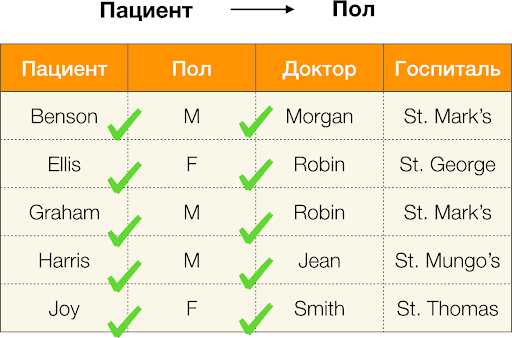
Och nu i ordning. Låt oss betrakta attributen Patient och Kön för vilka vi vill veta om det finns beroenden mellan dem eller inte. För en sådan uppsättning attribut kan följande beroenden existera:
- Patient → Kön
- Kön → Patient
Enligt definitionen ovan, för att den första beroendet ska hålla, måste varje unikt värde i kolumnen Patient ha ett motsvarande värde i kolumnen Kön. Och för exempel-tabellen är detta verkligen fallet. Men i den omvända riktningen fungerar det inte, det vill säga det andra beroendet uppfylls inte, och attributet Kön är inte en determinant för Patient.På samma sätt, om vi tar beroendet Läkare → Patient, kan vi observera att det bryts, eftersom värdet Robin för detta attribut har flera olika värden - Ellis och Graham.
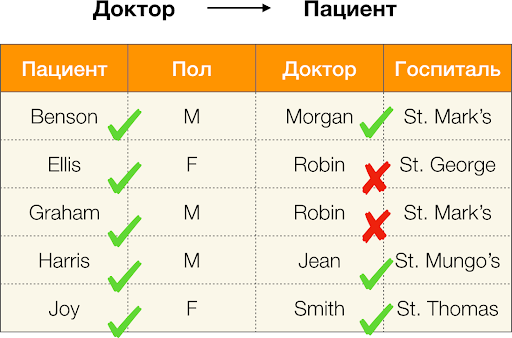
Därmed gör funktionella beroenden det möjligt att fastställa de befintliga relationerna mellan mängder av tabellattribut. Här framöver kommer vi att betrakta de mest intressanta relationerna, mer specifikt sådana X → Y, som är:
- icke-triviala, det vill säga att den högra delen av beroendet inte är en delmängd av den vänstra (Y ̸⊆ X);
- minimala, vilket innebär att det inte finns något sådant beroende Z → Y, att Z ⊂ X.
De beroenden vi tidigare har diskuterat var strikta, det vill säga de förutsatte inga brott mot tabellen, men bortom dessa finns det också sådana som tillåter viss inkonsekvens mellan värdena i tupler. Dessa beroenden placeras i en separat klass, kallas approximativa och tillåts att brytas på ett visst antal tupler. Detta antal regleras av den maximala felprocenten emax. Till exempel, en felandel  = 0,01 kan betyda att beroendet får brytas i 1% av de befintliga tuplerna i den aktuella mängden av attribut. Det vill säga för 1000 poster kan maximalt 10 tupler bryta mot det funktionella beroendet. Men vi kommer att betrakta en något annan metrisk baserad på parvis olika värden av de jämförda tuplerna. För beroendet X → Y på relationen är lika med noll. beräknas det så här:

Låt oss beräkna felet för Läkare → Patient från exemplet ovan. Vi har två tupler vars värden skiljer sig åt på attributet Patient, men överensstämmer på Doktorn:  [Doktor, Patient] = (Robin, Ellis) och
 [Doktor, Patient] = (Robin, Graham). Enligt feldefinitionen måste vi ta hänsyn till alla konfliktpar, vilket innebär att det finns två av dem: (
 ,
 ) och dess inversion (
 ,
 ). Låt oss sätta in i formeln och få:

Och nu försöker vi svara på frågan: "Vad är syftet med allt detta?" Faktum är att funktionella beroenden kan variera. Den första typen är sådana beroenden som definieras av administratören i designfasen av databasen. De är vanligtvis få, strikta och deras huvudsyfte är datanormalisering och design av relationsscheman.
Den andra typen är beroenden som representerar "dolda" data och tidigare okända relationer mellan attribut. Det vill säga, sådana beroenden tänktes inte på i designskedet och upptäcks först för en befintlig datamängd, för att sedan, baserat på ett stort antal upptäckta funktionella beroenden, dra slutsatser om den lagrade informationen. Det är just sådana beroenden vi arbetar med. Detta är ett helt område inom datautvinning med olika söktekniker och algoritmer byggda på dessa. Låt oss utforska hur de upptäckta funktionella beroendena (exakta eller approximativa) kan vara användbara i vissa data.
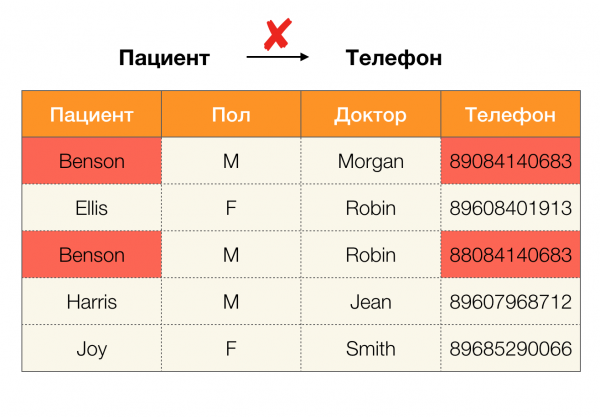
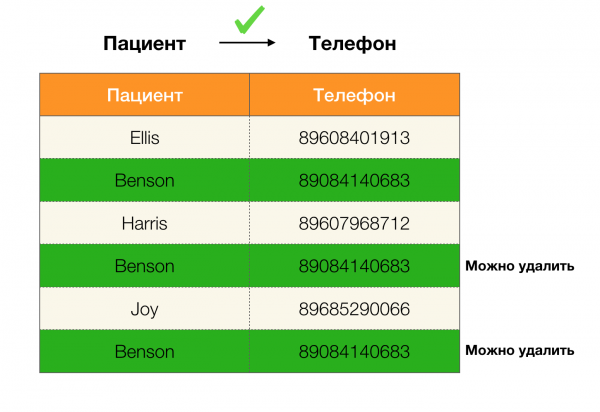
Idag identifieras datarensning bland de viktigaste tillämpningsområdena för beroenden. Det innebär utveckling av processer för att avslöja "smutsiga data" följt av rättelse. Framträdande exempel på "smutsiga data" är dubbletter, fel i data eller stavfel, saknade värden, föråldrade data, överflödiga mellanslag och liknande.
Exempel på fel i data:
Exempel på dubbletter i data:
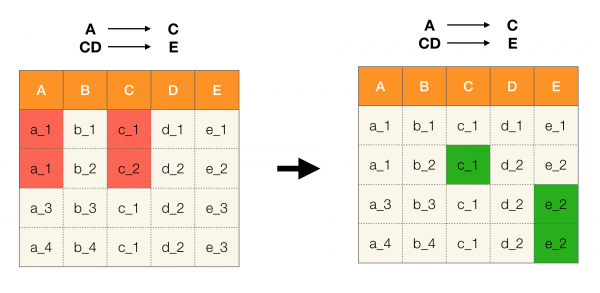
Till exempel har vi en tabell och ett antal funktionella beroenden som måste uppfyllas. Datarensning innebär i det här fallet att ändra data så att funktionella beroenden blir korrekta. Antalet modifieringar måste vara minimalt (det finns specifika algoritmer för denna procedur, som vi inte kommer att fokusera på i denna artikel). Nedan ges ett exempel på en sådan datatransformation. Till vänster visas den ursprungliga relationen, där det uppenbarligen inte uppfylls nödvändiga funktionella beroenden (exemplet på brott mot en av de funktionella beroendena markeras med röd färg). Till höger presenteras den uppdaterade relationen, där de gröna cellerna visar de ändrade värdena. Efter att ett sådant förfarande genomförts började nödvändiga beroenden att upprätthållas.
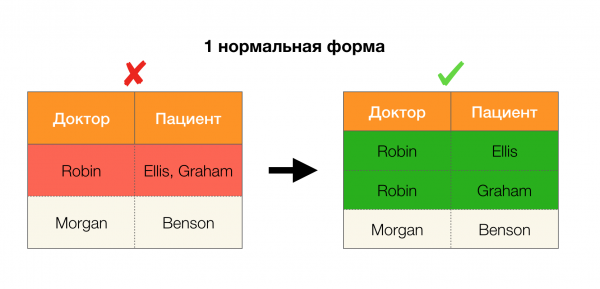
Ett annat populärt tillämpningsområde är databasdesign. Här är det viktigt att nämna normala former och normalisering. Normalisering är processen att anpassa en relation till ett visst antal krav, där varje krav definieras unikt av den normala formen. Vi kommer inte att beskriva kraven för de olika normala formerna (detta görs i varje bok om databaskurser för nybörjare), utan bara påpeka att var och en av dem använder konceptet funktionella beroenden på sitt sätt. För i grunden är funktionella beroenden (FD) begränsningar för integritet, som beaktas vid databasdesign (i detta sammanhang kallas FD ibland supernycklar).
Låt oss se deras tillämpning för de fyra normala formerna i bilden nedan. Kom ihåg att Boyce-Codd normalform är striktare än den tredje formen, men mindre strikt än den fjärde. Den sista kommer vi inte att betrakta för tillfället, eftersom förståelsen av mångvärdiga beroenden krävs för denna, vilket inte är vårt fokus i denna artikel.
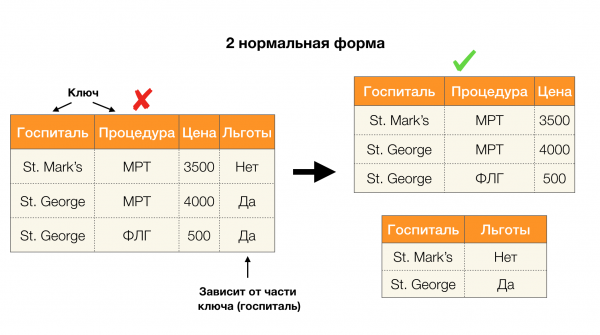
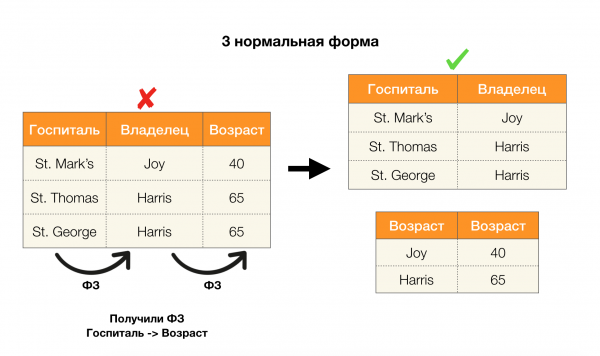
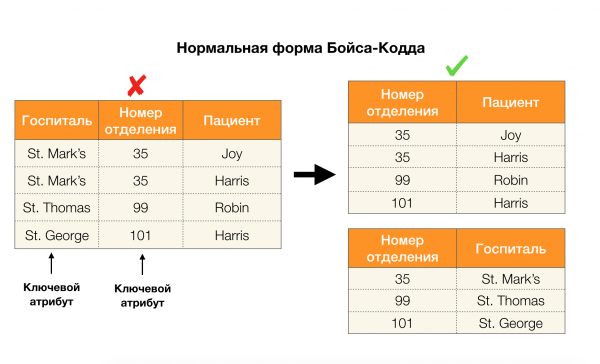
Ett annat område där beroenden har hittat sin tillämpning är minskning av dimensionerna i funktionsrummet för uppgifter som att bygga en naiv Bayesklassificerare, extrahera betydande funktioner och reparmetrisera ett regressionsmodell. I originalartiklar kallas denna uppgift för definiering av redundanta funktioner (feature redundancy) och relevanta (feature relevancy), och den löses med aktiv användning av databaskoncept. Med framväxten av sådana arbeten kan vi säga att det idag finns en efterfrågan på lösningar som kan kombinera databas, analys och genomförande av ovanstående optimeringsproblem i ett enda verktyg.
Det finns många algoritmer för att söka efter funktionella beroenden i datamängder (både moderna och mindre moderna). Dessa algoritmer kan delas in i tre grupper:
- Algoritmer som använder traversering av algebraiska gitter (Lattice traversal algorithms)
- Algoritmer som baseras på sökandet efter överenskomna värden (Difference- and agree-set algorithms)
- Algoritmer som baseras på parvisa jämförelser (Dependency induction algorithms)
En kort beskrivning av varje typ av algoritm presenteras i tabellen nedan:
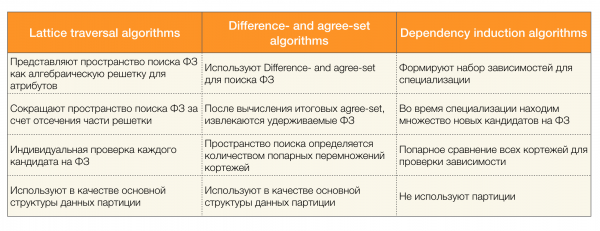
Mer om denna klassificering kan du läsa [4]. Nedan finns exempel på algoritmer för varje typ:
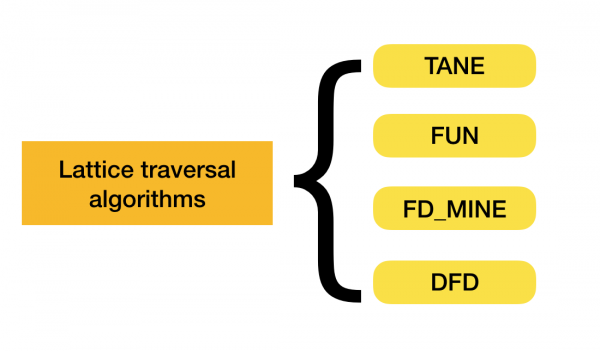
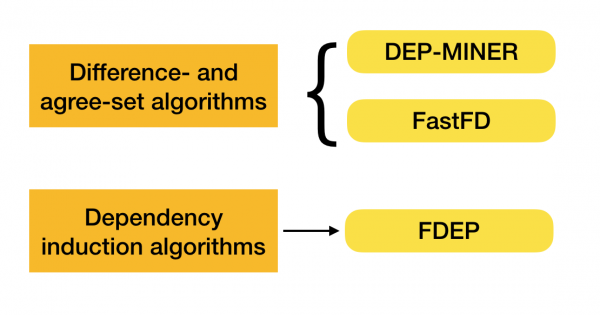
Det dyker nu upp nya algoritmer som kombinerar flera tillvägagångssätt för att identifiera funktionella beroenden. Exempel på sådana algoritmer är Pyro [2] och HyFD [3]. En djupare analys av deras funktion kommer att göras i följande artiklar i denna serie. I denna artikel kommer vi endast att gå igenom de grundläggande begreppen och lemman som är nödvändiga för att förstå teknikerna för att identifiera beroenden.
Vi börjar med det enkla — difference-set och agree-set, som används i den andra typen av algoritmer. Difference-set är en mängd tupler som inte överensstämmer i värden, medan agree-set å sin sida består av tupler som överensstämmer i värden. Det är värt att notera att vi i det här fallet endast betraktar den vänstra sidan av beroendet.
Ett viktigt begrepp som nämnts tidigare är den algebraiska latticen. Eftersom många moderna algoritmer arbetar med detta begrepp behöver vi ha en uppfattning om vad det är.
För att introducera begreppet lattice måste vi börja med definitionen av en delvis ordnad mängd (eller partially ordered set, förkortat — poset).
Definition 2. Det sägs att mängden S är delvis ordnad genom den binära relationen ⩽ om egenskaperna nedan gäller för alla a, b, c ∈ S:
- Reflexivitet, det vill säga a ⩽ a
- Antisymmetri, det vill säga om a ⩽ b och b ⩽ a, så är a = b
- Transitivitet, det vill säga för a ⩽ b och b ⩽ c gäller att a ⩽ c
En sådan relation kallas för en (icke-strikt) delordningsrelation, och mängden själv kallas en delvis ordnad mängd. Formellt betecknat: ⟨S, ⩽⟩.
Ett enkelt exempel på en delvis ordnad mängd är mängden av alla naturliga tal N med den vanliga ordningsrelationen ⩽. Det är lätt att verifiera att alla nödvändiga axiom uppfylls.
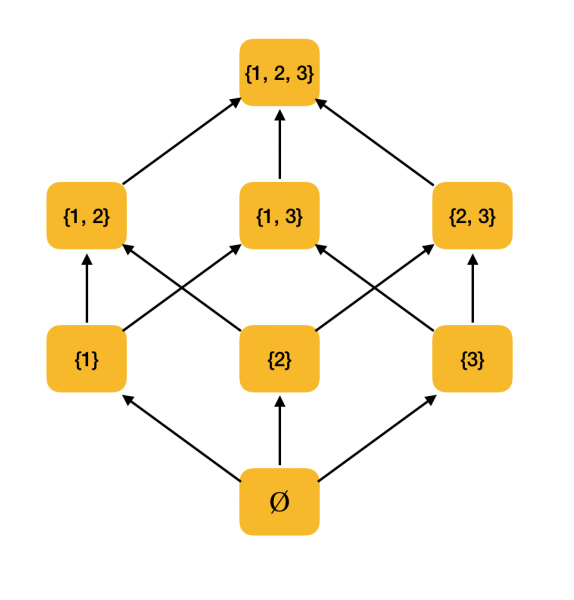
Ett mer innehållsrikt exempel. Låt oss betrakta mängden av alla delmängder {1, 2, 3}, ordnad genom inklusion ⊆. Faktum är att denna relation uppfyller alla villkor för delordning, så ⟨P ({1, 2, 3}), ⊆⟩ är en delvis ordnad mängd. Nedan visas strukturen av denna mängd: om man kan nå ett element från ett annat via pilarna, så är de i enordningsrelation.
Vi behöver ytterligare två enkla definitioner från matematikens område — supremum (supremum) och infimum (infimum).
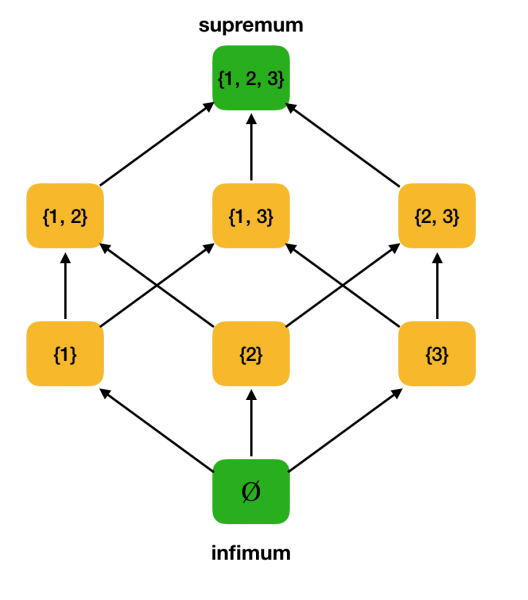
Definition 3. Låt ⟨S, ⩽⟩ vara en delvis ordnad mängd, A ⊆ S. En övre gräns för A är ett element u ∈ S, så att ∀x ∈ S: x ⩽ u. Låt U vara mängden av alla övre gränser för S. Om det finns ett minsta element i U, kallas det supremum och betecknas som sup A.
På liknande sätt introduceras begreppet exakt nedre gräns.
Definition 4. Låt ⟨S, ⩽⟩ vara en delvis ordnad mängd, A ⊆ S. En nedre gräns för A är ett element l ∈ S, så att ∀x ∈ S: l ⩽ x. Låt L vara mängden av alla nedre gränser för S. Om det finns ett största element i L, kallas det infimum och betecknas som inf A.
Låt oss ta det delvis ordnade mängden ⟨P ({1, 2, 3}), ⊆⟩ som exempel och hitta dess supremum och infimum:
Nu kan vi formulera definitionen av en algebraisk gitter.
Definition 5. Låt ⟨P, ⩽⟩ vara en delvis ordnad mängd där varje tvåelementsmängd har exakta övre och nedre gränser. Då kallas P för en algebraisk gitter. Här skrivs sup{x, y} som x ∨ y, och inf {x, y} som x ∧ y.
Vi kontrollerar att vårt arbetsprov ⟨P ({1, 2, 3}), ⊆⟩ är ett gitter. Faktiskt, för alla a, b ∈ P ({1, 2, 3}), är a∨b = a∪b, och a∧b = a∩b. Till exempel, ta mängderna {1, 2} och {1, 3} och hitta deras infimum och supremum. Om vi korsar dem får vi mängden {1}, vilket kommer att vara infimum. Supremum får vi genom att unionera dem — {1, 2, 3}.
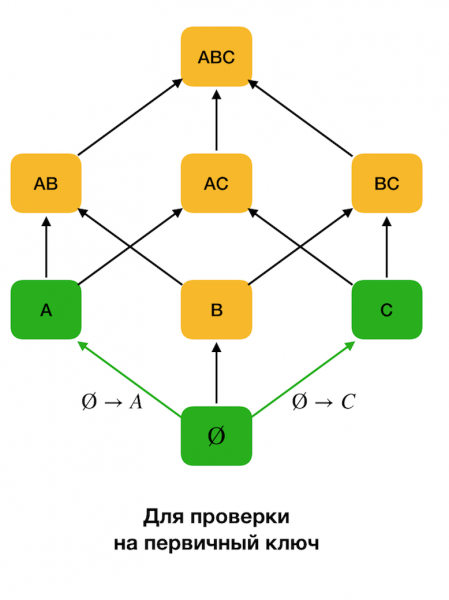
I algoritmer för att identifiera FDs representeras sökområdet ofta i form av ett gitter, där mängder med ett enda element (läs första nivån av sökgittern, där den vänstra delen av beroenden består av en enda attribut) representerar varje attribut i den ursprungliga relationen.
Till en början övervägs beroenden av typen ∅ → Ett ensamt attribut. Detta steg gör det möjligt att bestämma vilka attribut som är primära nycklar (för sådana attribut finns det inga determinanter, och därför är den vänstra delen tom). Vidare fortsätter sådana algoritmer att röra sig uppåt i gitret. Det är också värt att notera att gitret inte behöver genomsökas helt, det vill säga att om man matar in den önskade maximala storleken på den vänstra delen, så kommer algoritmen inte att gå längre än nivån med denna storlek.
I bilden nedan visas hur en algebraisk gitter kan användas i en problemställning för att söka efter FZ. Här representerar varje kant (X, XY) ett beroende X → Y. Till exempel har vi passerat första nivån och vet att beroendet hålls A → B (vi representerar detta med en grön koppling mellan noderna A och B). Således, när vi går vidare uppåt i gitteret, behöver vi inte kontrollera beroendet A, C → B, eftersom det redan inte kommer att vara minimalt. På liknande sätt skulle vi inte behöva kontrollera det om beroendet C → B.
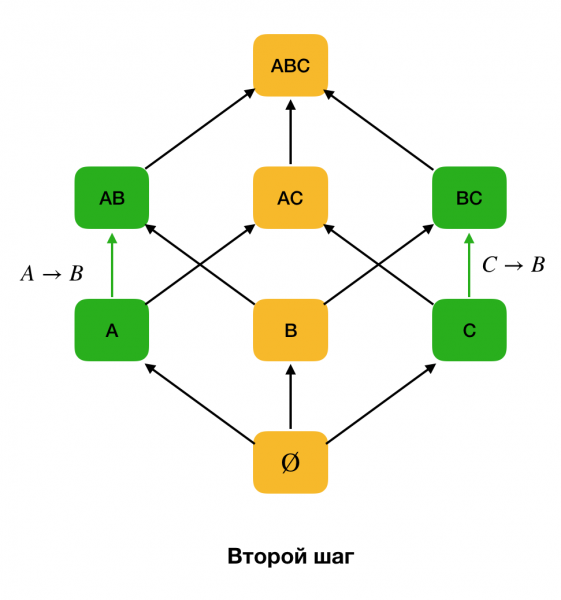
hålls. Dessutom använder alla moderna algoritmer för FZ-sökning vanligtvis en datastruktur som kallas partition (i originalet – stripped partition [1]). Den formella definitionen av partition ser ut på följande sätt:
Definition 6. Låt X ⊆ R vara en uppsättning attribut för relationen r. En kluster representerar en uppsättning index av tuple från r som har samma värde för X, det vill säga c(t) = {i|ti[X] = t[X]}. En partition är en mängd kluster som utesluter kluster av enhetslängd:

Enkelt uttryckt utgör partitionen för attributet X en uppsättning listor där varje lista innehåller radnummer med samma värden för X. I modern litteratur kallas strukturen som representerar partitioner för position list index (PLI). Kluster av enhetslängd utesluts för att komprimera PLI, eftersom det är kluster som endast innehåller numret på posten med ett unikt värde som alltid lätt kan fastställas.
Låt oss titta på ett exempel. Vi återvänder till samma tabell med patienter och bygger partitioner för kolumnerna Patient och Kön (en ny kolumn har lagts till till vänster, där radnumren i tabellen markeras):
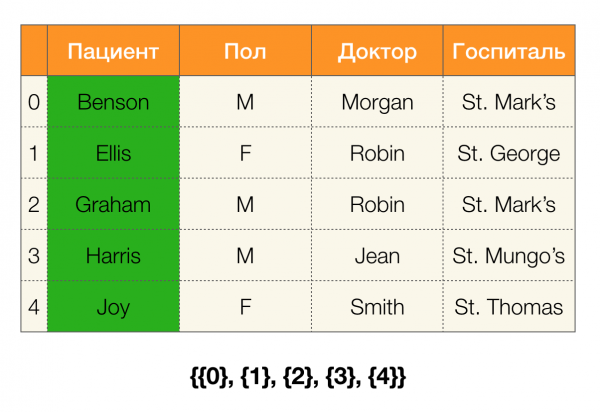
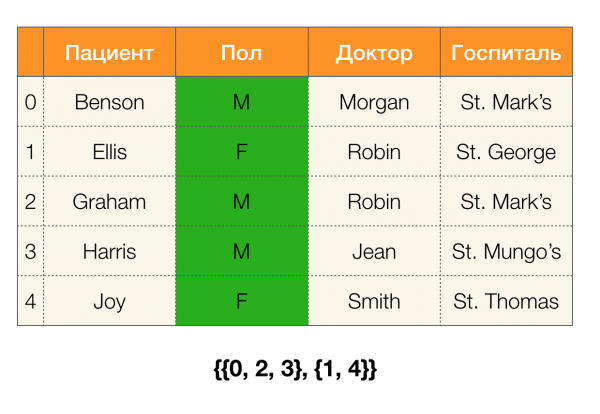
Därvid, enligt definitionen, kommer partitionen för kolumnen Patient faktiskt vara tom, eftersom enskilda kluster utesluts från partitionen.
Partitioner kan genereras baserat på flera attribut. För detta finns det två vägar: genom att gå igenom tabellen för att bygga en partition omedelbart för alla nödvändiga attribut, eller att bygga den med hjälp av operationen att korsa partitioner baserat på en delmängd av attribut. Algoritmer för FZ-sökning använder det andra alternativet.
Enkelt uttryckt, för att t.ex. få en partition för kolumnerna ABC, kan man ta partitionerna för AC och B (eller vilket annat uppsättning av icke-överlappande delmängder som helst) och korsa dem med varandra. En korskning av två partitioner identifierar de längsta kluster som är gemensamma för båda partitionerna.
Låt oss titta på ett exempel:
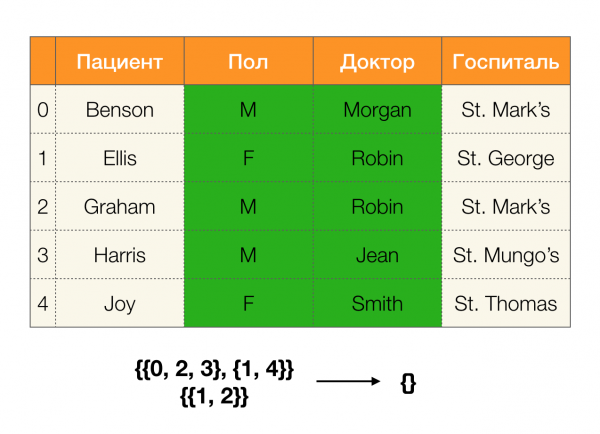
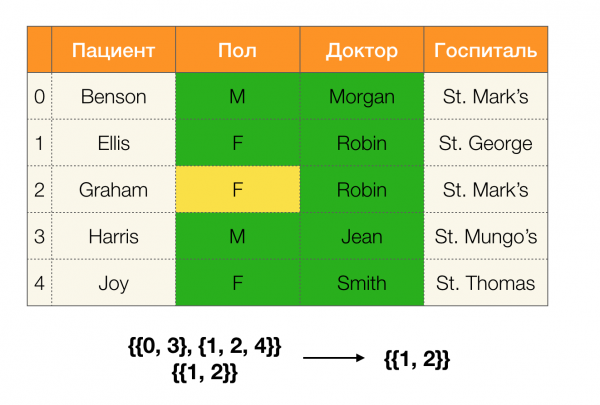
I det första fallet fick vi en tom partition. Om vi tittar närmare på tabellen finns det faktiskt inga identiska värden för de två attributen. Om vi istället modifierar tabellen något (fallet till höger), så får vi en icke-tom korsning. Här innehåller raderna 1 och 2 faktiskt samma värden för attributen. Kön och Doktor.
Därefter kommer vi att behöva begreppet partitionens storlek. Formellt:

Enklare uttryckt är partitionens storlek antalet kluster som ingår i partitionen (kom ihåg att enskilda kluster inte ingår i partitionen!):
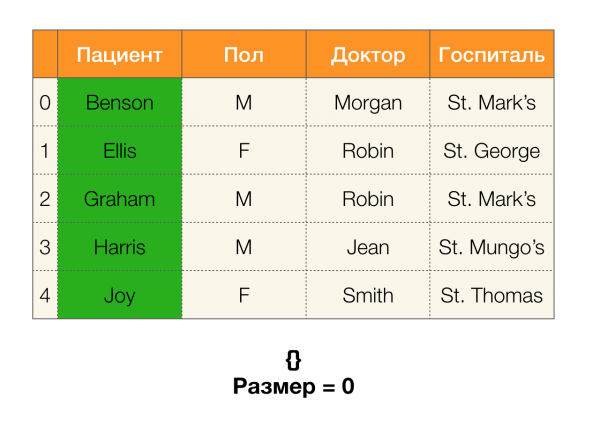
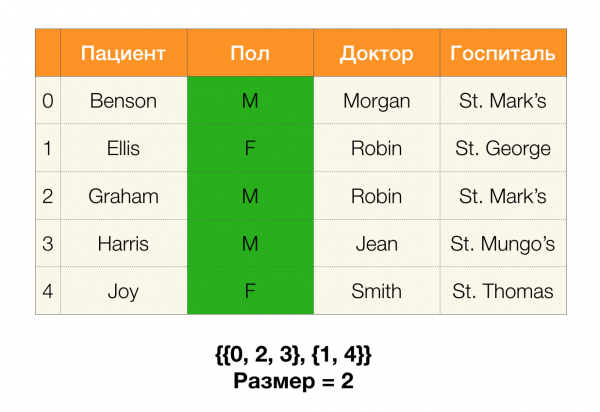
Nu kan vi definiera ett av de nyckellemmor som för angivna partitioner gör det möjligt att fastställa om beroendet hålls eller inte:
Lemma 1. Beroendet A, B → C hålls om och endast om

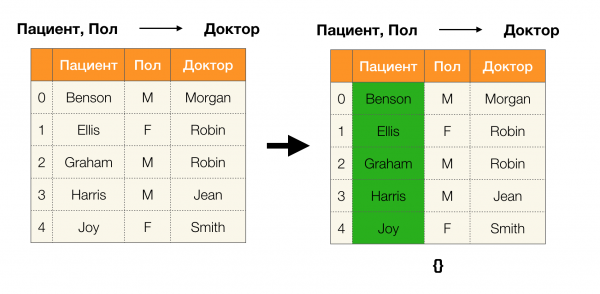
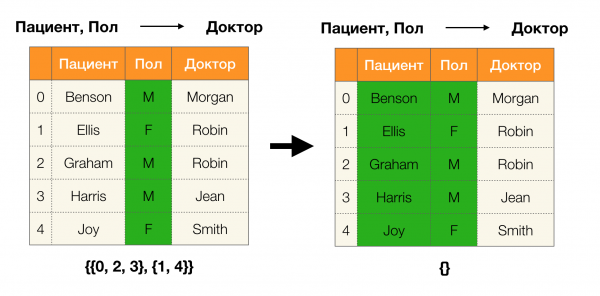
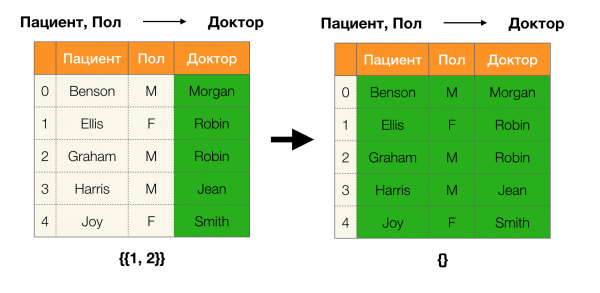
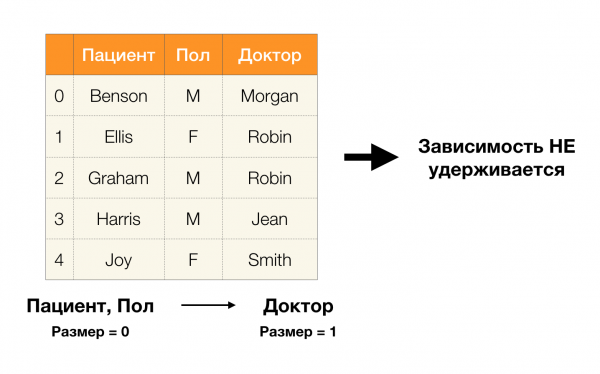
Enligt lemmana, för att avgöra om ett beroende hålls, måste fyra steg utföras:
- Beräkna partitionen för den vänstra delen av beroendet
- Beräkna partitionen för den högra delen av beroendet
- Beräkna produkten av det första och andra steget
- Jämför storlekarna på partitionerna som erhölls i det första och tredje steget
Nedanför finns ett exempel på kontroll av om beroendet hålls enligt denna lemma:
I denna artikel har vi gått igenom begreppen funktionellt beroende, approximativt funktionellt beroende, diskuterat var de används, samt vilka algoritmer som finns för att söka efter FB. Vi har också noggrant gått igenom grundläggande, men viktiga begrepp som aktivt används i moderna algoritmer för att söka efter FB.
Referenser:
- Huhtala Y. et al. TANE: En effektiv algoritm för att upptäcka funktionella och approximativa beroenden // The computer journal. - 1999. - Vol. 42. - No. 2. - S. 100-111.
- Kruse S., Naumann F. Effektiv upptäckte av approximativa beroenden // Proceedings of the VLDB Endowment. - 2018. - Vol. 11. - No. 7. - S. 759-772.
- Papenbrock T., Naumann F. En hybridmetod för upptäckte av funktionella beroenden // Proceedings of the 2016 International Conference on Management of Data. - ACM, 2016. - S. 821-833.
- Papenbrock T. et al. Upptäckte av funktionella beroenden: En experimentell utvärdering av sju algoritmer // Proceedings of the VLDB Endowment. - 2015. - Vol. 8. - No. 10. - S. 1082-1093.
- Kumar A. et al. Att gå med eller inte?: Tänka efter två gånger om join-ningar innan funktionell urval // Proceedings of the 2016 International Conference on Management of Data. - ACM, 2016. - S. 19-34.
- Abo Khamis M. et al. In-database learning with sparse tensors //Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – S. 325-340.
- Hellerstein J. M. et al. The MADlib analytics library: or MAD skills, the SQL //Proceedings of the VLDB Endowment. – 2012. – Vol. 5. – No. 12. – S. 1700-1711.
- Qin C., Rusu F. Speculative approximations for terascale distributed gradient descent optimization //Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – S. 1.
- Meng X. et al. Mllib: Machine learning in apache spark //The Journal of Machine Learning Research. – 2016. – Vol. 17. – No. 1. – S. 1235-1241.
Författarna till artikeln: , forskare vid , och , forskare vid
Källa: habr.com
