

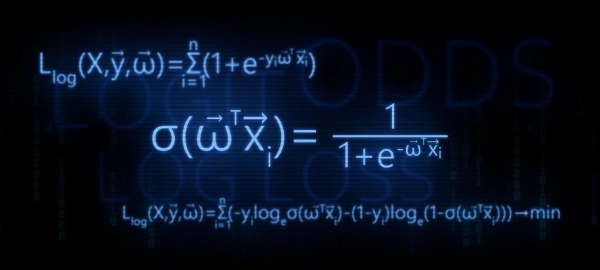
I den här artikeln kommer vi att gå igenom de teoretiska redogörelserna för omvandlingen av linjär regressionsfunktion på omvänd logit-omvandlingsfunktionen (eller som den också kallas, logistiske responsfunktionen). Sedan, med hjälp av arsenalen för metoden för maximal sannolikhet, enligt modellen för logistisk regression, kommer vi att härleda förlustfunktionen Logistic Loss, eller med andra ord, vi kommer att definiera en funktion som används för att justera parametrarna för viktvektorn i den logistiska regressionsmodellen  .
Artikelplan:
- Låt oss återkomma till den linjära relationen mellan två variabler
- Vi kommer att identifiera behovet av omvandlingen av linjär regressionsfunktion
 på logistisk responsfunktion
- Vi kommer att genomföra omvandlingar och härleda logistisk responsfunktion
- Vi ska försöka förstå vad som är fel med minskad kvadratmetod vid justering av parametrar funktioner Logistic Loss
- Används metoden för maximalt sannolikhet för att bestämma parameterjusteringsfunktionen :
5.1. Fall 1: funktion Logistic Loss för objekt med klassbeteckningar 0 och 1:
5.2. Fall 2: funktion Logistic Loss för objekt med klassbeteckningar -1 och +1:
 på logistisk responsfunktion

 funktioner Logistic Loss
 :


Artikeln är full av enkla exempel där alla beräkningar enkelt kan göras mentalt eller på papper, och i vissa fall kan en räknare behövas. Så var beredd 🙂
Denna artikel är främst avsedd för datavetare med grundläggande kunskaper om maskininlärning.
I artikeln kommer det även att ges kod för att rita diagram och utföra beräkningar. All kod är skriven på språket python 2.7. Jag kommer på förhand att förklara "nyheten" i den använda versionen - detta är ett av kraven för att genomgå en känd kurs från Yandex på en inte mindre känd online utbildningsplattform Coursera, och som man kan anta är materialet förberett utifrån denna kurs.
01. Linjär relation
Det är fullt rimligt att ställa frågan – vad har linjär relation att göra med logistisk regression?
Det är enkelt! Logistisk regression är en av modellerna som tillhör den linjära klassificeraren. Enkelt uttryckt är uppgiften för en linjär klassificerare att förutsäga målvärden  från variabler (regressorer)
 . Härvid antas det att relationen mellan attributen
 och målvärdena
 är linjär. Därav namnet på klassificeraren - linjär. Om man ska göra en mycket grov generalisering, så bygger modellen för logistisk regression på antagandet om en linjär relation mellan attributen
 och målvärdena
 . Här är sambandet.
I studien är det första exemplet, och det handlar om det linjära sambandet mellan de undersökta storheterna. Under förberedelserna av artikeln stötte jag på ett exempel som redan många har tröttnat på — sambandet mellan strömstyrka och spänning. ("Praktisk regressionsanalys", N. Draper, G. Smith). Här kommer vi också att ta en titt på det.
I enlighet med Ohms lag:
 , där
 — strömstyrka,
 — spänning,
 — motstånd.
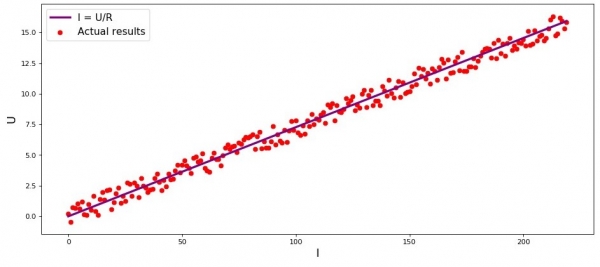
Om vi inte hade vetat Ohms lag, skulle vi kunna hitta sambandet empiriskt genom att ändra  och mäta
 , och samtidigt hålla
 konstant. Då skulle vi se att grafen över sambandet
 från
 ger en mer eller mindre rak linje som går genom origo. Vi säger "mer eller mindre" eftersom, även om sambandet faktiskt är exakt, kan våra mätningar innehålla små fel, och därför kanske punkterna på grafen inte träffar linjen exakt, utan sprids runt den på ett slumpmässigt sätt.
Graf 1 "Samband  från
 »
Kod för att rita grafen
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Verkliga resultat')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Behovet av transformationer av linjär regressionsformel
Vi överväger ett annat exempel. Låt oss anta att vi arbetar på en bank och att vi har till uppgift att bestämma sannolikheten för att en låntagare återbetalar sitt lån beroende på vissa faktorer. För att förenkla uppgiften, överväger vi endast två faktorer: låntagarens månadslön och månadskostnaden för att återbetala lånet.
Uppgiften är mycket hypotetisk, men med detta exempel kan vi förstå varför det är otillräckligt att använda av linjär regressionsfunktion, och vilka transformationer som krävs för funktionen.
Vi återvänder till exemplet. Det är tydligt att ju högre lön, desto mer kan låntagaren avsätta varje månad för att betala tillbaka lånet. För ett visst lönespann kommer detta samband att vara ganska linjärt. Låt oss ta ett lönespann från 60 000 kr till 200 000 kr och anta att i det angivna lönespannet är sambandet mellan storleken på den månatliga betalningen och lönen linjärt. Anta att det har visat sig för det angivna lönespannet att förhållandet mellan lönen och betalningen inte kan vara mindre än 3 och att låntagaren dessutom måste ha 5 000 kr kvar i reserv. Endast under dessa omständigheter kommer vi att anse att låntagaren återbetalar lånet till banken. Då kommer ekvationen för linjär regression att se ut så här:

w  ,
 ,
 ,
 — lönen
 -en låntagare,
 — lånebetalning
 -en låntagare.
Genom att sätta in lönen och lånebetalningen i ekvationen med fasta parametrar  kan ett beslut om beviljande eller avslag av lånet fattas.
För att förhindra framtida problem, notera att under givna parametrar  linjär regressionsfunktion, som används i logistisk regressionsfunktion kommer att ge stora värden, vilket gör det svårt att beräkna sannolikheten för låneåterbetalning. Därför föreslås det att vi minskar våra koefficienter, säg med 25 000 gånger. Denna omvandling i koefficienterna påverkar inte beslutet om att bevilja lånet. Låt oss komma ihåg detta för framtiden, och nu för att tydliggöra vad vi talar om, låt oss titta på situationen med tre potentiella låntagare.
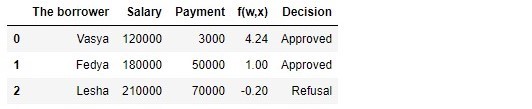
Tabell 1 "Potentiella låntagare"
Kod för att skapa tabellen
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Låntagaren':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Lön':np.array([120000,180000,210000]),
       'Betalning':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Lön']*w_1 + df['Betalning']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Godkänd'
        decision.append(dec)
    else:
        dec = 'Avslag'
        decision.append(dec)

df['Beslut'] = decision

df[['Låntagaren', 'Lön', 'Betalning', 'f(w,x)', 'Beslut']]
I enlighet med tabellens data vill Vasya, med en lön på 120 000 kr, få ett lån där han kan betala 3 000 kr i månaden. Vi har fastställt att för att lånet ska godkännas måste Vasya ha en lön som överstiger tre gånger betalningen och att han ska ha 5 000 kr kvar. Detta krav uppfyller Vasya:  . Det återstår till och med 106.000R. Trots att vi har minskat koefficienterna
 med 25.000 gånger, fick vi samma resultat — lånet kan godkännas. Fedya kommer också att få ett lån, medan Lesha, trots att han tjänar mest, måste dämpa sina begär.
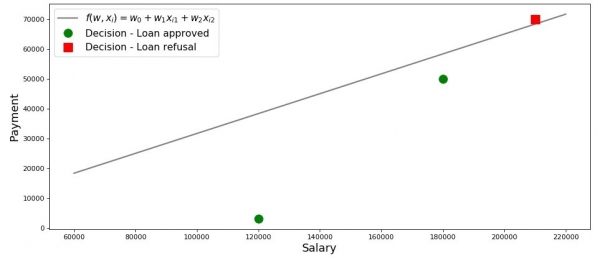
 Låt oss rita en graf för detta fall.
Graf 2 "Klassificering av låntagare"
Kod för att rita grafen
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize = (14,6), dpi = 80) plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Beslut - Lån godkänt') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Beslut - Lån avslaget') plt.xlabel('Lön', size = 16) plt.ylabel('Betalning', size = 16) plt.legend(prop = {'size': 14}) plt.show()
Så vår linje, som byggs enligt funktionen, separerar "dåliga" låntagare från "goda". De låntagare vars önskningar inte överensstämmer med möjligheterna ligger ovanför linjen (Lesha), medan de som kan återbetala lånet enligt parametrarna i vår modell ligger under linjen (Vasya och Fedya). Man kan säga att vår linje delar in låntagarna i två klasser. Låt oss beteckna dem som:  vi kommer att inkludera de låntagare som troligen kommer att återbetala lånet i klassen
 vi kommer att inkludera de låntagare som troligen inte kommer att kunna återbetala lånet i klassen.
 eller
 Låt oss generalisera slutsatserna från detta enkla exempel. Låt oss ta en punkt
och, genom att sätta in koordinaterna för punkten i motsvarande linjens ekvation  , överväga tre alternativ:
 Om punkten ligger under linjen och vi tillskriver den klassen
- , kommer funktionsvärdet att vara positivt från . Då kan vi säga att sannolikheten för återbetalning av lånet ligger inom till . Ju högre funktionens värde är, desto högre är sannolikheten. Om punkten ligger ovanför linjen och vi tillskriver den klassen
- , då kommer funktionsvärdet att vara negativt från eller . Då kommer vi att anse att sannolikheten för att återbetala skulden ligger inom till och ju större värde funktionen har i absolutvärde, desto högre blir vår övertygelse. Punkten ligger på linjen, på gränsen mellan de två klasserna. I sådana fall är funktionsvärdet
- lika med och sannolikheten för återbetalning av lånet är Nu, föreställ dig att vi inte har två faktorer, utan dussintals, låntagare inte tre, utan tusentals. Då istället för en linje har vi .
 att vara positivt från
 . Då kan vi säga att sannolikheten för återbetalning av lånet ligger inom
 till
 . Ju högre funktionens värde är, desto högre är sannolikheten.
 Om punkten ligger ovanför linjen och vi tillskriver den klassen
 eller
 . Då kommer vi att anse att sannolikheten för att återbetala skulden ligger inom
 till
 och ju större värde funktionen har i absolutvärde, desto högre blir vår övertygelse.
 Punkten ligger på linjen, på gränsen mellan de två klasserna. I sådana fall är funktionsvärdet
 och sannolikheten för återbetalning av lånet är
 Nu, föreställ dig att vi inte har två faktorer, utan dussintals, låntagare inte tre, utan tusentals. Då istället för en linje har vi
 .
Nu, föreställ oss att vi inte har två faktorer, utan tiotals, och att låntagarna inte är tre, utan tusentals. Då istället för en linje har vi m-område ytan och koefficienterna  de kommer inte att tas framsidan, utan beräknas enligt alla regler, baserat på insamlade data om låntagare som har återbetalat eller inte återbetalat sina lån. Och faktiskt, märk väl, vi väljer nu låntagare med redan kända koefficienter
 . I själva verket består modellen för logistisk regression just av att bestämma parametrarna
 , där värdet av förlustfunktionen Logistic Loss strävar efter att vara minimalt. Men hur vektorn
 , beräknas, får vi veta i avsnitt 5 av artikeln. Tills dess återvänder vi till det utlovade landet — till vår banktjänsteman och tre av hans kunder.
Tack vare funktionen  vet vi vem som kan få ett lån och vem som måste nekas. Men med sådan information kan vi inte gå till direktören, eftersom vi vill ha sannolikheten för återbetalning för varje låntagare. Vad göra? Svaret är enkelt — vi behöver på något sätt omvandla funktionen
 , vars värden ligger i intervallet
 till en funktion vars värden kommer att ligga i intervallet
 . Och en sådan funktion existerar, den kallas logistisk responsfunktion eller invers-logit-transform. Bekanta er med:

Låt oss se steg för steg hur man får fram logistisk responsfunktion.Vi noterar att vi kommer att gå bakåt, det vill säga vi förutsätter att vi känner till sannolikhetsvärdet, som ligger inom gränserna från  till
 och därefter kommer vi att "rulla upp" detta värde över hela talområdet från
 till
 .
03. Vi ger fram logistisk responsfunktion
Steg 1. Överför sannolikhetsvärden till intervallet

Under transformeringen av funktionen  på logistisk responsfunktion
 lämnar vi vår kreditanalytiker ifred för en stund och istället går vi till sportoddsen. Nej, självklart kommer vi inte att placera något vad, allt som intresserar oss där är betydelsen av uttrycket, till exempel oddset 4 till 1. Oddsen, kända för alla som spelar på vad, är förhållandet mellan "framgångar" och "misslyckanden". Ur sannolikhetsperspektiv är oddsen sannolikheten för att en händelse inträffar dividerat med sannolikheten för att händelsen inte inträffar. Låt oss skriva formeln för oddset för att händelsen inträffar
 :

, där  — sannolikheten för att händelsen inträffar,
 — sannolikheten för att händelsen INTE inträffar
Till exempel, om sannolikheten för att en ung, stark och energisk häst vid namn "Vindpinne" ska slå den gamla och skröpliga damen "Matilda" i ett lopp är  , så kommer "Vindpinne" ha en framgångschans på
 till

 och omvänt, om vi känner till oddsen, blir det enkelt att beräkna sannolikheten
 :

Således har vi lärt oss att "översätta" sannolikhet till odds, som kan anta värden från  till
 . Vi tar ett steg till och lär oss att "översätta" sannolikhet till hela den numeriska linjen från
 till
 .
Steg 2. Vi kommer att översätta sannolikhetsvärden till intervallet

Detta steg är mycket enkelt — vi loggar oddsen med basen av talet Euler  och får:

Nu vet vi att om  , så kommer det att vara mycket enkelt att beräkna värdet
 och dessutom bör det vara positivt:
 . Så är det.
För nyfikenhetens skull kontrollerar vi, om  , då förväntar vi oss att se ett negativt värde
 . Vi kontrollerar:
 . Helt rätt.
Nu vet vi hur man översätter sannolikhetsvärdet från  till
 till hela den numeriska linjen från
 till
 . I nästa steg gör vi allt tvärtom.
Men för nu, låt oss notera att enligt logaritmeringsreglerna, om vi känner till funktionens värde  , kan vi beräkna oddsen:

Denna metod för att bestämma oddsen kommer att vara användbar i nästa steg.
Steg 3. Vi kommer att härleda formeln för att bestämma

Så, vi har lärt oss att, med veten  , hitta värdena för funktionen
 . Men i verkligheten behöver vi allt tvärtom — att veta värdet
 för att få
 . För detta vänder vi oss till begreppet inversa oddset, enligt vilket:

I artikeln kommer vi inte att härleda den ovan nämnda formeln, men vi kommer att kontrollera med siffrorna från exemplet ovan. Vi vet att med odds lika med 4 till 1 ( ), är sannolikheten för att händelsen inträffar 0,8 (
 ). Vi gör en substitution:
 . Detta stämmer överens med våra tidigare beräkningar. Låt oss gå vidare.
I det föregående steget kom vi fram till att  , vilket innebär att vi kan göra en substitution i den inversa oddset. Vi får:

Vi delar såväl täljaren som nämnaren med  , då:

För att vara på den säkra sidan, för att säkerställa att vi inte har gjort något misstag, gör vi en liten kontroll till. I steg 2 fastställde vi att  . Då, genom att ersätta värdet
 i den logistiska återkopplingsfunktionen, förväntar vi oss att få
 . Vi sätter in och får:
 .

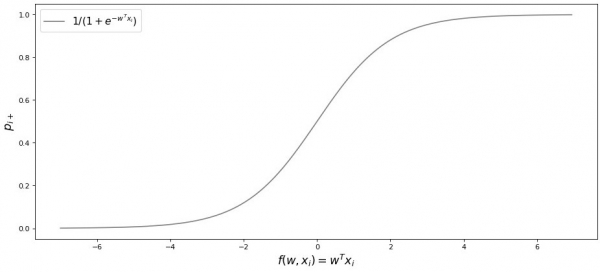
Grattis, kära läsare! Vi har just utvecklat och testat logit-funktionen. Låt oss ta en titt på grafen för funktionen.
Graf 3 "Logit-funktionen"
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize = (14,6), dpi = 80) plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Beslut - Lån godkänt') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Beslut - Lån avslaget') plt.xlabel('Lön', size = 16) plt.ylabel('Betalning', size = 16) plt.legend(prop = {'size': 14}) plt.show()
import math

def logit(f):
    return 1/(1 + math.exp(-f))

f = np.arange(-7, 7, 0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize=(14, 6), dpi=80)
plt.plot(f, p, color='grey', label='$ 1 / (1 + e^{-w^Tx_i})$')
plt.xlabel('$f(w, x_i) = w^Tx_i$', size=16)
plt.ylabel('$p_{i+}$', size=16)
plt.legend(prop={'size': 14})
plt.show()
I litteraturen kan denna funktion också kallas sigmoidfunktion. Det framgår tydligt av grafen att den största förändringen av sannolikheten för att ett objekt tillhör en klass sker över ett relativt smalt intervall  , någonstans mellan
 till
 .
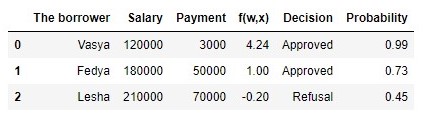
Jag föreslår att vi återgår till vår kreditanalytiker och hjälper honom att beräkna sannolikheten för kreditåterbetalning, annars riskerar han att gå miste om sin premie 🙂
Tabell 2 "Potentiella låntagare"
Kod för att skapa tabellen
proba = []
for i in df['f(w, x)']:
    proba.append(round(logit(i), 2))

df['Sannolikhet'] = proba

df[['Låntagaren', 'Lön', 'Betalning', 'f(w,x)', 'Beslut', 'Sannolikhet']]
Så, vi har fastställt sannolikheten för kreditåterbetalning. Generellt sett ser det ut att vara rimligt.
Verkligen, sannolikheten för att Vasja med en lön på 120.000R kan betala 3.000R månadsvis till banken, ligger nära 100%. För övrigt bör vi förstå att banken kan bevilja ett lån till Ljoša om bankens policy tillåter, till exempel att låna ut till kunder med en återbetalningssannolikhet över 0.3. I sådana fall bildar banken en större reserv för potentiella förluster.
Det bör också noteras att förhållandet mellan lön och betalning på minst 3 och med en säkerhetsmarginal på 5.000R togs från luften. Så vi kunde inte använda vikterna i sin ursprungliga form.  . Vi var tvungna att kraftigt minska koefficienterna och i dessa fall delade vi varje koefficient med 25.000, vilket i grunden anpassade resultatet. Men detta gjordes medvetet för att förenkla förståelsen av materialet i det inledande skedet. I verkligheten behöver vi inte hitta på och justera koefficienter utan faktiskt finna dem. I de följande avsnitten av artikeln kommer vi att härleda ekvationer för att bestämma parametrarna.
 .
04. Metod för minsta kvadrat i bestämning av viktvektorn i logit-funktionen
 i logit-funktionen
Vi känner redan till en sådan metod för att justera viktvektorn.  , som metoden för minsta kvadrat (MKM) och faktiskt, varför skulle vi då inte använda det i uppgifter för binär klassificering? Verkligen, ingenting hindrar oss från att använda MNLK, men just denna metod inom klassificeringsuppgifter ger mindre precisa resultat än Logistic Loss. Det finns en teoretisk grund för detta. Låt oss först titta på ett enkelt exempel.
Anta att våra modeller (som använder MSE och Logistic Loss) redan har börjat optimera viktvektorn  och vi har avbrutit beräkningen vid något steg. Det spelar ingen roll om det är i mitten, i slutet eller i början, det viktiga är att vi redan har några värden i viktvektorn och låt oss anta att vid detta steg har viktvektorerna
 för båda modellerna inga skillnader. Då tar vi de erhållna vikterna och sätter in dem i logistisk responsfunktion (
 ) för något objekt som tillhör klassen
 . Vi undersöker två fall, när vår modell enligt den optimerade viktvektorn gör ett stort misstag och å sin sida — modellen är mycket säker på att objektet tillhör klassen
 . Låt oss se vilka straff som kommer att "utfärdas" vid användning av MNLK och Logistic Loss.
Koden för att beräkna straffen beroende på den använda förlustfunktionen
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Fallet med ett grovt misstag — modellen klassificerar objektet som tillhörande klassen  med en sannolikhet på 0,01
Straffet vid användning av MNLK blir:

Straffet vid användning av Logistic Loss blir:

Fallet med stark säkerhet — modellen klassificerar objektet som tillhörande klassen  med en sannolikhet på 0,99
Straffet vid användning av MNLK blir:

Straffet vid användning av Logistic Loss blir:

Detta exempel illustrerar tydligt att vid grova misstag straffar förlustfunktionen Log Loss modellen betydligt hårdare än MSE. Låt oss nu förstå vilka teoretiska förutsättningar som ligger till grund för användningen av förlustfunktionen Log Loss i klassificeringsuppgifter.
05. Metod för maximal sannolikhet och logistisk regression
Som lovat i början är artikeln full av enkla exempel. Här är ytterligare ett exempel med gamla bekanta — banklåntagare: Vasia, Fedja och Ljosa.
För säkerhets skull, innan vi utvecklar exemplet, påminner jag om att vi i verkligheten arbetar med en träningsuppsättning av tusentals eller miljoner objekt med tiotals eller hundratals attribut. Men här är siffrorna valda så att de lätt kan förstås av en nybörjare inom datavetenskap.
Låt oss återvända till exemplet. Anta att bankdirektören har beslutat att bevilja lån till alla som behöver, trots att algoritmen föreslog att inte bevilja det till Lesja. Tiden har gått och vi har fått veta vem av de tre hjältarna som har återbetalat lånet och vem som inte har det. Som förväntat: Vasilij och Fedja återbetalade lånet, medan Lesja inte gjorde det. Låt oss nu tänka oss att detta resultat blir vår nya träningsdata, och att vi på något sätt har förlorat all information om faktorerna som påverkar sannolikheten för återbetalning av lånet (låntagarens lön, storleken på månadskostnaden). Då kan vi intuitivt anta att var tredje låntagare inte betalar tillbaka lånet till banken, eller med andra ord, sannolikheten för återbetalning av lånet av nästa låntagare.  . Denna intuitiva hypotes har teoretisk bekräftelse och bygger på metoden för maximal sannolikhet, som ofta kallas maximal sannolikhetsprincipen..
För att börja, låt oss bekanta oss med begreppen.
Sannolikheten för urvalet är sannolikheten att få just detta urval, exakt dessa observationer/resultat, det vill säga produkten av sannolikheterna för att få vart och ett av resultaten i urvalet (till exempel om lånet är återbetalat eller inte av Vasilij, Fedja och Lesja samtidigt).
Sannolikhetsfunktionen kopplar sannolikheten för urvalet till värdena av distributionsparametrarna.
I vårt fall representerar träningsurvalet ett generaliserat Bernoullischema, där den slumpmässiga variabeln antar endast två värden:  eller
 . Därför kan sannolikheten för urvalet skrivas som en sannolikhetsfunktion av parametern
 på följande sätt:


Den ovanstående uppsättningen kan tolkas så här. Den sammantagna sannolikheten för att Vasilij och Fedja kommer att återbetala lånet är  , sannolikheten att Lesja INTE återbetalar lånet är
 (eftersom det faktiskt handlade om att INTE återbetala lånet), därför är den gemensamma sannolikheten för alla tre händelser lika med
 .
Metoden för maximalt sannolikhet - detta är metoden för att uppskatta en okänd parameter genom maximering av sannolikhetsfunktion. I vårt fall behöver vi hitta ett sådant värde  , där
 når sitt maximum.
Var kommer egentligen idén från – att söka efter värdet av en okänd parameter för vilken sannolikhetsfunktionen når sitt maximum? Idén har sitt ursprung i uppfattningen om att ett urval är den enda tillgängliga källan till kunskap om populationen. Allt vi vet om populationen framgår av urvalet. Därför kan vi säga att urvalet är den mest exakta spegelbilden av populationen som är tillgänglig för oss. Därmed behöver vi hitta en parameter där det existerande urvalet blir mest sannolikt.
Uppenbarligen har vi att göra med ett optimeringsproblem där vi behöver hitta extrempunkten för en funktion. För att hitta extrempunkten krävs det att vi betraktar det första ordningens villkoret, det vill säga att sätta derivatan av funktionen lika med noll och lösa ekvationen för den okända parametern. Dock kan sökandet efter derivatan av produkten av många faktorer bli en tidskrävande uppgift, för att undvika detta finns det en speciell teknik – att gå till logaritmen. sannolikhetsfunktion. Varför är en sådan övergång möjlig? Låt oss notera att vi inte söker extrema värdet av funktionen , utan extrempunkten, det vill säga det värde av den okända parametern
 , där
 når sitt maximum. Vid övergången till logaritmen förändras inte extrempunkten (även om själva extremvärdet kommer att skilja sig), eftersom logaritmen är en monoton funktion.
Låt oss, i enlighet med det som tidigare sagts, fortsätta utveckla vårt exempel med lån från Vasilij, Fedja och Ljoša. Först går vi till logaritmen av sannolikhetsfunktionen.:

Nu kan vi enkelt derivera uttrycket med avseende på  :

Och slutligen, låt oss betrakta det första ordningens villkoret – sätta derivatan av funktionen lika med noll:

På så sätt har vår intuitiva bedömning av sannolikheten för återbetalning av lån  teoretiskt motiverats.
Utmärkt, men vad ska vi nu göra med sådan information? Om vi antar att varje tredje låntagare inte returnerar pengar till banken, kommer denna oundvikligen att gå i konkurs. Så är det, men vid bedömningen av sannolikheten för återbetalning av lån lika med  Vi har inte tagit hänsyn till de faktorer som påverkar låneåterbetalningen: låntagarens lön och storleken på den månatliga betalningen. Låt oss minnas att vi tidigare beräknade sannolikheten för att varje kund återbetalar lånet med hänsyn till just dessa faktorer. Det är logiskt att våra sannolikheter därför avviker från konstantvärdet som är lika med
 .
Låt oss definiera sannolikheten för urvalen:
Kod för att beräkna sannolikheterna för urvalen
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Sannolikheten för urvalet vid konstant värde p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Sannolikheten för urvalet vid beräknat värde p:', round(likelihood(y,p_log_response),3)
Sannolikheten för urvalet vid konstant värde  :

Sannolikheten för urvalet vid beräkning av låneåterbetalning med hänsyn till faktorer  :


Sannolikheten för urvalet med sannolikheten beräknad beroende på faktorer visade sig vara högre än sannolikheten vid konstant värde. Vad betyder det? Det betyder att kunskap om faktorerna har möjliggjort en mer exakt anpassning av sannolikheten för låneåterbetalning för varje kund. Därför, vid beviljande av nästa lån, är det mer korrekt att använda modellen för att bedöma sannolikheten för återbetalning av lån, som föreslogs i slutet av avsnitt 3 av artikeln.
Men då, om vi behöver maximera sannolikhetsfunktionen för urvalet, varför inte använda någon algoritm som skulle ge sannolikheter för Vasia, Fedya och Lesha, till exempel, lika med 0,99, 0,99 och 0,01 respektive. Kanske skulle en sådan algoritm fungera bra på träningsuppsättningen, eftersom den skulle närma sig värdet på sannolikheten för urvalet.  , men för det första kommer en sådan algoritm troligtvis ha svårigheter med förmågan att generalisera, för det andra kommer denna algoritm definitivt inte att vara linjär. Och om metoder för att motverka överanpassning (lika svag generaliseringsförmåga) uppenbarligen inte ingår i planen för denna artikel, låt oss gå in mer på det andra punkten. För detta räcker det att svara på en enkel fråga. Kan sannolikheten för att återbetala lånet för Vasja och Fedja vara densamma med hänsyn till de faktorer vi känner till? Ur ett sunt förnufts perspektiv, självklart kan det inte vara så. Så när det kommer till återbetalningen av lånet kommer Vasja att ge 2,5% av sin lön per månad, medan Fedja nästan ger 27,8%. På diagram 2
 Klassificering av kunder
 ser vi att Vasja ligger betydligt längre från linjen som delar klasserna än Fedja. Slutligen vet vi att funktionen
 för Vasja och Fedja antar olika värden: 4,24 för Vasja och 1,0 för Fedja. Om Fedja till exempel skulle tjäna betydligt mer eller be om ett mindre lån, skulle sannolikheterna för återbetalning av lån för Vasja och Fedja vara liknande. Med andra ord kan du inte luras med en linjär beroende. Och om vi verkligen hade räknat ut koefficienterna
 , och inte tagit dem ur luften, skulle vi kunna påstå att våra värden
bäst bedömer sannolikheten för att varje låntagare återbetalar lånet, men eftersom vi har kommit överens om att bestämma koefficienterna  har gjorts enligt alla regler, så kommer vi att räkna med att våra koefficienter ger den bästa bedömningen av sannolikheten 🙂
Men vi har avvikit från ämnet. I detta avsnitt behöver vi förstå hur viktvektorn bestäms  :
, som är nödvändig för att bedöma sannolikheten för återbetalning av lånet för varje låntagare. linjär regressionsfunktion Sammanfattningsvis, med vilket arsenaler vi går in i sökandet efter koefficienterna  1. Vi antar att relationen mellan den beroende variabeln (förutsägelsevärdet) och faktorn som påverkar resultatet är linjär. Av detta skäl tillämpas
 och
 eller
 typ
 .
, vars linje delar objekten (kunderna) i klasser (kunder, som kan återbetala lånet och de som inte kan). I vårt fall har ekvationen formen Sammanfattningsvis, med vilket arsenaler vi går in i sökandet efter koefficienterna  2. Vi använder
 .
funktionen för invers logit-transformering Bernoullische Modelle, det vill säga för varje objekt genereras en slumpvariabel som med en sannolikhet  (sin egen för varje objekt) antar värdet 1 och med en sannolikhet
 – 0.
4. Vi vet att vi behöver maximera sannolikhetsfunktionen för urvalet med hänsyn till de accepterade faktorerna så att det givna urvalet blir mest troligt. Med andra ord, vi behöver välja sådana parametrar som gör urvalet mest troligt. I vårt fall är den parameter vi justerar sannolikheten för att lånet betalas tillbaka  , vilket i sin tur beror på okända koefficienter
 . Det betyder att vi behöver hitta en sådan viktsvektor
 , där sannolikheten för urvalet blir maximal.
5. Vi vet att för att maximera sannolikhetsfunktionen för urvalet kan användas metoden för maximalt sannolikhet. Och vi känner till alla smarta knep för att arbeta med denna metod.
Så här blir det en komplex lösning 🙂
Och nu ska vi påminna oss om att vi i början av artikeln ville härleda två typer av förlustfunktioner Logistic Loss beroende på hur objekts klasser betecknas. Det är så det blivit att i klassificeringsuppgifter med två klasser, klasserna betecknas som  och
 eller
 . Beroende på beteckningen, kommer motsvarande förlustfunktion att bli utgående.
Fall 1. Klassificering av objekt på och
 och

Tidigare, vid beräkning av sannolikheten för urvalet, där sannolikheten för att lånet tas tillbaka beräknades utifrån faktorer och givna koefficienter  , tillämpade vi formeln:

I själva verket  — det är värdet av logitfunktionen
 med den angivna viktsvektorn

Då finns det inget som hindrar oss från att skriva sannolikhetsfunktionen för urvalet så här:

Det händer att vissa nybörjare inom analys kan ha svårt att direkt förstå hur denna funktion fungerar. Låt oss titta på 4 korta exempel som alla klargör:
1. Om  (dvs. enligt träningsurvalet tillhör objektet klass +1), medan vår algoritm
 beräknar sannolikheten för att objektet tillhör klassen
 till 0,9, så den här delen av sannolikheten för urvalet kommer att beräknas så här:

2. Om  , och
 , så beräkningen blir så här:

3. Om  , och
 , så beräkningen blir så här:

4. Om  , och
 , så beräkningen blir så här:

Det är uppenbart att sannolikhetsfunktionen maximalt kommer att uppnås i fallen 1 och 3 eller i allmänhet — vid korrekt gissade sannolikhetsvärden för att tilldela objektet till klassen  .
Eftersom vid bestämningen av sannolikheten att tilldela objektet till klassen  vi känner inte till några koefficienter
 , så vi kommer att leta efter dem. Som nämnt ovan är detta en optimeringsuppgift där vi först behöver hitta derivatan av sannolikhetsfunktionen med avseende på viktvektorn
 . Men innan dess är det värt att förenkla uppgiften: vi kommer att söka derivatan av logaritmen sannolikhetsfunktion.

Varför efter logaritmering, i logistisk felfunktion, bytte vi tecken från  till
 . Det är enkelt, eftersom det i uppgifter om modellutvärdering är vanligt att minimera funktionsvärdet, så vi multiplicerade den högra delen av uttrycket med
 och istället för maximisering, minimerar vi nu funktionen.
Nu har vi, inför era ögon, genomlidit funktionen för förlust — Logistic Loss för träningsdatasetet med två klasser:  och
 .
Nu, för att hitta koefficienterna, behöver vi bara hitta derivatan logistisk felfunktion och vidare, med hjälp av numeriska optimeringsmetoder som gradientnedstigning eller stokastisk gradientnedstigning, justera till de mest optimala koefficienterna  . Men med tanke på den redan stora mängden artikel, föreslås det att utföra differentiering själv, eller kanske detta blir ämnet för nästa artikel med mer matematik utan så många detaljerade exempel.
Fall 2. Klassificering av objekt på och
 och

Tillvägagångssättet här kommer att vara detsamma som med klasserna  och
 , men själva vägen till att härleda förlustfunktionen Logistic Loss, kommer att vara mer invecklad. Låt oss börja. Vi kommer att använda operatören «om…, då…». Det vill säga, om
 -te objektet hör till klassen
 , så för att beräkna sannolikheten för urvalet använder vi sannolikhet
 , om objektet hör till klassen
 , så sätter vi in i sannolikheten
 . Så här ser sannolikhetsfunktionen ut:

Låt oss förklara hur detta fungerar. Vi överväger 4 fall:
1. Om  och
 , då kommer sannolikheten för urvalet att gå till

2. Om  och
 , då kommer sannolikheten för urvalet att gå till

3. Om  och
 , då kommer sannolikheten för urvalet att gå till

4. Om  och
 , då kommer sannolikheten för urvalet att gå till

Det är uppenbart att i fall 1 och 3, när sannolikheterna var korrekt definierade av algoritmen, sannolikhetsfunktionen kommer att maximeras, dvs. detta var exakt vad vi ville uppnå. Men sådan ansats är ganska otymplig och vidare kommer vi att granska en mer kompakt skrift. Men först, logaritmera sannolikhetsfunktionen med teckenbyte, eftersom vi nu kommer att minimera den.

Vi sätter istället for  uttryck
 :

Låt oss förenkla det högra ledet under logaritmen med hjälp av enkla aritmetiska metoder och få:

Och nu är det dags att bli av med operatören «om…, då…». Observera att när ett objekt  hör till klassen
 , då i uttrycket under logaritmen, i nämnaren,
 upphöjs till en exponent
 , om objektet hör till klassen
 , då $e$ upphöjs till en exponent
 . Följaktligen kan exponentnotationen förenklas — vi kan kombinera båda fallen i ett:
 . Då funktionen för logistisk förlust att ta formen:

Enligt logaritmeringsreglerna vänder vi bråket och tar ut tecknet " " (minus) ur logaritmen, och får:

Här är funktionen för förlust logistic Loss, som används i träningsdataset med objekt som hör till klasser:  och
 .
Ja, jag tar farväl här och vi avslutar artikeln.
Författarens föregående arbete — "Sätter linjär regressions ekvation i matrisform"
Kompletterande material
1. Litteratur
1) Tillämpad regressionsanalys / N. Draper, G. Smith – 2:a uppl. – Moskva: Finanser och statistik, 1986 (översättning från engelska)
2) Sannolikhetsteori och matematisk statistik / V.E. Gmurman — 9:e uppl. — Moskva: Högskolan, 2003
3) Sannolikhetsteori / N.I. Tjernova — Novosibirsk: Novosibirsk statliga universitet, 2007
4) Affärsanalys: från data till kunskap / Paklin N.B., Oreshkov V.I. — 2:a uppl. — Sankt Petersburg: Piter, 2013
5) Data Science från grunden / Joel Grus — Sankt Petersburg: BHV Petersburg, 2017
6) Praktisk statistik för Data Science-specialister / P. Bruce, E. Bruce — Sankt Petersburg: BHV Petersburg, 2018
2. Föreläsningar, kurser (video)
1)
2)
3)
4)
5)
3. Internetkällor
1)
2)
3)
4)
5)
6)
7)
8)
Källa: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish