

Hej, Habr!
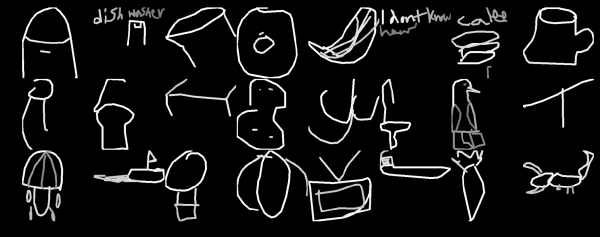
I höstas deltog en tävling på Kaggle för klassificering av handritade bilder kallad Quick Draw Doodle Recognition, där bland andra R-teamet medverkade bestående av , och . Vi kommer inte att gå in på detaljer om tävlingen, det har redan gjorts i .
Med medaljerna gick det inte så bra den här gången, men många värdefulla erfarenheter ficks, så vi skulle vilja berätta för gemenskapen om en rad intressanta och användbara saker på Kaggle och i vårt dagliga arbete. Bland de diskuterade ämnena: det svåra livet utan OpenCV, parsing av JSON (i dessa exempel visas integration av C++-kod i skript eller paket i R via Rcpp), parameterisering av skript och dockerisering av den slutliga lösningen. All kod från meddelandet finns tillgänglig i körbart format i .
Innehåll:
1. Effektiv dataladdning från CSV till MonetDB-databasen
Data i denna tävling tillhandahålls inte som färdiga bilder, utan i form av 340 CSV-filer (en fil för varje klass), som innehåller JSON med koordinater. Genom att förena dessa punkter med linjer får vi en slutlig bild som är 256x256 pixlar stor. För varje post anges också en etikett om bilden korrekt identifierades av den klassificerare som användes vid insamlingen av datasetet, en tvåbokstavskod för landet där konstnären bor, ett unikt ID, en tidsstämpel och klassnamnet som överensstämmer med filnamnet. Den förenklade versionen av de ursprungliga data väger 7,4 GB i arkivet och cirka 20 GB efter uppackning, de fullständiga data efter uppackning upptar 240 GB. Arrangörerna garanterade att båda versionerna reproducerar samma bilder, vilket betyder att den fullständiga versionen är överflödig. I vilket fall som helst erkändes det att lagra 50 miljoner bilder i grafiska filer eller som arrayer var olönsamt, och vi bestämde oss för att slå samman alla CSV-filer från arkivet train_simplified.zip till en databas med efterföljande generering av bilder av önskad storlek "på språng" för varje batch.
Som databasvaldes en beprövad , its own implementation of window functions (based on the Segment Tree Aggregation algorithm), a vectorized query execution engine (based on the Hyper-Pipelining Query Execution algorithm), and a regular expression processor based on the, nämligen implementeringen för R i form av ett paket . Paketet inkluderar en inbäddad version av databasservern och möjliggör att starta servern direkt från R-sessionen och arbeta med den där. Skapandet av databasen och anslutningen till den utförs med ett enda kommando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Vi behöver skapa två tabeller: en för all data, och en för tjänsteinformation om de uppladdade filerna (vilket är användbart om något går fel och processen måste återupptas efter att ha laddat upp flera filer):
Skapande av tabeller
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Det snabbaste sättet att ladda upp data till databasen visade sig vara direkt kopiering av CSV-filer med hjälp av SQL-kommandot COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, där tablename — namnet på tabellen och path — sökvägen till filen. Vid arbete med arkivet upptäcktes att den inbyggda implementeringen av unzip i R fungerade inte korrekt med ett antal filer från arkivet, så vi använde systemet unzip (via parametern getOption("unzip")).
Funktionen för att skriva till databasen
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Om det krävs att konvertera tabellen före skrivning till databasen är det tillräckligt att överföra den i argumentet preprocess funktionen som kommer att behandla data.
Koden för sekventiell datauppladdning till databasen:
Skriva data till databasen
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Tiden för att ladda upp data kan variera beroende på hastighetskarakteristik hos den använda lagringsenheten. I vårt fall tar läsning och skrivning inom en SSD eller från ett USB-minne (ursprungsfilen) till SSD (databasen) mindre än 10 minuter.
Ytterligare några sekunder krävs för att skapa en kolumn med heltalsklassetikett och en indexkolumn (ORDERED INDEX) med radnummer, som kommer att användas för att välja observationer när batcher skapas:
Skapa ytterligare kolumner och index
message("Generate lables")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
För att lösa uppgiften att skapa en batch "i farten" behövde vi uppnå maximal hastighet för att hämta slumpmässiga rader från tabellen doodles. För detta använde vi 3 knep. Det första var att minska datatypens storlek för att lagra observations-ID. I det ursprungliga datamängden krävs typ bigint, men antalet observationer gör att deras identifierare, som är lika med deras ordningsnummer, kan lagras i typ int. Sökningen går därmed betydligt snabbare. Det andra knepet var att använda ORDERED INDEX — denna lösning kom vi fram till empiriskt genom att pröva alla tillgängliga . Den tredje bestod av att använda parametriserade frågor. Metoden går ut på att endast köra kommandot PREPARE en gång, följt av att använda det förberedda uttrycket när man skapar en mängd enhetliga frågor, men i praktiken visade vinsten sig vara nära den statistiska felmarginalen. VÄLJ Processen att ladda upp data använder inte mer än 450 MB RAM. Det innebär att den beskrivna metoden möjliggör hantering av dataset på flera titals gigabyte på praktiskt taget vilken budgethårdvara som helst, inklusive vissa enkortsdatorer, vilket är ganska imponerande.
Återstår att mäta hastigheten för att hämta (slumptals)data och utvärdera skalningen vid urval av batchar av olika storlekar:
Databasbenchmark
Databasbenchmark
library(ggplot2)

set.seed(0)
# Anslutning till databasen
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funktion för att förbereda en serverförfrågan
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funktion för att hämta data
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Utföra mätningar
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametrar för bänkning
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("median tid, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 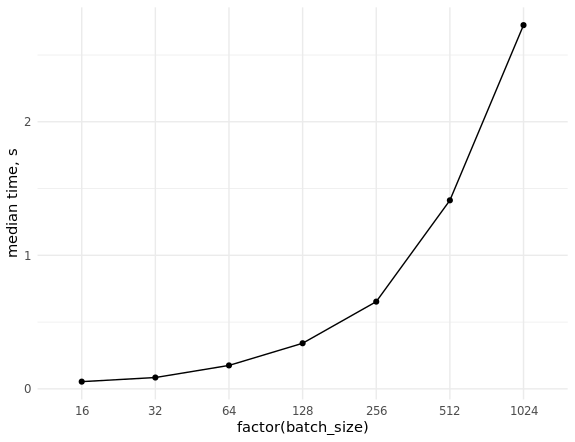
2. Förberedelse av batchar
Hela processen för att förbereda batchar består av följande steg:
- Parsing av flera JSON-objekt som innehåller strängvektorer med koordinater för punkter.
- Rita färgade linjer baserat på punktkoordinater på en bild i rätt storlek (till exempel 256×256 eller 128×128).
- Konvertera de mottagna bilderna till en tensor.
Inom tävlingen bland kernel-erna på Python löstes uppgiften huvudsakligen med hjälp av OpenCV. En av de enklaste och mest uppenbara motsvarigheterna på R skulle se ut som följer:
Implementering av konvertering från JSON till tensor i R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsning av JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Ta bort temporär fil efter att funktionen har avslutats
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Tomt diagram
  plot.new()
  # Storlek på diagramfönstret
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Linjefärger
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Konvertera bilden till en 3D-array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Sammanfoga 3D-bilder till en 4D-tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Ritningen görs med standardmedel i R och sparas som en temporär PNG som lagras i RAM (i Linux ligger temporära R-kataloger i en mapp /tmp, monterad i RAM). Sedan läses den här filen in som en 3D-array med siffror i intervallet 0 till 1. Detta är viktigt eftersom en mer allmänt accepterad BMP skulle ha lästs in som en raw-array med hex-koder för färger.
Låt oss testa resultatet:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 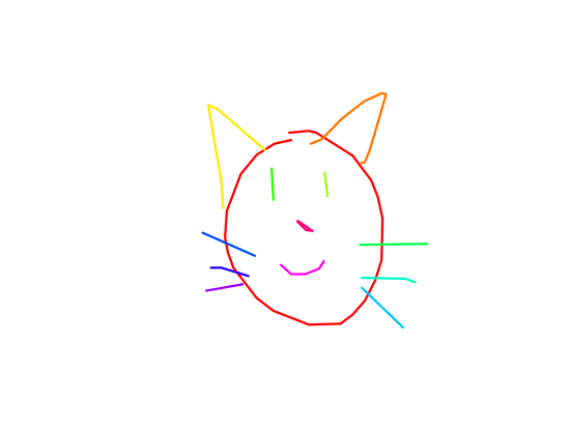
Batchen kommer att skapas på följande sätt:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Denna implementering verkade vara suboptimal, eftersom det tar oacceptabelt lång tid att skapa stora batchar, och vi bestämde oss för att dra nytta av kollegors erfarenhet genom att använda ett kraftfullt bibliotek OpenCV. Vid det tillfället fanns det inget klart paket för R (det finns fortfarande inget), så därför skrevs en minimal implementation av den begärda funktionaliteten i C++ med integration i R-koden genom Rcpp.
För att lösa problemet användes följande paket och bibliotek:
OpenCV för att arbeta med bilder och rita linjer. Vi använde förinstallerade systembibliotek och headerfiler, samt dynamisk länkning.
xtensor för att arbeta med flerdimensionella arrayer och tensorer. Vi använde headerfiler som ingår i det namngivna R-paketet. Biblioteket gör det möjligt att arbeta med flerdimensionella arrayer, både i radmajor och kolumnmajor ordning.
ndjson för att parsa JSON. Detta bibliotek används i xtensor automatiskt om det finns i projektet.
RcppThread för att organisera flertrådig bearbetning av en vektor från JSON. Vi använde headerfiler som tillhandahålls av detta paket. Det mer populära RcppParallel paketet kännetecknas bland annat av en inbyggd mekanism för att avbryta en loop (interrupt).
Det är värt att nämna att xtensor visade sig vara en riktig fynd: förutom att det har omfattande funktioner och hög prestanda, var dess utvecklare ganska responsiva och svarade snabbt och detaljerat på uppkomna frågor. Med deras hjälp kunde vi genomföra konverteringar av OpenCV-matriser till xtensor-tensorer, samt sättet att slå samman 3D-bilder till en 4D-tensor med rätt dimensioner (faktiskt en batch).
Material för att studera Rcpp, xtensor och RcppThread
För att kompilera filer som använder systemfiler och dynamisk länkning med installerade bibliotek i systemet, använde vi plugin-mekanismen som realiserades i paketet Rcpp. För att automatiskt hitta sökvägar och flaggor använde vi det populära linux-verktyget pkg-config.
Implementering av Rcpp-plugin för att använda OpenCV-biblioteket
Rcpp::registerPlugin("opencv", function() {
  # Möjliga paketnamn
  pkg_config_name <- c("opencv", "opencv4")
  # Binär fil av pkg-config-verktyget
  pkg_config_bin <- Sys.which("pkg-config")
  # Kontroll av om verktyget finns i systemet
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Kontroll av att OpenCV:s konfigurationsfil för pkg-config finns
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV-konfiguration för pkg-config hittades inte", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Som ett resultat av pluginens arbete kommer följande värden att ersättas under kompileringen:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Koden för att implementera JSON-parsing och skapa en batch för överföring till modellen presenteras under spoilern. Först lägger vi till den lokala projektkatalogen för att söka efter header-filer (nödvändigt för ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementering av omvandling av JSON till tensor i C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Denna kod bör placeras i filen src/cv_xt.cpp och kompileras med kommandot Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); dessutom behövs för arbetet nlohmann/json.hpp från . Koden är uppdelad i flera funktioner:
to_xt— en templatiserad funktion för att omvandla bildmatrisen (cv::Mat) till tensorxt::xtensor;parse_json— funktionen parsar JSON-strängen, extraherar punkternas koordinater och packar dem i en vektor;ocv_draw_lines— från den resulterande vektorn av punkter ritar den flerfärgade linjer;process— kombinerar de ovan beskrivna funktionerna samt lägger till möjlighet att skala den resulterande bilden;cpp_process_json_str— en wrapper över funktionenprocess, som exporter resultatet till ett R-objekt (flervalsmatris);cpp_process_json_vector— en wrapper över funktionencpp_process_json_str, som gör det möjligt att bearbeta en strängvektor i flertrådad läge.
För att rita flerfärgade linjer användes färgmodellen HSV med efterföljande konvertering till RGB. Låt oss testa resultatet:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 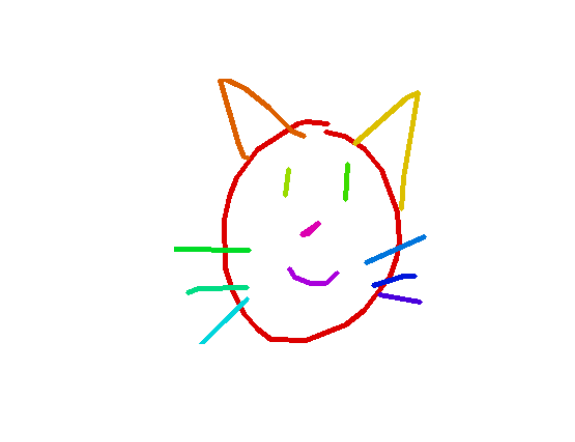
Jämförelse av hastigheten för implementationer i R och C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Benchmark Parameters
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Performing Measurement
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 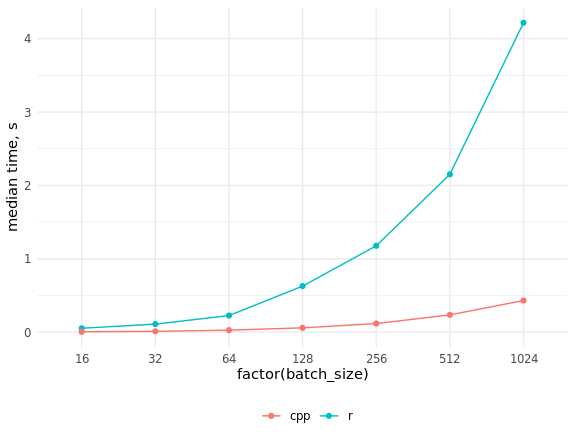
Som vi kan se var hastighetsökningen mycket betydande, och att nå kod i C++ genom parallellisering av kod i R är inte möjligt.
3. Iteratörer för att hämta batcher från databasen
R har ett välförtjänt rykte som ett språk för databehandling som ryms i RAM, medan Python typiskt kännetecknas av iterativ databehandling, vilket gör det enkelt och smidigt att implementera out-of-core beräkningar (beräkningar som använder extern minne). Ett klassiskt och relevant exempel för vår kontext är djuplärande neurala nätverk, som tränas med gradientnedstigningsmetoden med gradientapproximation vid varje steg över en liten mängd observationer, eller mini-batch.
Ramverk för djuplärande skrivna på Python har speciella klasser som implementerar iteratörer för data: tabeller, bilder i mappar, binära format etc. Man kan använda färdiga alternativ eller skriva egna för specifika uppgifter. I R kan vi dra nytta av alla möjligheter av Pythons bibliotek keras med sina olika backends via det namngivna paketet, som i sin tur fungerar ovanpå paketet reticulate. Det sistnämnda förtjänar en stor separat artikel; det möjliggör inte bara körning av Python-kod från R, utan också överföring av objekt mellan R- och Python-sessioner, och utför automatiskt alla nödvändiga typkonverteringar.
Genom att använda MonetDBLite har vi befriat oss från behovet att lagra alla data i RAM. All "neural network" -arbete kommer att utföras av originalkoden på Python; det enda vi behöver göra är att skriva en datiterator, eftersom ingen färdig lösning finns för den här situationen varken i R eller Python. Kraven på den är i praktiken två: den måste returnera batchar i en oändlig loop och spara sitt tillstånd mellan iterationer (det sista kan enkelt uppnås i R med hjälp av closures). Tidigare har vi varit tvungna att explicit konvertera R-arrayer till numpy-arrayer i iteratorn, men den aktuella versionen av paketet keras gör detta själv.
Datiteratorn för tränings- och valideringsdata ser ut som följer:
Iterator för tränings- och valideringsdata
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funktionen tar som inparameter en variabel med anslutning till DB, användarens radnummer, antal klasser, batchstorlek, skala (scale = 1 motsvarar ritning av bilder 256x256 pixlar, scale = 0.5 - 128x128 pixlar), indikator för färg (color = FALSE ställer in ritningen i gråskala, vid användning färg = SANT varje streck ritas med en ny färg) och en preprocessindikator för nätverk förutbildade på imagenet. Den senare behövs för att skala pixelvärden från intervallet [0, 1] till intervallet [-1, 1], som användes under träningen av de medföljande keras modeller.
Den externa funktionen innehåller en typkontroll för argument, en tabell data.table med slumpmässigt blandade radnummer från samples_index och batchnummer, räknare och maximalt antal batcher, samt ett SQL-uttryck för att hämta data från databasen. Dessutom definierade vi snabbt en motsvarighet till funktionen keras::to_categorical(). Vi använde nästan all data för träning och lämnade en halv procent för validering, så epokens storlek begränsades av parametern steps_per_epoch vid anropet keras::fit_generator(), och villkoret if (i > max_i) utlöste endast för valideringsiteratorn.
I den interna funktionen sker urval av radindex för den aktuella batchen, hämtning av poster från databasen med ökande batchräknare, parsning av JSON-filer (funktionen cpp_process_json_vector(), skriven i C++) och skapande av arrayer som motsvarar bilderna. Därefter skapas one-hot vektorer med klassetiketter, arrayer med pixelvärden och etiketter slås samman i en lista, som är det returnerade resultatet. För att påskynda arbetet användes skapande av index i tabeller data.table och modifiering via referens — utan dessa 'tricks' i paketet data.table är det ganska svårt att föreställa sig effektivt arbete med betydande datamängder i R.
Resultaten av hastighetsmätningarna på en bärbar dator med Core i5 ser ut som följer:
Benchmark för iteratorn
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indexes for the training set
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indexes for the validation set
val_ind <- ind[-train_ind]
rm(ind)
# Scale factor
scale <- 0.5

# Measuring performance
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 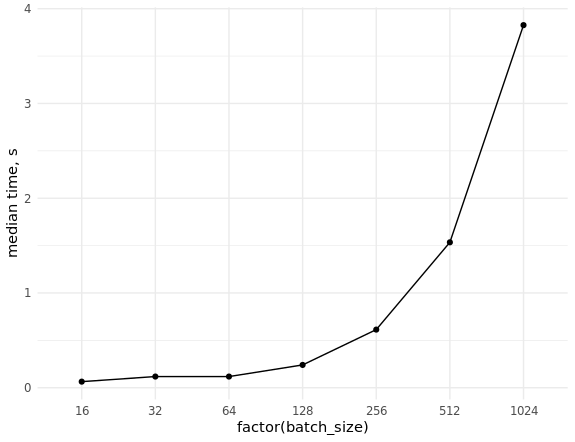
Om det finns tillräckligt med RAM kan databasens prestanda förbättras avsevärt genom att flytta den till RAM (32 GB räcker för vår uppgift). I Linux monteras som standard en partition /dev/shm, som upptar upp till hälften av RAM-volymen. Det går att reservera mer genom att redigera /etc/fstab, så att det blir en post av typen tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Vi måste starta om och kontrollera resultatet genom att köra kommandot df -h.
Iteratören för testdata ser mycket enklare ut, eftersom testdatasetet helt får plats i RAM:
Iteratören för testdata
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Val av modellarkitektur
Den första av de använda arkitekturerna var , vars egenskaper beskrivs i meddelandet. Den finns i standardinstallationen keras och är därmed tillgänglig i paketet med samma namn för R. Men när vi försökte använda den med enkanalsbilder upptäcktes något märkligt: indata-tensorn måste alltid ha dimensionerna (batch, height, width, 3), vilket innebär att antalet kanaler inte kan ändras. I Python finns det ingen sådan begränsning, så vi skyndade oss att skriva vår egen implementering av denna arkitektur, följande originalartikeln (utan dropout, som finns i den kerasiska varianten):
Architektur mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Nackdelarna med denna metod är uppenbara. Man vill kontrollera många modeller, men att skriva om varje arkitektur för hand är inte tilltalande. Dessutom förlorade vi möjligheten att använda vikterna från modeller som förtränats på imagenet. Som vanligt hjälpte det att studera dokumentationen. Funktionen get_config() låter oss få en beskrivning av modellen i ett redigerbart format (base_model_conf$layers — en vanlig R-lista), och funktionen from_config() utför en omvänd konvertering till en modellobjekt:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Nu är det enkelt att skriva en universell funktion för att hämta valfritt av de modeller som levereras med keras vikter för utbildning på imagenet eller utan dem:
Funktion för att ladda färdiga arkitekturer
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Kontroll av argument
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Hämta objekt från keras-paketet
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Kontroll av objektets existens i paketet
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " not found.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Om bilden inte är i färg, ändra dimensionen på ingången
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Vid användning av enkanelbilder används inte förutbildade vikter. Det skulle kunna åtgärdas: genom att använda funktionen get_weights() hämta modellens vikter som en lista av R-arrayer, ändra dimensionerna på det första elementet i denna lista (antingen genom att ta en färgkanal eller genom att genomsnittligt ta de tre), och sedan ladda vikterna tillbaka till modellen med funktionen set_weights(). Vi lade inte till denna funktionalitet, eftersom det på detta stadium redan var klart att det var mer effektivt att arbeta med färgkort.
Vi har genomfört de flesta experimenten med användning av mobilenet version 1 och 2, samt resnet34. I denna tävling presterade modernare arkitekturer, såsom SE-ResNeXt, bra. Tyvärr hade vi inga färdiga implementationer tillgängliga, och våra egna har vi ännu inte skrivit (men kommer definitivt att göra det).
5. Parametrisering av skripten
För bekvämlighetens skull har all kod för att köra träning presenterats i form av ett enda skript, parameteriserat med hjälp av på följande sätt:
doc <- '
Användning:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [alternativ]

Alternativ:
  -h --help                   Visa detta meddelande.
  -l --list-models            Lista tillgängliga modeller.
  -m --model=          Namn på neuralt nätverksmodell [standard: mobilenet_v2].
  -b --batch-size=    Batch-storlek [standard: 32].
  -s --scale-factor=   Skalfaktor [standard: 0.5].
  -c --color                  Använd färgade linjer [standard: FALSE].
  -d --db-dir=          Sökväg till databaskatalog [standard: Sys.getenv("db_dir")].
  -r --validate-ratio= Valideringsprovförhållande [standard: 0.995].
  -n --n-gpu=           Antal GPU:er [standard: 1].
'
args <- docopt::docopt(doc)
Paket docopt är en implementation för R. Med hjälp av detta kan skripten köras med enkla kommandon av typen Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db eller ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, om filen train_nn.R är körbar (detta kommando kommer att starta träningen av modellen resnet50 på trekanalsbilder med storleken 128x128 pixlar, databasen måste ligga i mappen /home/andrey/doodle_db). Du kan lägga till inlärningshastighet, typ av optimerare och andra konfigurerbara parametrar. Under förberedelserna av publikationen upptäckte vi att arkitekturen mobilenet_v2 från den aktuella versionen keras i R använder på grund av obeserverade förändringar i R-paketet — vi väntar på att de ska rättas till.
Denna metod gjorde det möjligt att avsevärt snabba upp experimenten med olika modeller jämfört med den mer traditionella körningen av skript i RStudio (som ett alternativ kan vi nämna paketet ). Men den största fördelen är möjligheten att enkelt hantera körningen av skripten i Docker eller bara på servern, utan att installera RStudio.
6. Dockerisering av skripten
Vi använde Docker för att säkerställa bärbarhet av miljön för träning av modeller mellan teammedlemmar och för snabb distribution i molnet. Du kan börja bekanta dig med detta relativt ovanliga verktyg för R-programmerare via en serie publikationer eller via .
Docker gör det möjligt att skapa egna bilder "från grunden" såväl som att använda andra bilder som bas för att skapa egna. Vid analys av de befintliga alternativen kom vi fram till att installationen av NVIDIA-drivrutiner, CUDA+cuDNN och Python-bibliotek är en ganska omfattande del av bilden, och vi beslöt att använda den officiella bilden som grund. tensorflow/tensorflow:1.12.0-gpu, och lägga till nödvändiga R-paket.
Den slutgiltiga Docker-filen blev som följer:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
För att underlätta organiserades de använda paketen i variabler; huvuddelen av de skrivna skripten kopieras in i containrarna vid byggandet. Vi ändrade också kommandotolken till /bin/bash för att underlätta användningen av innehållet /etc/os-release. Detta gjorde det möjligt att undvika att ange versionen av operativsystemet i koden.
Dessutom skrev vi ett litet bash-skript som gör det möjligt att starta containern med olika kommandon. Till exempel kan detta vara skripter för att träna neurala nätverk, som tidigare placerats inuti containern, eller en kommandotolk för felsökning och övervakning av containerns arbete:
Skript för att starta containern
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Om detta bash-skript körs utan några parametrar, kommer skriptet att anropas inuti containern train_nn.R med standardvärden; om det första positionsargumentet är "bash", kommer containern att startas i interaktivt läge med kommandotolken. I alla andra fall sker en substitution av positionsargumentens värden: CMD="Rscript /app/train_nn.R $@".
Det är värt att notera att katalogerna med ursprungsdata och databasen, samt katalogen för att spara de tränade modellerna, monteras in i containern från värdsystemet, vilket gör att resultaten av skriptens arbete kan nås utan ytterligare manipulationer.
7. Användning av flera GPU:er i Google Cloud
En av de utmärkande egenskaperna av tävlingen var mycket brusiga data (se omslagsbilden, lånad från @Leigh.plt från ODS-slack). Att hantera detta underlättas av stora batcher, och efter experimenten på en PC med 1 GPU bestämde vi oss för att lära oss att träna modeller på flera GPU:er i molnet. Vi använde Google Cloud () på grund av det stora utbudet av tillgängliga konfigurationer, rimliga priser och bonusar på $300. Av girighet beställdes en instans med 4xV100 med SSD och massor av RAM, och det var ett stort misstag. Sådana maskiner drar snabbt pengar, och utan en välfungerande pipeline kan man gå i konkurs vid experiment. För utbildningssyften är det bättre att ta K80. Men mängden RAM var verkligen användbar — den molnbaserade SSD:n imponerade inte med sin hastighet, så databasen flyttades för varje instansstart till dev/shm.
Den mest intressanta koden handlar om användningen av flera GPU:er. Först skapas modellen på CPU med en contexts manager, precis som i Python:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Sedan kopieras den icke-kompilerade modellen (detta är viktigt) till det angivna antalet tillgängliga GPU:er, och först därefter kompileras den:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Den klassiska metoden att frysa alla lager utom det sista, träna det sista lagret, låsa upp och finjustera hela modellen för flera GPU:er lyckades vi inte genomföra.
Vi övervakade träningen utan att använda tensorboard, begränsa sig till att logga och spara modeller med informativa namn efter varje epok:
Callback-funktioner
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Istället för en sammanfattning
En rad problem som vi har stött på har vi inte kunnat övervinna än:
- på keras det finns ingen färdig funktion för automatisk sökning av optimal inlärningshastighet (motsvarighet till
lr_finderi biblioteket fast.ai); med vissa ansträngningar kan man portera externa implementationer till R, till exempel, ; - som en följd av föregående punkt har vi inte kunnat hitta rätt inlärningshastighet vid användning av flera GPU:er;
- det saknas moderna arkitekturer för neurala nätverk, särskilt de som är förutbildade på imagenet;
- det finns ingen one cycle policy eller diskriminerande inlärningshastigheter (cosine annealing efter vår begäran var , tack ).
Vad vi kunde dra nytta av i denna tävling:
- På relativt svag hårdvara kan man utan problem arbeta med rimliga (som överstiger storleken på RAM) datavolymer. Paketet data.table sparar minne genom in-place modifiering av tabeller, vilket undviker kopiering, och vid rätt användning uppvisar det nästan alltid den högsta hastigheten bland alla verktyg vi känner till för skriptspråk. Att spara data i en databas gör att man i många fall inte ens behöver tänka på att stoppa hela datasetet i RAM.
- Långsamma funktioner i R kan ersättas med snabba i C++ med hjälp av paketet Rcpp. Om man dessutom använder RcppThread eller RcppParallel, får vi plattformsoberoende flertrådade implementationer, så koden på R-nivå behöver inte parallelliseras.
- Paketet Rcpp kan användas utan djupa kunskaper i C++, den nödvändiga minimikunskapen är redovisad . Headerfiler för en rad coola C-bibliotek som xtensor är tillgängliga på CRAN, vilket innebär att det finns infrastruktur för att genomföra projekt som integrerar färdig högpresterande C-kod i R. Ytterligare bekvämlighet är syntaxmarkering och en statisk kodanalysator för C++ i RStudio.
- docopt kan köras som fristående skript med parametrar. Detta är praktiskt för användning på en fjärrserver, inklusive under Docker. Att köra långa experiment med att träna neurala nätverk i RStudio är opraktiskt, och även installationen av IDE på servern är inte alltid motiverad.
- Docker säkerställer portabilitet av kod och reproducerbarhet av resultat mellan utvecklare med olika versioner av operativsystem och bibliotek, samt enkelhet att köra på servrar. För att starta hela träningspipan går det med bara ett kommando.
- Google Cloud är ett kostnadseffektivt sätt att experimentera med dyr hårdvara, men det är viktigt att noggrant välja konfigurationer.
- Att mäta hastigheten på olika kodfragment är mycket användbart, särskilt när man kombinerar R och C++, och med paketet bench blir det dessutom mycket enkelt.
Sammanfattningsvis var denna erfarenhet mycket nyttig, och vi fortsätter att arbeta med att lösa några av de nämnda problemen.
Källa: habr.com
