

Koden för programvaruprodukter inom maskininlärning är ofta komplex och ganska förvirrande. Att upptäcka och åtgärda buggar i den är en resurskrävande uppgift. Även de enklaste kräver ett seriöst tillvägagångssätt för nätverksarkitektur, viktinitialisering och optimering av nätverket. Ett litet misstag kan leda till oönskade problem.
Denna artikel ägnas åt algoritmen för felsökning av dina neurala nätverk.
Skillbox rekommenderar: Praktisk kurs .
Påminnelse: för alla läsare av "Habr" — 10 000 rubel rabatt vid registrering för vilken kurs som helst på Skillbox med rabattkoden "Habr".
Algoritmen består av fem steg:
- en enkel start;
- bekräftelse av förluster;
- kontroll av mellanresultat och kopplingar;
- diagnos av parametrar;
- övervakning av arbetet.
Om något verkar mer intressant än annat kan du gärna hoppa direkt till dessa avsnitt.
En enkel start
Att debugga ett neuralt nätverk med en komplex arkitektur, regularisering och inlärningshastighetsplan är svårare än för ett vanligt. Vi fuskar lite här, eftersom själva punkten för felsökningsprocessen har ett indirekt samband, men det är ändå en viktig rekommendation.
En enkel start handlar om att skapa en förenklad modell och träna den på en uppsättning (punkt) data.
Först skapar vi en förenklad modell
För snabb start skapar vi ett litet nätverk med ett enda dolt lager och kontrollerar att allt fungerar korrekt. Därefter komplicerar vi modellen gradvis, medan vi kontrollerar varje ny aspekt av dess struktur (ytterligare lager, parametrar osv.) och går vidare.
Vi tränar modellen på en enda uppsättning (punkt) data
Som en snabb kontroll av funktionaliteten i ditt projekt kan du använda en eller två datapunkter för att bekräfta att systemet fungerar korrekt. Det neurala nätverket bör visa 100% noggrannhet för träning och validering. Om detta inte är fallet, är modellen antingen för liten, eller så finns det redan en bugg.
Även om allt ser bra ut, förbered modellen för att genomgå en eller flera epoker innan du går vidare.
Utvärdering av förluster
Utvärdering av förluster är det primära sättet att precisera modellens prestanda. Du måste säkerställa att förlusten är relevant för uppgiften och att förlustfunktionerna utvärderas på rätt skala. Om du använder mer än en typ av förlust, se till att de alla är av samma ordning och korrekt skalade.
Det är viktigt att vara uppmärksam på de inledande förlusterna. Kontrollera hur nära det verkliga resultatet förväntningarna ligger om modellen startade med en slumpmässig gissning. I : "Se till att du får det resultat du förväntar dig när du börjar arbeta med ett litet antal parametrar. Det är bättre att omedelbart kontrollera dataloss (med en regelbundenhetsgrad på noll). Till exempel, för CIFAR-10 med en Softmax-klassificerare förväntar vi oss att de inledande förlusterna kommer att vara 2.302, eftersom den förväntade diffusa sannolikheten är 0,1 för varje klass (eftersom det finns 10 klasser), och Softmax-förlusten är den negativa logaritmiska sannolikheten för den korrekta klassen som –ln (0.1) = 2.302."
För det binära exemplet görs helt enkelt en liknande beräkning för varje klass. Här är till exempel data: 20 % 0:or och 80 % 1:or. Den förväntade initiala förlusten skulle bli upp till –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Om resultatet är större än 1 kan det indikera att neuronnätets vikter inte är ordentligt balanserade eller att data inte är normaliserade.
Vi kontrollerar mellanresultat och anslutningar
För att felsöka neuronnätverket är det nödvändigt att förstå dynamiken i processerna inuti nätverket och rollen för de enskilda mellanliggande lagren, eftersom de är kopplade. Här är vanliga fel som du kan stöta på:
- felaktiga uttryck för uppdateringar av gradienterna;
- uppdateringar av vikter tillämpas inte;
- försvinnande eller exploderande gradienter (exploding gradients).
Om gradientvärdena är noll betyder det att inlärningshastigheten i optimeraren är för låg, eller att du har stött på ett felaktigt uttryck för gradientuppdateringen.
Dessutom är det viktigt att övervaka värdena för aktiveringsfunktioner, vikter och uppdateringar för varje lager. Till exempel ska storleken på parameteruppdateringarna (vikter och bias) .
Det finns ett fenomen som kallas "Dying ReLU" eller , där ReLU-neuron kommer att returnera noll efter att ha lärt sig ett stort negativt värde (bias) för sina vikter. Dessa neuroner aktiveras aldrig igen någonstans i datan.
Du kan använda gradientkontroll för att identifiera dessa fel genom att approximera gradienten med en numerisk metod. Om den är nära de beräknade gradienterna så har bakåtriktad spridning implementerats korrekt. För att skapa en gradientkontroll, ta en titt på dessa fantastiska resurser från CS231 och , samt av Andrew Ng om detta ämne.
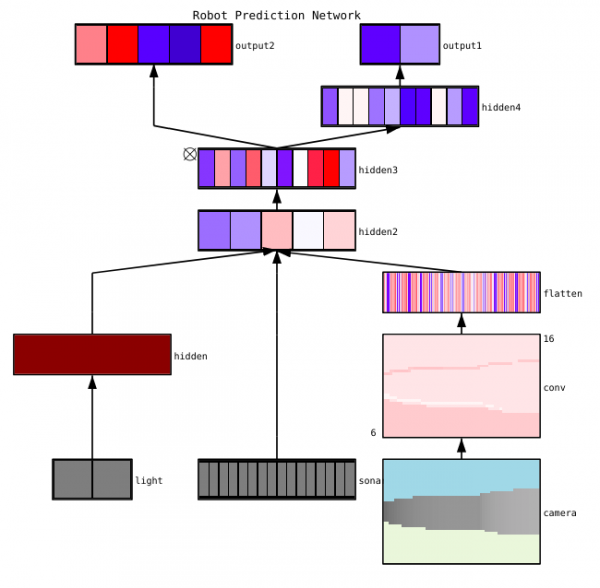
ange tre huvudsakliga metoder för att visualisera neuronnätverken:
- Förhandsgranskningar — enkla metoder som visar oss den allmänna strukturen av den tränade modellen. De inkluderar utdataformer eller filter från individuella lager av neuronnätet och parametrarna i varje lager.
- Aktiveringsbaserade. Här avkodas aktiveringar av individuella neuroner eller neurongrupper för att förstå deras funktioner.
- Gradientbaserade. Dessa metoder tenderar att manipulera de gradienter som bildas under fram- och bakåtriktad spridning vid träning av modellen (inklusive betydelsekartor och aktiveringskartor för klasser).
Det finns flera användbara verktyg för att visualisera aktiveringar och kopplingar i individuella lager, till exempel och .
Parametrdiagnostik
Neuronnät har en mängd parametrar som interagerar med varandra, vilket komplicerar optimeringen. Egentligen är denna del föremål för aktiva forskningar av specialister, så förslagen nedan bör ses som råd, utgångspunkter att utgå ifrån.
Batchstorlek (batch size) — det krävs att batchstorleken är tillräckligt stor för att få exakta bedömningar av gradientfelet, men tillräckligt liten så att stokastisk gradientnedstigning (SGD) kan ordna ditt nätverk. Små batchstorlekar leder till snabb konvergens på grund av brus i inlärningsprocessen och med tiden — svårigheter med optimeringen. Mer om detta beskrivs .
Inlärningshastighet — för låg kommer att leda till långsam konvergens eller risk för att fastna i lokala minimum. Samtidigt kommer en hög inlärningshastighet att orsaka divergens i optimeringen eftersom du riskerar att "hoppa över" en djup men smal del av förlustfunktionen. Försök att använda hastighetsplanering för att sänka den under processen av neuronnäteträningen. I kursen CS231n .
Gradientklippning — klippning av gradienterna för parametrarna under bakåtspridning enligt det maximala värdet eller den gränsnorm som är fastställd. Detta är användbart för att hantera problem med eventuella exploderande gradienter som du kan stöta på i den tredje punkten.
Batchnormalisering — används för att normalisera indata för varje lager, vilket löser problemet med inre kovariatförskjutning. Om du använder Dropout och Batchnorm tillsammans, .
Stokastisk gradientnedstigning (SGD) — det finns flera varianter av SGD som använder momentum, adaptiva inlärningshastigheter och Nesterovs metod. Ingen av dem har dock något uppenbart försprång när det gäller inlärningseffektivitet eller generalisering ().
Regulering — är avgörande för att bygga en generaliserbar modell, eftersom den lägger till ett straff för komplexiteten hos modellen eller extrema värden av parametrarna. Detta är ett sätt att minska modellens varians utan att betydligt öka dess bias. Mer .
För att själv kunna bedöma allt måste du stänga av regleringen och kontrollera gradienten av dataförlusten själv.
Dropout — är en annan metod för att ordna ditt nätverk för att förhindra överanpassning. Under träningen utförs dropout endast genom att hålla neuronens aktivitet med en viss sannolikhet p (hyperparameter) eller sätta den till noll i motsatt fall. Resultatet är att nätverket måste använda en annan delmängd av parametrar för varje träningsparti, vilket minskar förändringen av vissa parametrar som blir dominerande.
Viktigt: om du använder både dropout och batchnormalisering, var försiktig med ordningen på dessa operationer eller till och med deras gemensamma användning. Allt detta diskuteras fortfarande aktivt och utvecklas. Här är två viktiga diskussioner om detta ämne och .
Arbetstillstånd
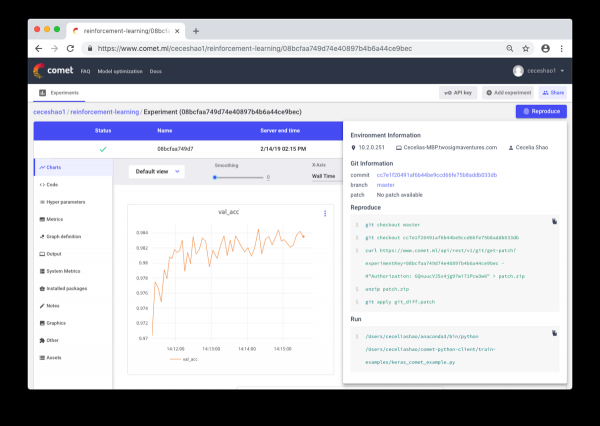
Det handlar om att dokumentera arbetsflöden och experiment. Om man inte dokumenterar något kan man exempelvis glömma vilken inlärningshastighet eller vikter av klasser som används. Tack vare kontrollen kan man enkelt översy vista och reproducera tidigare experiment. Detta minskar antalet duplicerade experiment.
Visserligen kan manuell dokumentation bli en svår uppgift när det handlar om stora mängder arbete. Här kommer verktyg som Comet.ml till hjälp, som automatiskt loggar dataset, kodändringar, experimenthistorik och produktionsmodeller, inklusive nyckelinformation om din modell (hyperparametrar, prestandamått och omgivningsinformation).
Neurala nätverk kan vara mycket känsliga för små förändringar, vilket kan leda till en försämring av modellens prestanda. Att spåra och dokumentera arbetet är det första steget för att standardisera miljön och modelleringen.
Jag hoppas att detta inlägg kan bli en utgångspunkt för dig att börja felsöka ditt neurala nätverk.
Skillbox rekommenderar:
- Tvåårig praktisk kurs .
- Onlinekurs .
- Praktisk årskurs .
Källa: habr.com
