

Utendaji wa juu ni moja ya mahitaji muhimu wakati wa kufanya kazi na data kubwa. Katika Sberbank, tunapakia takriban miamala yote kwenye Wingu letu la Data la Hadoop, kwa hivyo tunashughulikia mtiririko mkubwa wa data. Kwa kawaida, tunatafuta kila mara njia za kuboresha utendakazi, na tungependa kushiriki jinsi tulivyoweka viraka RegionServer HBase na mteja wa HDFS, na kuongeza kasi ya kusoma kwa kiasi kikubwa.
Walakini, kabla hatujafikia kiini cha maboresho, inafaa kutaja mapungufu ambayo kimsingi haiwezekani kukwepa ikiwa unatumia HDD.
Kwa nini HDD na usomaji wa haraka wa Ufikiaji Nasibu hauoani
Kama unavyojua, HBase, kama hifadhidata nyingine nyingi, huhifadhi data katika vizuizi vya makumi kadhaa ya kilobaiti. Kwa chaguo-msingi, hii ni karibu 64 KB. Sasa hebu fikiria tunahitaji kupata baiti 100 tu na kuuliza HBase irudishe data hii kwa kutumia ufunguo fulani. Kwa kuwa ukubwa wa kizuizi katika HFiles ni 64 KB, ombi litakuwa kubwa mara 640 (kwa muda mfupi tu!) kuliko lazima.
Zaidi ya hayo, kwa kuwa ombi litapitia HDFS na utaratibu wake wa kuhifadhi metadata ShortCircuitCache (ambayo inaruhusu upatikanaji wa moja kwa moja kwa faili), hii inasababisha kusoma 1 MB kutoka kwenye diski. Hata hivyo, hii inaweza kubadilishwa kwa kutumia parameter dfs.client.read.shortcircuit.buffer.size na katika hali nyingi ni mantiki kupunguza thamani hii, kwa mfano hadi 126 KB.
Hebu tuseme tunafanya hivyo, lakini tunapoanza kusoma data kupitia Java API, kwa kutumia kazi kama FileChannel.read na uulize mfumo wa uendeshaji kusoma kiasi maalum cha data, inasoma mara mbili zaidi "ikiwa tu," yaani, 256 KB kwa upande wetu. Hii hutokea kwa sababu Java haina njia rahisi ya kuweka alama ya FADV_RANDOM ili kuzuia tabia hii.
Kwa hivyo, kupata byte zetu 100, mara 2600 zaidi husomwa chini ya kofia. Inaweza kuonekana kuwa suluhisho ni dhahiri: wacha tupunguze saizi ya block hadi kilobyte, tuweke bendera iliyotajwa hapo juu, na tufikie kasi kubwa. Lakini shida ni kwamba kwa kupunguza ukubwa wa block, pia tunapunguza nusu ya idadi ya baiti zilizosomwa kwa kila kitengo cha wakati.
Faida fulani kutokana na kuweka bendera ya FADV_RANDOM inaweza kupatikana, lakini tu kwa usomaji wa juu wa maandishi mengi na ukubwa wa kizuizi wa 128 KB, lakini hii ni kiwango cha juu cha makumi kadhaa ya asilimia:
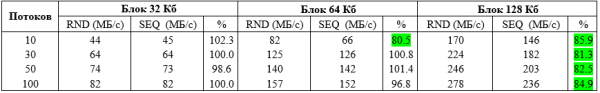
Vipimo vilifanywa kwenye faili 100, kila moja ya ukubwa wa GB 1, ziko kwenye diski 10 za HDD.
Wacha tuhesabu kile tunaweza kutarajia kwa kasi hii:
Wacha tuseme tunasoma kutoka kwa diski 10 kwa 280 MB/sec, au usomaji milioni 3 wa 100-byte. Lakini tunapokumbuka, data tunayohitaji ni ndogo mara 2600 kuliko kiasi kilichosomwa. Kwa hivyo, tunagawanya milioni 3 kwa 2600 na kupata Rekodi 1100 kwa sekunde.
Inasikitisha, sivyo? Hiyo ni asili. Ufikiaji wa Nasibu Ufikiaji wa data wa HDD-bila kujali ukubwa wa kizuizi. Hiki ndicho kikomo halisi cha ufikiaji bila mpangilio, na hakuna hifadhidata inayoweza kufikia zaidi chini ya hali hizi.
Ni vipi basi hifadhidata zinafikia kasi ya juu zaidi? Ili kujibu swali hili, hebu tuangalie kile kinachotokea katika picha ifuatayo:
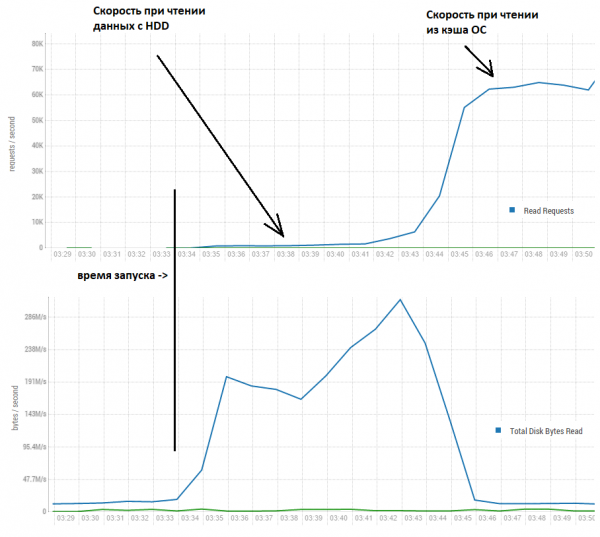
Hapa tunaona kwamba kasi ya dakika chache za kwanza ni karibu rekodi elfu kwa sekunde. Hata hivyo, baadaye, kutokana na ukweli kwamba mengi zaidi yanasomwa kuliko ilivyoombwa, data hukaa kwenye buffer/cache ya mfumo wa uendeshaji (Linux), na kasi huongezeka hadi 60 yenye heshima zaidi kwa sekunde.
Kwa hivyo, tutajadili zaidi kuongeza kasi ya ufikiaji tu kwa data iliyo kwenye akiba ya Mfumo wa Uendeshaji au iliyo katika vifaa vya kuhifadhi kama vile SSD/NVMe yenye kasi ya ufikiaji inayolinganishwa.
Kwa upande wetu, tutafanya vipimo kwenye rig inayojumuisha seva 4, ambayo kila moja inashtakiwa kama ifuatavyo.
CPU: Xeon E5-2680 v4 @ nyuzi 2.40GHz 64.
Kumbukumbu: 730 GB.
Toleo la Java: 1.8.0_111
Suala kuu hapa ni kiasi cha data kwenye jedwali zinazohitaji kusomwa. Ukisoma data kutoka kwa jedwali linalolingana kabisa na kache ya HBase, hutahitaji hata kuisoma kutoka kwa bafa/cache ya mfumo wa uendeshaji. Hii ni kwa sababu HBase, kwa chaguo-msingi, hutenga 40% ya kumbukumbu kwa muundo unaoitwa BlockCache. Hii kimsingi ni ConcurrentHashMap, ambapo ufunguo ni jina la faili + block offset, na thamani ni data halisi katika kukabiliana hiyo.
Kwa hivyo tunaposoma tu kutoka kwa muundo huu, sisi , kama maombi milioni kwa sekunde. Lakini hebu fikiria kwamba hatuwezi kujitolea mamia ya gigabytes ya kumbukumbu kwa hifadhidata pekee, kwa sababu kuna vitu vingine vingi muhimu vinavyoendesha kwenye seva hizi.
Kwa mfano, kwa upande wetu, kiasi cha BlockCache kwenye RS moja ni takriban 12 GB. Tulituma RS mbili kwenye nodi moja, kumaanisha GB 96 imetengwa kwa BlockCache kwenye nodi zote. Kiasi cha data ni kikubwa zaidi: kwa mfano, hebu sema kuna meza nne, kila moja ikiwa na mikoa 130, kila moja ikiwa na faili 800 MB zilizoshinikizwa kwa kutumia FAST_DIFF, kwa jumla ya GB 410 (hii ni data safi, yaani, bila kuzingatia replication).
Kwa hivyo, BlockCache inachukua takriban 23% tu ya jumla ya kiasi cha data, ambayo iko karibu zaidi na hali halisi ya ulimwengu wa kile kinachoitwa Data Kubwa. Na hapa ndipo mambo yanapovutia—ni wazi, kache zinavyorekodiwa kidogo, ndivyo utendakazi unavyozidi kuwa mbaya zaidi. Baada ya yote, ikiwa kosa la cache hutokea, tani ya kazi inapaswa kufanywa-yaani, chini ya wito wa kazi za mfumo. Walakini, hii haiwezi kuepukika, kwa hivyo hebu tuzingatie kipengele tofauti kabisa: nini kinatokea kwa data iliyo ndani ya kashe?
Wacha turahisishe hali hiyo na kudhani tuna kache ambayo inashikilia kitu kimoja tu. Hapa kuna mfano wa kile ambacho kingetokea ikiwa tungejaribu kufanya kazi na kiasi cha data kubwa mara tatu kuliko kache:
1. Weka kizuizi 1 kwenye kashe
2. Ondoa kizuizi 1 kutoka kwa kache
3. Weka kizuizi 2 kwenye kashe
4. Ondoa kizuizi 2 kutoka kwa kache
5. Weka kizuizi 3 kwenye kashe
Hatua tano zimefanywa! Hata hivyo, hali hii si ya kawaida; kimsingi tunalazimisha HBase kufanya kazi nyingi isiyofaa kabisa. Inasoma mara kwa mara data kutoka kwa kache ya OS, huihifadhi kwenye BlockCache, tu kuitupa mara moja wakati kundi jipya la data linapowasili. Uhuishaji ulio mwanzoni mwa chapisho unaonyesha kiini cha tatizo: Mkusanyaji wa Takataka anapitia paa, anga inapata joto, na Greta mdogo katika Uswidi ya mbali, yenye joto kali inakasirika. Na sisi watu wa IT kwa kweli hatupendi wakati watoto wana huzuni, kwa hivyo tunaanza kujiuliza tunaweza kufanya nini juu yake.
Je, ikiwa hatutahifadhi vizuizi vyote, lakini asilimia fulani tu yao, ili kache isizidi? Wacha tuanze kwa kuongeza tu mistari michache ya nambari hadi mwanzo wa kazi ambayo huhifadhi data kwenye BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Wazo hapa ni kwamba kukabiliana ni nafasi ya kizuizi katika faili, na tarakimu zake za mwisho zinasambazwa kwa nasibu na kwa usawa kutoka 00 hadi 99. Kwa hiyo, tutaruka tu zile zinazoanguka ndani ya masafa tunayohitaji.
Kwa mfano, wacha tuweke cacheDataBlockPercent = 20 na tuone kitakachotokea:
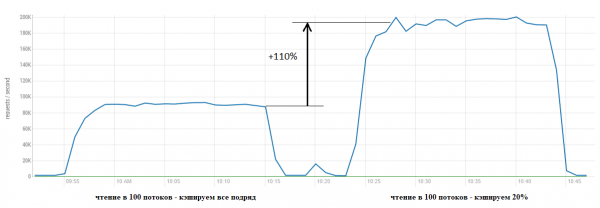
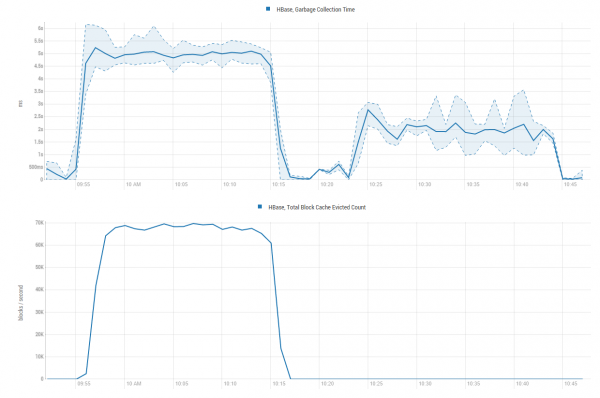
Matokeo ni wazi. Grafu zilizo hapa chini zinaweka wazi kwa nini kasi hii ilitokea-tunaokoa tani ya rasilimali za GC kwa kutolazimika kupitia kazi ya Sisyphean ya kuweka data kwenye kache ili tu kuitupa mara moja:
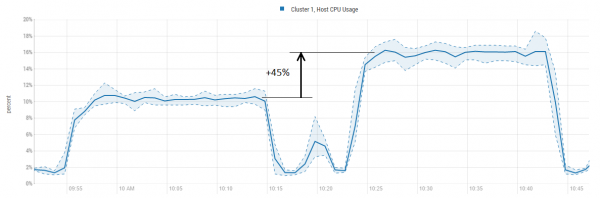
Utumiaji wa CPU huongezeka, lakini chini sana kuliko utendaji:
Inafaa pia kuzingatia kuwa vizuizi vilivyohifadhiwa kwenye BlockCache vinatofautiana. Wengi, karibu 95%, ni data halisi. Zilizosalia ni metadata, kama vile vichujio vya Bloom au LEAF_INDEX. Data hii ni ndogo, lakini ni muhimu sana, kwa sababu kabla ya kufikia data yenyewe, HBase inapata metadata ili kuamua ikiwa inahitaji kutafuta zaidi na, ikiwa ni hivyo, ni wapi hasa block ambayo inapendezwa nayo iko.
Ndio maana kwenye msimbo tunaona ukaguzi wa hali buf.getBlockType().isData() na shukrani kwa meta hii tutaiacha kwenye kashe kwa hali yoyote.
Sasa hebu tuongeze mzigo na tweak kidogo kipengele. Katika jaribio la kwanza, tuliweka asilimia ya kukata hadi 20, na BlockCache haikutumiwa kidogo. Sasa wacha tuiweke kwa 23% na tuongeze nyuzi 100 kila dakika 5 ili kuona wakati kueneza kunatokea:
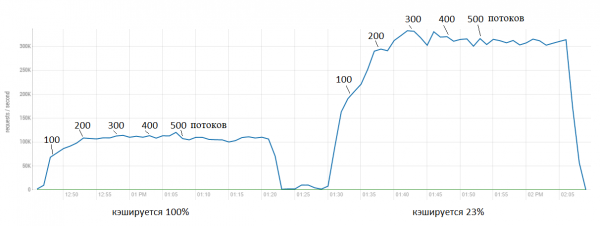
Hapa tunaona kwamba toleo asili karibu mara moja linagonga dari karibu na maombi 100 kwa sekunde. Kiraka, hata hivyo, huharakisha utendaji hadi 300. Ni wazi kuwa kuongeza kasi zaidi sio "bure," kwani utumiaji wa CPU pia huongezeka.
Hata hivyo, hii sio suluhisho la kifahari sana, kwani hatujui mapema ni asilimia ngapi ya vitalu vinavyohitaji kuhifadhiwa; inategemea wasifu wa mzigo. Kwa hiyo, tulitekeleza utaratibu wa kurekebisha kiotomatiki parameter hii kulingana na shughuli ya kusoma.
Vigezo vitatu vimeongezwa kudhibiti hii:
hbase.lru.cache.heavy.eviction.count.kikomo - huweka idadi ya mara ambazo mchakato wa kufukuza akiba unapaswa kutekelezwa kabla ya kuanza kutumia uboreshaji (yaani, kuruka vizuizi). Kwa chaguomsingi, imewekwa kuwa MAX_INT = 2147483647, ambayo inamaanisha kuwa kipengele hakitafanya kazi na thamani hii. Hii ni kwa sababu mchakato wa kufukuzwa unaendesha kila sekunde 5-10 (kulingana na mzigo), na 2147483647 * 10/60/60/24/365 = 680 miaka. Hata hivyo, tunaweza kuweka kigezo hiki hadi 0 na kulazimisha kipengele kufanya kazi mara baada ya kuanza.
Walakini, pia kuna upakiaji muhimu wa kigezo hiki. Ikiwa mzigo wetu wa kazi ni kwamba usomaji wa muda mfupi (tuseme, wakati wa mchana) na usomaji wa muda mrefu (usiku) hubadilishana kila wakati, tunaweza kusanidi kipengele ili kuwezeshwa tu wakati shughuli za kusoma kwa muda mrefu zinafanyika.
Kwa mfano, tunajua kwamba usomaji wa muda mfupi kwa kawaida huchukua kama dakika 1. Ikiwa hatuhitaji kuanza kuondoa vizuizi, akiba haitakuwa na wakati wa kuchakaa, basi tunaweza kuweka kigezo hiki, tuseme, 10. Hii itasababisha uboreshaji kuanza tu wakati usomaji amilifu wa muda mrefu unapoanza, yaani, baada ya sekunde 100. Kwa hivyo, ikiwa tuna usomaji wa muda mfupi, vitalu vyote vitahifadhiwa na kupatikana (isipokuwa wale waliofukuzwa na algorithm ya kawaida). Na tunapofanya usomaji wa muda mrefu, kipengele huwashwa, na hivyo kusababisha utendakazi wa juu zaidi.
hbase.lru.cache.heavy.eviction.mb.size.limit - huweka ni megabaiti ngapi tungependa kuweka akiba (na, kwa kawaida, kuondoa) kwa sekunde 10. Kipengele hiki kitajaribu kufikia thamani hii na kuidumisha. Wazo ni kwamba ikiwa tutaweka gigabytes kwenye kashe, itabidi pia tuondoe gigabytes, ambayo, kama tumeona hapo juu, ni ghali kabisa. Walakini, usijaribu kuiweka chini sana, kwani hii itasababisha kutoka mapema kutoka kwa hali ya kuruka kizuizi. Kwa seva zenye nguvu (karibu cores 20-40), mpangilio wa karibu 300-400 MB ni bora. Kwa mifumo ya masafa ya kati (~ 10 cores), 200-300 MB ni bora. Kwa mifumo ya hali ya chini (cores 2-5), 50-100 MB inaweza kuwa sawa (haijajaribiwa kwenye hizi).
Wacha tuangalie jinsi hii inavyofanya kazi: wacha tuseme tuliweka hbase.lru.cache.heavy.eviction.mb.size.limit = 500, kuna mzigo fulani (unasoma), na kisha kila sekunde ~ 10 tunahesabu ni ka ngapi zilifukuzwa kwa kutumia formula:
Juu = Jumla ya Baiti Zilizotolewa (MB) * 100 / Kikomo (MB) - 100;
Ikiwa 2000 MB kweli ilifukuzwa, basi Sehemu ya Juu ni sawa na:
2000 * 100 / 500 - 100 = 300%
Algoriti hujaribu kuauni zaidi ya makumi kadhaa ya asilimia, kwa hivyo kipengele kitapunguza asilimia ya vizuizi vilivyohifadhiwa, na hivyo kutekeleza utaratibu wa kurekebisha kiotomatiki.
Walakini, ikiwa mzigo umeshuka, wacha tuseme MB 200 tu ndio zimefukuzwa na Overhead imekuwa mbaya (kinachojulikana kama kuzidisha):
200 * 100 / 500 - 100 = -60%
Kipengele, kinyume chake, kitaongeza asilimia ya vizuizi vilivyohifadhiwa hadi Overhead inakuwa chanya.
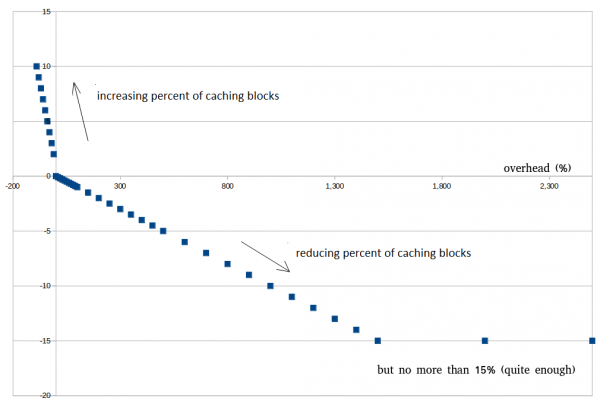
Chini ni mfano wa jinsi hii inavyoonekana kwenye data halisi. Usijaribu kufikia 0%; haiwezekani. Thamani nzuri ni karibu 30-100%; hii husaidia kuzuia kutoka mapema kutoka kwa hali ya uboreshaji wakati wa miisho ya muda mfupi.
hbase.lru.cache.heavy.eviction.overhead.mgawo - huweka jinsi tungependa kupata matokeo haraka. Iwapo tunajua kwa hakika kwamba mara nyingi usomaji wetu ni wa muda mrefu na hatutaki kusubiri, tunaweza kuongeza kipengele hiki na kufikia utendaji wa juu kwa haraka zaidi.
Kwa mfano, tunaweka mgawo huu kwa 0.01. Hii inamaanisha kuwa Sehemu ya Juu (tazama hapo juu) itazidishwa na nambari hii na thamani inayotokana itapunguzwa, na kupunguza asilimia ya vizuizi vinavyoweza kuakibishwa. Hebu sema Overhead ni 300% na mgawo ni 0.01, basi asilimia ya vitalu vya cacheable itapungua kwa 3%.
Mantiki sawa ya "Backpressure" inatekelezwa kwa maadili hasi ya Upitaji (kuzidisha). Kwa kuwa mabadiliko ya muda mfupi ya viwango vya kusoma/kuhamishwa yanawezekana kila wakati, utaratibu huu husaidia kuzuia kutoka mapema kutokana na hali ya uboreshaji. Shinikizo la nyuma lina mantiki iliyogeuzwa: kadiri upigaji risasi unavyoongezeka, ndivyo vizuizi vingi vimehifadhiwa.
Kanuni ya utekelezaji
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict()/1024/1024;
        /*
        * Sometimes we are reading more data than can fit into BlockCache
        * and it is the cause a high rate of evictions.
        * This in turn leads to heavy Garbage Collector works.
        * So a lot of blocks put into BlockCache but never read,
        * but spending a lot of CPU resources.
        * Here we will analyze how many bytes were freed and decide
        * decide whether the time has come to reduce amount of caching blocks.
        * It help avoid put too many blocks into BlockCache
        * when evict() works very active and save CPU for other jobs.
        * More delails: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // First of all we have to control how much time
        // has passed since previuos evict() was launched
        // This is should be almost the same time (+/- 10s)
        // because we get comparable volumes of freed bytes each time.
        // 10s because this is default period to run evict() (see above this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Here we have to calc what situation we have got.
          // We have the limit "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // and can calculte overhead on it.
          // We will use this information to decide,
          // how to change percent of caching blocks.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Now we are in the situation when we are above the limit
            // But maybe we are going to ignore it because it will end quite soon
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // It is going for a long time and we have to reduce of caching
              // blocks now. So we calculate here how many blocks we want to skip.
              // It depends on:
             // 1. Overhead - if overhead is big we could more aggressive
              // reducing amount of caching blocks.
              // 2. How fast we want to get the result. If we know that our
              // heavy reading for a long time, we don't want to wait and can
              // increase the coefficient and get good performance quite soon.
              // But if we don't sure we can do it slowly and it could prevent
              // premature exit from this mode. So, when the coefficient is
              // higher we can get better performance when heavy reading is stable.
              // But when reading is changing we can adjust to it and set
              // the coefficient to lower value.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // But practice shows that 15% of reducing is quite enough.
              // We are not greedy (it could lead to premature exit).
              change = Math.min(15, change);
              change = Math.max(0, change); // I think it will never happen but check for sure
              // So this is the key point, here we are reducing % of caching blocks
              cache.cacheDataBlockPercent -= change;
              // If we go down too deep we have to stop here, 1% any way should be.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Well, we have got overshooting.
            // Mayby it is just short-term fluctuation and we can stay in this mode.
            // It help avoid permature exit during short-term fluctuation.
            // If overshooting less than 90%, we will try to increase the percent of
            // caching blocks and hope it is enough.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Simple logic: more overshooting - more caching blocks (backpressure)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // But it can't be more then 100%, so check it.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Looks like heavy reading is over.
              // Just exit form this mode.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache evicted (MB): {}, overhead (%): {}, " +
            "heavy eviction counter: {}, " +
            "current caching DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Wacha sasa tuangalie haya yote kwa kutumia mfano wa ulimwengu halisi. Tunayo hali ifuatayo ya jaribio:
- Wacha tuanze kufanya Scan (nyuzi 25, bechi = 100)
- Baada ya dakika 5, ongeza vitu vingi (nyuzi 25, bechi = 100)
- Baada ya dakika 5, zima upataji mwingi (uchanganuzi pekee unabaki tena)
Tunafanya runs mbili, kwanza na hbase.lru.cache.heavy.eviction.count.limit = 10000 (ambayo inalemaza kipengele kwa ufanisi), na kisha tunaweka kikomo = 0 (ambayo inawezesha).
Katika kumbukumbu hapa chini, tunaona jinsi kipengele kinawezeshwa, na kupunguza overshooting hadi 14-71%. Mara kwa mara, mzigo hupungua, ambayo husababisha Backpressure, na HBase huhifadhi vizuizi zaidi tena.
Rekodi ya Seva ya Mkoa
iliyofukuzwa (MB): 0, uwiano 0.0, sehemu ya juu (%): -100, kaunta nzito ya uondoaji: 0, Kizuizi cha sasa cha akiba (%): 100
iliyofukuzwa (MB): 0, uwiano 0.0, sehemu ya juu (%): -100, kaunta nzito ya uondoaji: 0, Kizuizi cha sasa cha akiba (%): 100
iliyoondolewa (MB): 2170, uwiano 1.09, sehemu ya juu (%): 985, kaunta nzito ya uondoaji: 1, Uhifadhi wa sasa wa DataBlock (%): 91 < start
iliyofukuzwa (MB): 3763, uwiano 1.08, juu (%): 1781, kaunta nzito ya kufukuza: 2, DataBlock ya sasa ya akiba (%): 76
iliyofukuzwa (MB): 3306, uwiano 1.07, juu (%): 1553, kaunta nzito ya kufukuza: 3, DataBlock ya sasa ya akiba (%): 61
iliyofukuzwa (MB): 2508, uwiano 1.06, juu (%): 1154, kaunta nzito ya kufukuza: 4, DataBlock ya sasa ya akiba (%): 50
iliyofukuzwa (MB): 1824, uwiano 1.04, juu (%): 812, kaunta nzito ya kufukuza: 5, DataBlock ya sasa ya akiba (%): 42
iliyofukuzwa (MB): 1482, uwiano 1.03, juu (%): 641, kaunta nzito ya kufukuza: 6, DataBlock ya sasa ya akiba (%): 36
iliyofukuzwa (MB): 1140, uwiano 1.01, juu (%): 470, kaunta nzito ya kufukuza: 7, DataBlock ya sasa ya akiba (%): 32
iliyofukuzwa (MB): 913, uwiano 1.0, juu (%): 356, kaunta nzito ya kufukuza: 8, DataBlock ya sasa ya akiba (%): 29
iliyofukuzwa (MB): 912, uwiano 0.89, juu (%): 356, kaunta nzito ya kufukuza: 9, DataBlock ya sasa ya akiba (%): 26
iliyofukuzwa (MB): 684, uwiano 0.76, juu (%): 242, kaunta nzito ya kufukuza: 10, DataBlock ya sasa ya akiba (%): 24
iliyofukuzwa (MB): 684, uwiano 0.61, juu (%): 242, kaunta nzito ya kufukuza: 11, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 456, uwiano 0.51, juu (%): 128, kaunta nzito ya kufukuza: 12, DataBlock ya sasa ya akiba (%): 21
iliyofukuzwa (MB): 456, uwiano 0.42, juu (%): 128, kaunta nzito ya kufukuza: 13, DataBlock ya sasa ya akiba (%): 20
iliyofukuzwa (MB): 456, uwiano 0.33, juu (%): 128, kaunta nzito ya kufukuza: 14, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 15, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 342, uwiano 0.32, juu (%): 71, kaunta nzito ya kufukuza: 16, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 342, uwiano 0.31, juu (%): 71, kaunta nzito ya kufukuza: 17, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.3, juu (%): 14, kaunta nzito ya kufukuza: 18, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.29, juu (%): 14, kaunta nzito ya kufukuza: 19, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.27, juu (%): 14, kaunta nzito ya kufukuza: 20, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.25, juu (%): 14, kaunta nzito ya kufukuza: 21, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.24, juu (%): 14, kaunta nzito ya kufukuza: 22, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.22, juu (%): 14, kaunta nzito ya kufukuza: 23, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.21, juu (%): 14, kaunta nzito ya kufukuza: 24, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.2, juu (%): 14, kaunta nzito ya kufukuza: 25, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 228, uwiano 0.17, juu (%): 14, kaunta nzito ya kufukuza: 26, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 456, uwiano 0.17, sehemu ya juu (%): 128, kaunta nzito ya kufukuza: 27, Uhifadhi wa sasa wa DataBlock (%): 18 < imeongezwa inapata (lakini jedwali sawa)
iliyofukuzwa (MB): 456, uwiano 0.15, juu (%): 128, kaunta nzito ya kufukuza: 28, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 342, uwiano 0.13, juu (%): 71, kaunta nzito ya kufukuza: 29, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 342, uwiano 0.11, juu (%): 71, kaunta nzito ya kufukuza: 30, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 342, uwiano 0.09, juu (%): 71, kaunta nzito ya kufukuza: 31, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 228, uwiano 0.08, juu (%): 14, kaunta nzito ya kufukuza: 32, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 228, uwiano 0.07, juu (%): 14, kaunta nzito ya kufukuza: 33, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 228, uwiano 0.06, juu (%): 14, kaunta nzito ya kufukuza: 34, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 228, uwiano 0.05, juu (%): 14, kaunta nzito ya kufukuza: 35, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 228, uwiano 0.05, juu (%): 14, kaunta nzito ya kufukuza: 36, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 228, uwiano 0.04, juu (%): 14, kaunta nzito ya kufukuza: 37, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 109, uwiano 0.04, sehemu ya juu (%): -46, kaunta nzito ya uondoaji: 37, Uhifadhi wa sasa wa DataBlock (%): 22 < shinikizo la nyuma
iliyofukuzwa (MB): 798, uwiano 0.24, juu (%): 299, kaunta nzito ya kufukuza: 38, DataBlock ya sasa ya akiba (%): 20
iliyofukuzwa (MB): 798, uwiano 0.29, juu (%): 299, kaunta nzito ya kufukuza: 39, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 570, uwiano 0.27, juu (%): 185, kaunta nzito ya kufukuza: 40, DataBlock ya sasa ya akiba (%): 17
iliyofukuzwa (MB): 456, uwiano 0.22, juu (%): 128, kaunta nzito ya kufukuza: 41, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 342, uwiano 0.16, juu (%): 71, kaunta nzito ya kufukuza: 42, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 342, uwiano 0.11, juu (%): 71, kaunta nzito ya kufukuza: 43, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 228, uwiano 0.09, juu (%): 14, kaunta nzito ya kufukuza: 44, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 228, uwiano 0.07, juu (%): 14, kaunta nzito ya kufukuza: 45, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 228, uwiano 0.05, juu (%): 14, kaunta nzito ya kufukuza: 46, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 222, uwiano 0.04, juu (%): 11, kaunta nzito ya kufukuza: 47, DataBlock ya sasa ya akiba (%): 16
iliyofukuzwa (MB): 104, uwiano 0.03, sehemu ya juu (%): -48, kaunta nzito ya uondoaji: 47, Uhifadhi wa sasa wa DataBlock (%): 21 < kukatiza kunapata
iliyofukuzwa (MB): 684, uwiano 0.2, juu (%): 242, kaunta nzito ya kufukuza: 48, DataBlock ya sasa ya akiba (%): 19
iliyofukuzwa (MB): 570, uwiano 0.23, juu (%): 185, kaunta nzito ya kufukuza: 49, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 342, uwiano 0.22, juu (%): 71, kaunta nzito ya kufukuza: 50, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 228, uwiano 0.21, juu (%): 14, kaunta nzito ya kufukuza: 51, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 228, uwiano 0.2, juu (%): 14, kaunta nzito ya kufukuza: 52, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 228, uwiano 0.18, juu (%): 14, kaunta nzito ya kufukuza: 53, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 228, uwiano 0.16, juu (%): 14, kaunta nzito ya kufukuza: 54, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 228, uwiano 0.14, juu (%): 14, kaunta nzito ya kufukuza: 55, DataBlock ya sasa ya akiba (%): 18
iliyofukuzwa (MB): 112, uwiano 0.14, sehemu ya juu (%): -44, kaunta nzito ya uondoaji: 55, Uhifadhi wa sasa wa DataBlock (%): 23 < shinikizo la nyuma
iliyofukuzwa (MB): 456, uwiano 0.26, juu (%): 128, kaunta nzito ya kufukuza: 56, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.31, juu (%): 71, kaunta nzito ya kufukuza: 57, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 58, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 59, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 60, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 61, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 62, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 63, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.32, juu (%): 71, kaunta nzito ya kufukuza: 64, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 65, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 66, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.32, juu (%): 71, kaunta nzito ya kufukuza: 67, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 68, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.32, juu (%): 71, kaunta nzito ya kufukuza: 69, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.32, juu (%): 71, kaunta nzito ya kufukuza: 70, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 71, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 72, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 73, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 74, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 75, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 342, uwiano 0.33, juu (%): 71, kaunta nzito ya kufukuza: 76, DataBlock ya sasa ya akiba (%): 22
iliyofukuzwa (MB): 21, uwiano 0.33, sehemu ya juu (%): -90, kaunta nzito ya uondoaji: 76, Kizuizi cha sasa cha akiba (%): 32
iliyofukuzwa (MB): 0, uwiano 0.0, sehemu ya juu (%): -100, kaunta nzito ya uondoaji: 0, Kizuizi cha sasa cha akiba (%): 100
iliyofukuzwa (MB): 0, uwiano 0.0, sehemu ya juu (%): -100, kaunta nzito ya uondoaji: 0, Kizuizi cha sasa cha akiba (%): 100
Michanganuo ilihitajika ili kuonyesha mchakato huu kama grafu ya uhusiano kati ya sehemu mbili za kache-moja (ambapo vizuizi ambavyo havijawahi kuombwa huhifadhiwa) na vingi (ambapo data "imeombwa" angalau mara moja huhifadhiwa):
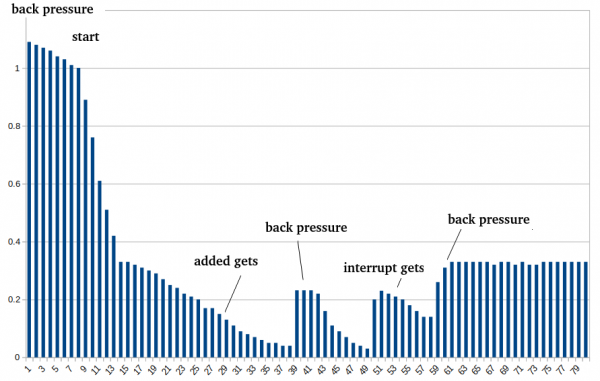
Hatimaye, hapa kuna grafu ya jinsi vigezo vinavyofanya kazi. Kwa kulinganisha, akiba ilizimwa kabisa mwanzoni, kisha HBase ilizinduliwa na uhifadhi kuwezeshwa na uboreshaji kuanza kucheleweshwa kwa dakika 5 (mizunguko 30 ya kufukuzwa).
Nambari kamili inaweza kupatikana katika Ombi la Kuvuta. kwenye github.
Walakini, usomaji 300 kwa sekunde sio yote ambayo yanaweza kupatikana kwenye vifaa hivi chini ya hali hizi. Wakati wa kupata data kupitia HDFS, utaratibu wa ShortCircuitCache (SSC) hutumiwa, kuruhusu upatikanaji wa data moja kwa moja, kuepuka mwingiliano wa mtandao.
Profaili ilionyesha kuwa utaratibu huu, ingawa hutoa faida kubwa, pia wakati fulani unakuwa kizuizi, kwa sababu karibu shughuli zote nzito hufanyika ndani ya kufuli, ambayo husababisha kuzuia wakati mwingi.
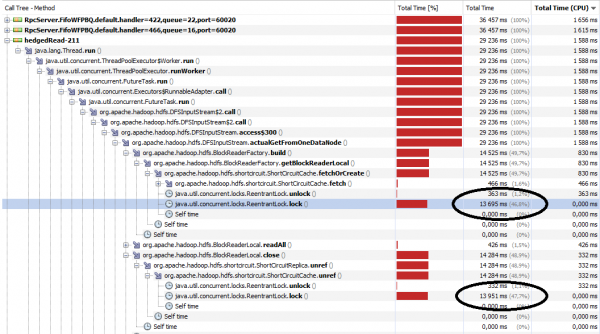
Baada ya kugundua hili, tuligundua kuwa shida inaweza kuepukwa kwa kuunda safu ya SSC huru:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Na kisha fanya kazi nao, ukiondoa makutano pia kulingana na nambari ya mwisho ya kukabiliana:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Sasa tunaweza kuanza majaribio. Tutatumia programu rahisi yenye nyuzi nyingi kusoma faili kutoka HDFS. Tutaweka vigezo vifuatavyo:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // по дефолту = 1 МБ и это сильно замедляет чтение, поэтому лучше привести в соответствие к реальным нуждам
conf.set("dfs.client.short.circuit.num", num); // от 1 до 10
Na soma faili tu:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i < count; i++) {
    position += 65536;
    if (position > 900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Nambari hii inaendeshwa kwa nyuzi tofauti, na tutaongeza idadi ya faili zilizosomwa kwa wakati mmoja (kutoka 10 hadi 200-mhimili mlalo) na idadi ya kache (kutoka 1 hadi 10-grafu). Mhimili wima unaonyesha kasi inayotolewa kwa kuongeza SSC inayohusiana na kesi iliyo na kashe moja tu.
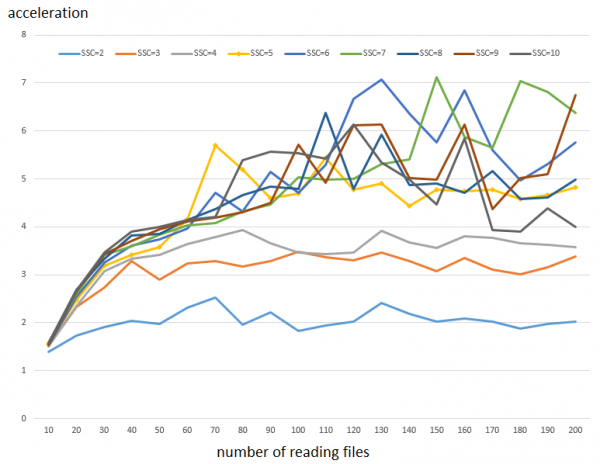
Jinsi ya kusoma grafu: 100,000 inasomwa katika vizuizi 64 KB na kashe moja huchukua sekunde 78. Na kache tano, hii inakamilishwa katika sekunde 16. Hii inawakilisha kasi ya ~ 5x. Kama grafu inavyoonyesha, athari haionekani sana kwa idadi ndogo ya usomaji sambamba, lakini inaonekana wakati kuna nyuzi zaidi ya 50 zilizosomwa. Inajulikana pia kuwa kuongeza idadi ya SSC kutoka 6 na zaidi hutoa nyongeza ndogo ya utendaji.
Kumbuka 1: Kwa kuwa matokeo ya jaribio ni tete kabisa (tazama hapa chini), mikimbio 3 ilifanyika na maadili yaliyopatikana yalikadiriwa.
Kumbuka 2: Faida ya utendaji kutokana na kusanidi ufikiaji bila mpangilio ni sawa, ingawa ufikiaji wenyewe ni wa polepole kidogo.
Walakini, ni muhimu kutambua kuwa, tofauti na HBase, kuongeza kasi hii sio bure kila wakati. Hapa, kimsingi "tunafungua" uwezo wa CPU kufanya kazi, badala ya kuifunga kwa sababu ya kufuli.
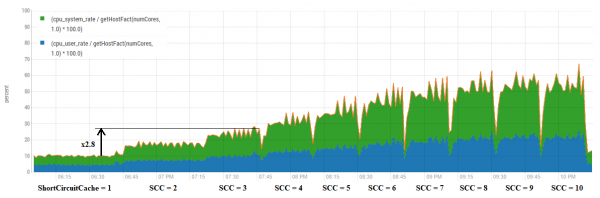
Hapa tunaweza kuona kwamba, kwa ujumla, kuongeza idadi ya kache husababisha ongezeko la takriban sawia la utumiaji wa CPU. Walakini, kuna mchanganyiko wa faida zaidi.
Kwa mfano, hebu tuangalie kwa karibu mpangilio wa SSC = 3. Ongezeko la utendaji katika safu nzima ni takriban mara 3.3. Ifuatayo ni matokeo ya mbio zote tatu tofauti.
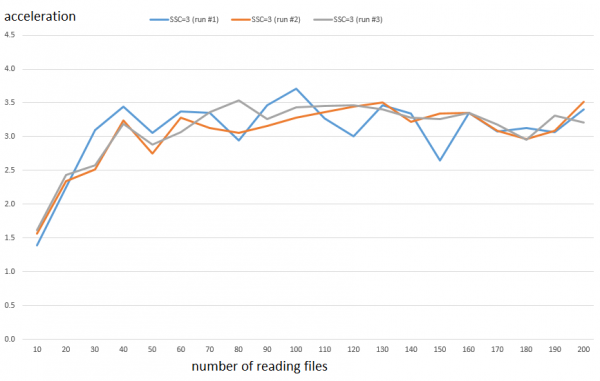
Wakati huo huo, matumizi ya CPU huongezeka kwa takriban mara 2.8. Tofauti si kubwa, lakini Greta mdogo tayari ana furaha, na labda atakuwa na wakati wa kuhudhuria shule na kuhudhuria masomo.
Kwa hivyo, hii itakuwa na athari nzuri kwa chombo chochote kinachotumia ufikiaji wa wingi kwa HDFS (kwa mfano, Spark, nk), mradi nambari ya maombi ni nyepesi (yaani, kizuizi kiko upande wa mteja wa HDFS) na kuna uwezo wa CPU. Ili kuthibitisha hili, hebu tujaribu athari iliyounganishwa ya uboreshaji wa BlockCache na urekebishaji wa SSC kwa usomaji kutoka HBase.
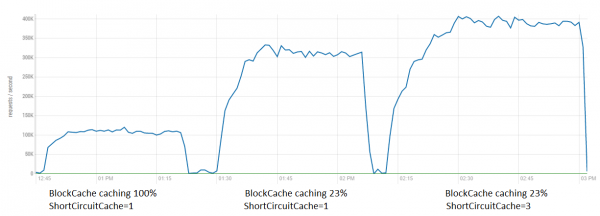
Hapa unaweza kuona kuwa chini ya hali hizi, athari sio muhimu kama katika majaribio yaliyosafishwa (kusoma bila usindikaji wowote), lakini bado inawezekana kubana 80K ya ziada. Kwa kuunganishwa, uboreshaji wote hutoa hadi kasi ya 4x.
PR pia iliundwa kwa uboreshaji huu. , ambayo iliunganishwa na utendakazi huu utapatikana katika matoleo yajayo.
Hatimaye, ilikuwa ya kuvutia kulinganisha utendaji wa kusoma wa hifadhidata ya safu wima pana sawa, Cassandra na HBase.
Kwa madhumuni haya, matukio ya matumizi ya kawaida ya kupima upakiaji wa YCSB yalizinduliwa kutoka kwa wapangishi wawili (nyuzi 800 kwa jumla). Kwa upande wa seva, matukio manne ya RegionServer na Cassandra yaliendeshwa na wapangishi wanne (sio wale wanaoendesha wateja, ili kuepusha athari zao). Usomaji ulifanywa kutoka kwa jedwali la saizi zifuatazo:
HBase — GB 300 kwenye HDFS (GB 100 ya data ghafi)
Cassandra - GB 250 (sababu ya kurudia = 3)
Hiyo ni, sauti ilikuwa takriban sawa (katika HBase ilikuwa kubwa kidogo).
Vigezo vya HBase:
dfs.client.short.circuit.num = 5 (Uboreshaji wa mteja wa HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 - hii inamaanisha kuwa kiraka kitaanza kufanya kazi baada ya kufukuzwa 30 (~ dakika 5)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 - akiba inayolengwa na kiasi cha uhamishaji
Kumbukumbu za YCSB zilichanganuliwa na kukusanywa katika grafu za Excel:
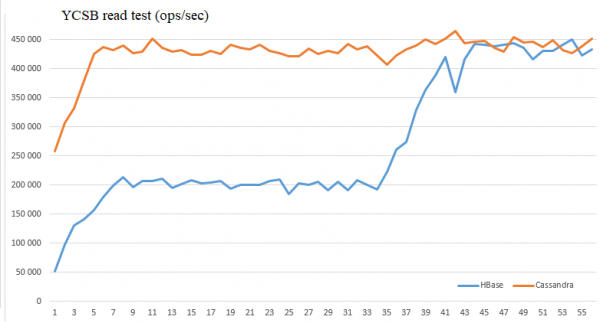
Kama inavyoonekana, uboreshaji huu hufanya iwezekane kusawazisha utendaji wa hifadhidata hizi chini ya hali hizi na kufikia usomaji elfu 450 kwa sekunde.
Tunatumahi kuwa habari hii inaweza kuwa muhimu kwa mtu katika mapambano ya kusisimua ya uzalishaji.
Chanzo: mapenzi.com
