

Habari Habr! Tunawaalika Wahandisi wa Data na wataalamu wa Kujifunza kwa Mashine kwenye somo la onyesho lisilolipishwa. Pia tunachapisha makala ya Luca Monno, Mkuu wa Uchanganuzi wa Fedha katika CDP SpA.
Mojawapo ya njia muhimu na rahisi za kujifunza kwa mashine ni Kujifunza kwa Ensemble. Ensemble Learning ndiyo njia iliyo nyuma ya XGBoost, Bagging, Random Forest, na algoriti zingine nyingi.
Kuna nakala nyingi nzuri juu ya Sayansi ya Takwimu, lakini nimechukua hadithi mbili ( и ), ambayo niliipenda zaidi. Kwa hivyo kwa nini uandike nakala nyingine kuhusu EL? Kwa sababu nataka kukuonyesha, jinsi inavyofanya kazi na mfano rahisi, jambo ambalo lilinifanya nitambue kuwa hapakuwa na uchawi.
Nilipoona EL akifanya kazi kwa mara ya kwanza (akifanya kazi na mifano michache rahisi ya rejista) sikuamini macho yangu, na bado namkumbuka profesa aliyenifundisha njia hii.
Nilikuwa na mifano miwili tofauti (algorithms mbili dhaifu za kujifunza) na metriki zifuatazo: nje ya sampuli R² sawa na 0,90 na 0,93, mtawalia. Kabla ya kuangalia matokeo, nilitarajia R² mahali pengine kati ya maadili mawili ya awali. Kwa maneno mengine, niliamini kuwa EL inaweza kutumika kuhakikisha kuwa mfano huo haufanyi kazi vibaya kama mfano mbaya zaidi, lakini pia sio kama mfano bora unaweza kufanya.
Kwa mshangao wangu mkubwa, matokeo ya wastani wa utabiri yalitoa R² ya 0,95.
Mwanzoni nilianza kutafuta kosa, lakini nilifikiri kwamba kunaweza kuwa na uchawi fulani umefichwa hapa!
Kujifunza kwa Ensemble ni nini?
EL inaweza kutumika kuchanganya ubashiri wa miundo miwili au zaidi ili kutoa kielelezo thabiti na tendaji zaidi. Kuna mbinu nyingi za kufanya kazi na ensembles za mfano. Hapa, nitagusa mbili kati ya zile muhimu zaidi ili kutoa muhtasari wa jumla.
Pamoja na kurudi nyuma Unaweza wastani wa utendaji wa mifano iliyopo.
Pamoja na uainishaji Mifano zinaweza kupewa fursa ya kuchagua lebo zao. Lebo ambayo huchaguliwa mara nyingi zaidi itakuwa ile iliyochaguliwa na mtindo mpya.
Kwa nini EL Inafanya Kazi Bora
Sababu kuu kwa nini EL inafanya kazi vyema zaidi ni kwamba kila utabiri una hitilafu (tunajua hili kutokana na nadharia ya uwezekano), kuchanganya ubashiri mbili kunaweza kusaidia kupunguza hitilafu, na kwa hivyo kuboresha metriki za utendaji (RMSE, R², nk.).
Mchoro ufuatao unaonyesha jinsi algoriti mbili dhaifu zinavyofanya kazi kwenye mkusanyiko wa data. Algorithm ya kwanza ina mteremko ambao ni mkubwa kuliko inavyotarajiwa, wakati ya pili ina mteremko ambao ni karibu sifuri (labda kwa sababu ya urekebishaji kupita kiasi). Lakini Ensemble inaonyesha matokeo bora zaidi.
Ikiwa tutaangalia kiashiria cha R², basi kwa algorithms ya mafunzo ya kwanza na ya pili itakuwa sawa na -0.01¹, 0.22, mtawaliwa, wakati kwa kukusanyika itakuwa sawa na 0.73.
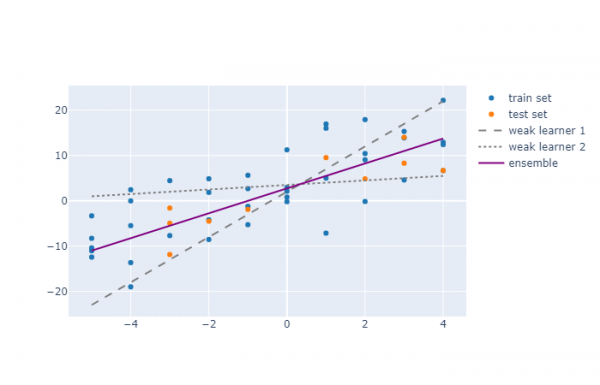
Kuna sababu nyingi kwa nini algorithm inaweza kuwa mfano mbaya hata kwenye mfano wa kimsingi kama huu: labda uliamua kutumia urekebishaji ili kuzuia kufifia kupita kiasi, au uliamua kutotenga makosa kadhaa, au labda ulitumia urekebishaji wa polynomial na ukachagua digrii isiyofaa (kwa mfano, ulitumia polynomial ya digrii ya pili, lakini data ya jaribio inaonyesha ulinganifu wazi ambao ungefaa zaidi polynomial ya digrii ya tatu).
Wakati EL inafanya kazi vizuri zaidi
Wacha tuchunguze algorithms mbili za mafunzo zinazofanya kazi na data sawa.
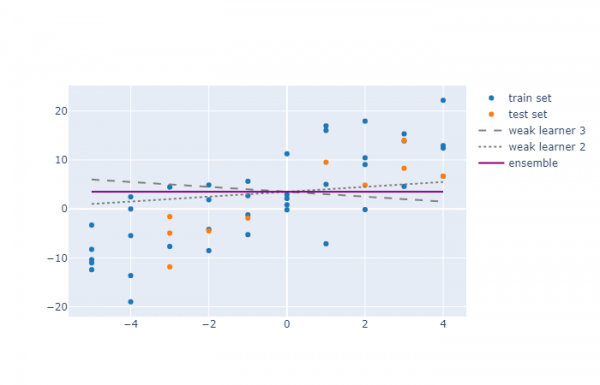
Hapa tunaona kwamba kuchanganya mifano miwili haikuboresha sana utendaji. Hapo awali, maadili ya R² ya algorithms mbili za mafunzo yalikuwa -0,37 na 0,22, mtawaliwa, wakati thamani ya kukusanyika ilikuwa -0,04. Hii inamaanisha kuwa muundo wa EL ulipata thamani ya wastani ya utendakazi.
Walakini, kuna tofauti kubwa kati ya mifano hii miwili: katika mfano wa kwanza, makosa ya mfano yaliunganishwa vibaya, wakati ya pili yaliunganishwa vyema (mgawo wa mifano hiyo mitatu haikukadiriwa, lakini ilichaguliwa tu na mwandishi kama mfano.)
Kwa hivyo, Kujifunza kwa Ensemble kunaweza kutumiwa kuboresha usawa wa upendeleo/tofauti kwa hali yoyote, lakini lini hitilafu za mfano hazihusiani vyema, kutumia EL kunaweza kusababisha utendakazi ulioboreshwa.
Mifano ya homogeneous na tofauti
EL mara nyingi hutumiwa na mifano ya homogeneous (kama katika mfano huu au katika msitu wa random), lakini kwa kweli, unaweza kuchanganya mifano tofauti (regression linear + neural network + XGBoost) na seti tofauti za vigezo vya maelezo. Hii inaweza kusababisha makosa ambayo hayajaunganishwa na utendakazi ulioboreshwa.
Kulinganisha na mseto kwingineko
EL inafanya kazi kwa njia sawa na mseto katika nadharia ya kwingineko, lakini ni bora kwetu.
Mseto ni kuhusu kupunguza tofauti za utendakazi wako kwa kuwekeza katika hisa zisizo na uhusiano. Kwingineko ya hisa iliyogawanywa vizuri itafanya vizuri zaidi kuliko hisa mbaya zaidi ya mtu binafsi, lakini kamwe haitakuwa bora zaidi kuliko bora zaidi.
Ili kumnukuu Warren Buffett:
"Mseto ni ulinzi dhidi ya ujinga; kwa mtu ambaye hajui anachofanya, [mseto] ina maana ndogo sana."
Katika kujifunza kwa mashine, EL husaidia kupunguza utofauti wa muundo wako, lakini inaweza kusababisha muundo wenye utendaji bora kwa ujumla kuliko muundo bora wa awali.
Jumla juu
Kuchanganya miundo mingi kuwa moja ni mbinu rahisi ambayo inaweza kutatua tatizo la upendeleo wa tofauti na kuboresha utendakazi.
Ikiwa una mifano miwili au zaidi inayofanya kazi vizuri, usichague kati yao: tumia zote (lakini kwa tahadhari)!
Je, una nia ya kuendeleza katika mwelekeo huu? Jisajili kwa somo la onyesho lisilolipishwa na ushiriki - Mhandisi wa Kujifunza kwa Mashine katika Kikundi cha Mail.ru.
Chanzo: mapenzi.com
