

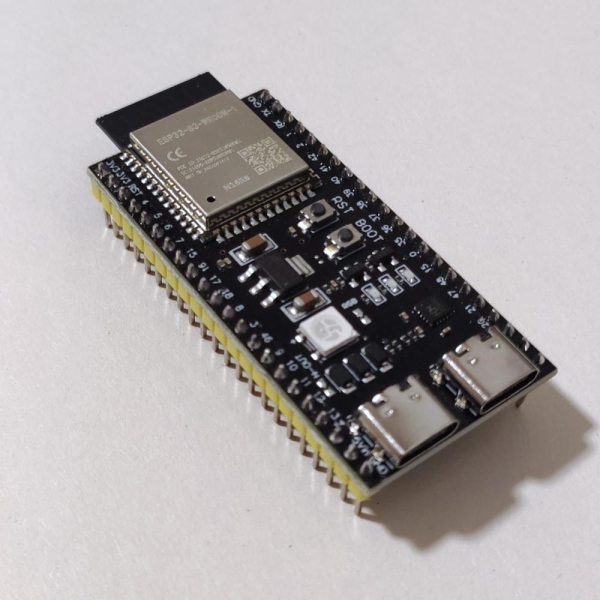
Розробник В'ячеслав Сербов, який виступає під псевдонімом slvDev, продемонстрував повністю локальну генерацію тексту на мікроконтролер ESP32-S3. Створена ним мовна модель містить 28,9 параметрів і видає близько 9,9 токена в секунду, не звертаючись до сервера або інших зовнішніх обчислювальних ресурсів. Короткі розповіді, що згенерували, виводяться на підключений OLED-дисплей.
Проект esp32-ai випробуваний на модулі ESP32-S3 N16R8, що має 512 КБ вбудованої SRAM, 8 МБ PSRAM і 16 МБ флеш-пам'яті. Квантована до чотирьох бітів модель займає 14,9 МБ. У репозиторії опубліковані вихідний код середовища виконання на C, засоби навчання та квантування моделі, прошивка, тести та сценарії її завантаження на плату.
Заявлені 28,9 параметрів не слід прямо порівнювати з числом параметрів звичайних настільних LLM. Згідно докладний звіт розробника, Модель складається з щільного обчислювального ядра приблизно на 559 тисяч параметрів, вихідного шару на 3,1 млн параметрів та таблиці пошарових векторних уявлень приблизно на 25 млн параметрів. Саме остання забезпечує основну частину формального розміру моделі, але не обробляється цілком при генерації кожного токена.
Для розміщення моделі задіяно три рівні пам'яті. Дані, що найчастіше використовуються, знаходяться у внутрішній SRAM, вихідний шар, KV-кеш і тимчасові буфери — в PSRAM, а 25-мільйонна таблиця залишається у флеш-пам'яті і доступна через відображення в адресний простір. До кожного токена з неї зчитується лише близько шести рядків загальним обсягом приблизно 450 байт.
Такий пристрій заснований на технології Per-Layer Embeddings, застосованої Google у Gemma 3n. Згідно документації Google, PLE-параметри можуть зберігатися поза робочою пам'яттю моделі і додаватися в процес виведення в міру обробки окремих шарів. У esp32-ai цей підхід перенесено на ієрархію пам'яті мікроконтролера, де швидка SRAM особливо обмежена.
Перша коректна версія написаної C середовища виконання видавала тільки 0,57 токена в секунду. Після розміщення вихідного шару в PSRAM, переходу до восьмибітних активацій, розподілу обчислень між двома ядрами Xtensa LX7 та інших оптимізації затримка була зменшена до 94,9 мс на крок моделі. Підсумкова виміряна швидкість досягла 9,88 токена за секунду з урахуванням повного процесу генерації. Основним обмеженням тепер стала пропускна спроможність PSRAM під час читання вихідного шару.
Модель навчена на синтетичному наборі даних TinyStories, Що складається з простих англомовних оповідань з обмеженим словником Тому вона здатна продовжувати фрази та складати невеликі зв'язкові історії, але не призначена для відповідей на питання, виконання інструкцій, програмування чи відтворення фактичних знань. Розробник розглядає роботу насамперед як демонстрацію ефективного розміщення моделі у пам'яті мікроконтролера, а не як готового автономного чат-бота.
В актуальній документації автор окремо наголошує, що esp32-ai є самостійною розробкою. Проекти лама2.c Андрія Карпати та більш ранній запуск 260-тисячної моделі на ESP32-S3 наводяться лише як орієнтири та приклади попередніх робіт: код, контрольні точки та методика безпосередньо з них не запозичені. Вихідний код esp32-ai поширюється під ліцензією MIT.
Джерело: linux.org.ru
