

Hej Habr! Datasæt til Big Data og maskinlæring vokser eksponentielt, og vi skal nå at behandle dem. Vores indlæg handler om endnu en innovativ teknologi inden for højtydende computing (HPC, High Performance Computing), præsenteret på Kingston's stand på . Dette er anvendelsen af hi-end datalagringssystemer (SAS) i servere med grafiske processorer (GPU) og GPUDirect Storage-bussystemteknologi. Takket være direkte dataudveksling mellem SAS og GPU, der omgår CPU, kan dataindlæsningen til GPU-acceleratorer betydeligt accelereres, hvilket gør, at Big Data-applikationer kører på maksimal ydeevne, som GPU'er kan levere. HPC-systemudviklere er derimod interesseret i fremskridt inden for SAS med ekstremt høj ind- og udgangshastighed — såsom dem, Kingston producerer.
GPU-ydeevne overgår dataindlæsning
Siden CUDA blev skabt i 2007 — en software-hardware-arkitektur for parallelle beregninger baseret på GPU til udvikling af generelle applikationer, er de hardwaremæssige muligheder for GPU'erne steget utrolig meget. I dag finder GPU'er anvendelse i flere og flere HPC-applikationer, såsom big data, maskinlæring (ML, machine learning) og dyb læring (DL, deep learning).
Det er værd at bemærke, at selvom termerne kan synes at være ens, er de to sidste algoritmisk forskellige opgaver. ML træner computeren baseret på strukturerede data, mens DL gør det på baggrund af respons fra et neuralt netværk. Et eksempel på at forstå forskellene er ret simpelt. Lad os antage, at computeren skal skelne mellem billeder af katte og hunde, som uploades fra et lagersystem. For ML skal der præsenteres et sæt billeder med mange tags, der hver især definerer en bestemt egenskab ved dyret. For DL er det nok at uploade et langt større antal billeder, men kun med én tag som “dette er en kat” eller “dette er en hund”. DL svarer meget til, hvordan små børn lærer — de får bare vist billeder af hunde og katte i bøger og i virkeligheden (oftest uden at få forklaret detaljerne), og barnets hjerne begynder selv at skelne mellem dyretyper efter et kritisk antal billeder til sammenligning (ifølge estimater drejer det sig kun om et hundrede til to hundrede visninger i hele den tidlige barndom). DL-algoritmerne er stadig ikke så komplette: for at en neuralt netværk kan fungere så godt i billedgenkendelse, skal der præsenteres og behandles millioner af billeder i GPU.
Konklusionen på forordet: På baggrund af GPU kan der opbygges HPC-applikationer inden for Big Data, ML og DL, men der er et problem — datamængderne er så store, at den tid, der bruges på at indlæse data fra lagersystemet til GPU, begynder at påvirke den samlede ydeevne af applikationen negativt. Med andre ord forbliver de hurtige grafiske processorer underudnyttede på grund af den langsomme ind- og udgang af data fra andre subsystemer. Forskellen i hastighed mellem ind-/uddata fra GPU og bussen til CPU/lager kan være på en størrelsesorden.
Hvordan fungerer teknologien GPUDirect Storage?
Ind- og uddata processen styres af CPU'en, ligesom dataindlæsning fra lageret til grafiske processorer til yderligere behandling. Deraf opstod behovet for en teknologi, der kunne sikre direkte adgang mellem GPU og NVMe-diske for hurtigere interaktion mellem dem. Den første teknologi, der tilbød dette, var fra NVIDIA, og de kaldte den GPUDirect Storage. I bund og grund er det en variant af deres tidligere udviklede teknologi GPUDirect RDMA (Remote Direct Memory Address).
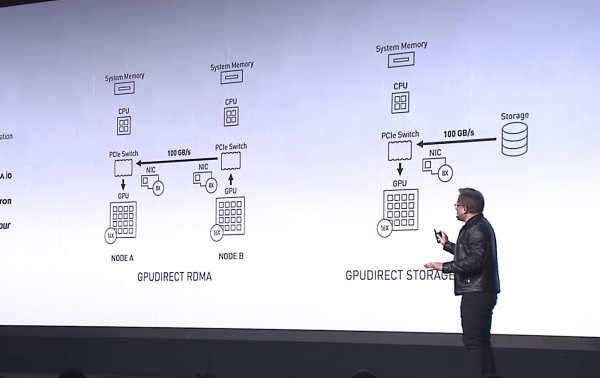
Jensen Huang, administrerende direktør for NVIDIA, præsenterer GPUDirect Storage som en variant af GPUDirect RDMA på messen SС-19. Kilde: NVIDIA
Forskellen mellem GPUDirect RDMA og GPUDirect Storage ligger i de enheder, som adresseres. GPUDirect RDMA-teknologien er designet til at flytte data direkte mellem netværksinterfacekortet (NIC) og GPU-hukommelsen, mens GPUDirect Storage giver en direkte dataoverførsel mellem lokal eller fjernlagring, såsom NVMe eller NVMe over Fabric (NVMe-oF), og GPU-hukommelsen.
Begge muligheder, GPUDirect RDMA og GPUDirect Storage, undgår unødvendige dataflytninger gennem CPU-hukommelsesbufferen og giver DMA-mekanismen mulighed for at flytte data fra netværkskortet eller lagringen direkte til GPU-hukommelsen eller fra den — alt sammen uden belastning af CPU'en. For GPUDirect Storage er placeringen af lagringen ligegyldig: det kan være en NVMe-disk inde i en GPU-enhed, i et rack eller tilsluttet over netværket som NVMe-oF.
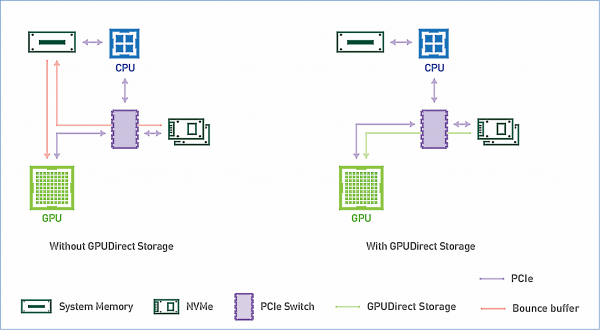
Hvordan GPUDirect Storage fungerer. Kilde: NVIDIA
Hi-End SAN på NVMe er eftertragtede på markedet for HPC-applikationer.
Ved at forstå, at interessen fra store kunder vil fokusere på lagringssystemer med input/output-hastigheder, der matcher GPU'ens båndbredde med GPUDirect Storage, viste Kingston på SC-19-messen en demo af et system bestående af en SAN baseret på NVMe-diske og en GPU-enhed, hvor tusindvis af satellitbilleder blev analyseret per sekund. Vi har allerede skrevet om denne SAN baseret på 10 DC1000M U.2 NVMe-drev. .
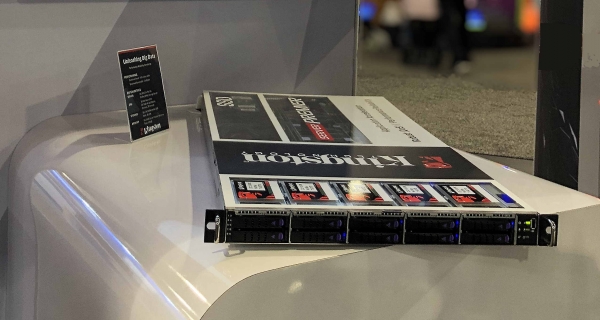
SAN baseret på 10 DC1000M U.2 NVMe-drev passer perfekt til en server med grafiske acceleratorer. Kilde: Kingston.
Denne SAN udføres som en 1U eller større rack-enhed og kan skaleres afhængigt af antallet af DC1000M U.2 NVMe-diske, hvor hver har en kapacitet på 3,84-7,68 TB. DC1000M er den første model af NVMe SSD i U.2 formfaktoren i Kingston's datacenter lagerlinje. Den har en holdbarhedsvurdering (DWPD, Drive writes per day), der tillader omwrite af data til fuld kapacitet én gang om dagen i løbet af lagringsenhedens garanterede levetid.
I fio v3.13 testen på Ubuntu 18.04.3 LTS, Linux kernel 5.0.0-31-generic, viste udstillingsprøven af SAN en læsehastighed (Sustained Read) på 5,8 millioner IOPS ved en stabil båndbredde (Sustained Bandwidth) på 23,8 Gbit/s.
Ariel Perez, business manager for SSD at Kingston, described the new storage systems as follows: "We are ready to supply the next generation of servers with U.2 NVMe SSD solutions to eliminate many of the data transfer bottlenecks traditionally associated with storage systems. The combination of NVMe SSDs and our premium Server Premier DRAM makes Kingston one of the most comprehensive providers of integrated data processing solutions in the industry."
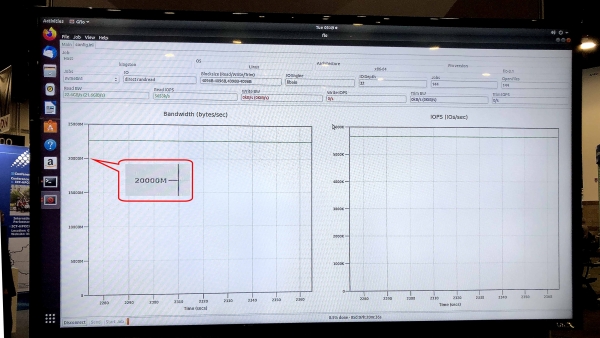
The gfio v3.13 test showed a throughput of 23.8 Gbit/s for the demonstration storage system on DC1000M U.2 NVMe drives. Source: Kingston
What would a typical system for HPC applications look like, where GPUDirect Storage technology or a similar technology is implemented? It is an architecture with a physical separation of functional blocks within the rack: one or two units for RAM, several for GPU and CPU compute nodes, and one or more units for storage systems.
With the announcement of GPUDirect Storage and the potential emergence of similar technologies from other GPU vendors, demand for storage systems optimized for high-performance computing is expanding for Kingston. A marker will be the speed of data reading from storage systems equivalent to the throughput of 40 or 100 Gbit network cards at the input to the GPU compute unit. Thus, ultra-high-speed storage systems, including external NVMe through Fabric, will transition from exotic to mainstream for HPC applications. Aside from science and financial calculations, they will find applications in many other practical fields, such as metropolitan security systems, Safe City, or transport monitoring centers, where recognition and identification speed at the level of millions of HD images per second is required," noted the market niche for top storage systems.
For more information about Kingston products, visit the company.
Kilde: habr.com
