

Spørgsmålet "hvordan man implementerer DevOps" har været aktuelt i flere år, men der er ikke mange gode materialer. Nogle gange bliver du offer for reklamer fra ikke særlig kloge konsulenter, der skal sælge deres tid, ligegyldigt hvordan. Nogle gange er det uklare, meget generelle ord om, hvordan kæmpeselskabers skibe sejler på universets vande. Spørgsmålet opstår: hvad har vi egentlig ud af det? Kære forfatter, kan du tydeligt formulere dine idéer i en liste?
Alt dette skyldes, at der ikke er samlet meget reel praksis og forståelse af udfaldet af virksomhedskulturens transformationer. Ændringer i kulturen er langsigtede ting, hvis resultater ikke vil vise sig på en uge eller en måned. Vi har brug for nogen, der er tilpas gammeldags, som har set virksomheder blive skabt og nedlagt over mange år.
John Willis — en af fædrene til DevOps. John har mange års erfaring med at arbejde med et stort antal virksomheder. På det seneste har John bemærket specifikke mønstre, der opstår i arbejdet med hver enkelt af dem. Ved at bruge disse arketyper vejleder John virksomhederne på den rigtige vej til DevOps-transformation. Læs mere om disse arketyper i oversættelsen af hans præsentation fra DevOops 2018-konferencen.
Om foredragsholderen:
Over 35 års erfaring inden for IT-ledelse, deltager i udviklingen af en forgænger til OpenCloud i Canonical, har været involveret i 10 startups, hvoraf to blev solgt til Dell og Docker. I øjeblikket er han Vice President of DevOps and Digital Practices hos SJ Technologies.
Dernæst — en fortælling fra Johns synspunkt.
Mit navn er John Willis, og du kan nemmest finde mig på Twitter, . Det er også mit pseudonym på Gmail og GitHub. Og kan du finde optagelser af mine foredrag og tilhørende præsentationer.
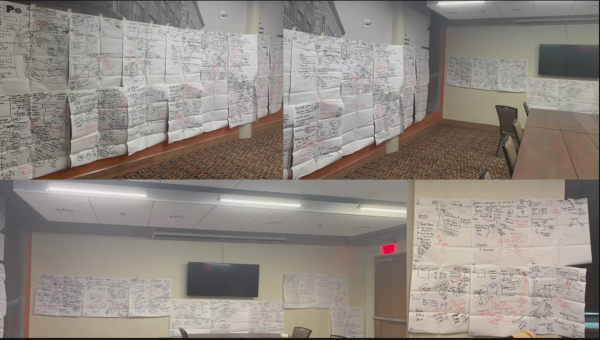
Jeg har mange møder med CIO'er fra forskellige store virksomheder. De klager ofte over, at de ikke forstår, hvad DevOps er, og at alle, der forsøger at forklare det, taler om noget helt anderledes. En anden hyppig klage er, at DevOps ikke fungerer, selvom direktørerne tilsyneladende gør alt, som de har fået at vide. Det drejer sig om store virksomheder, der har eksisteret i hundrede år eller mere. Efter at have talt med dem, konkluderede jeg, at mange problemer bedst løses med forholdsvis lavteknologiske løsninger snarere end avancerede teknologier. I ugevis talte jeg simpelthen med folk fra forskellige afdelinger. Det, du ser på det allerførste billede i indlægget, er mit seneste projekt; rummet så sådan ud efter tre dages arbejde.
Hvad er DevOps?
Hvis du spørger ti forskellige personer, vil de give ti forskellige svar. Men det interessante er, at alle disse ti svar vil være rigtige. Der er ikke noget forkert svar her. Jeg har arbejdet dybt med DevOps i cirka ti år og var den første amerikaner til den første DevOpsDay. Jeg vil ikke påstå, at jeg er klogere end alle andre, der beskæftiger sig med DevOps, men jeg tvivler på, at der er nogen, der har brugt så meget energi på det. Jeg mener, at DevOps opstår, når menneskelig kapital og teknologi mødes. Vi glemmer ofte den menneskelige dimension, selvom vi taler meget om alle mulige kulturer.
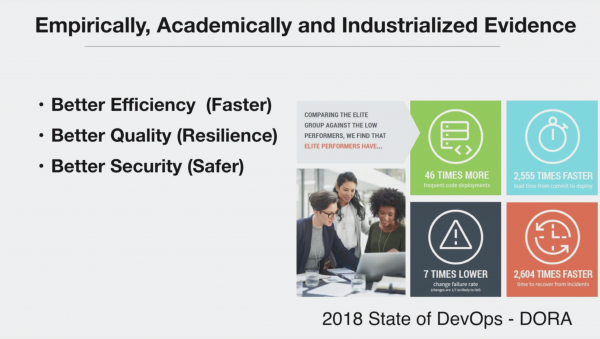
Nu har vi mange data, fem års akademisk forskning og en afprøvning af teorier på industriel skala. Denne forskning viser os følgende: hvis visse adfærdsmønstre kombineres i organisationskulturen, kan man opnå en acceleration på 2000 gange. Denne acceleration svarer til en tilsvarende forbedring i robusthed. Det er en kvantitativ måling af den fordel, som DevOps kan give enhver virksomhed. For et par år siden talte jeg om DevOps til en administrerende direktør fra en Fortune 5000-virksomhed. Da jeg forberedte mig til præsentationen, var jeg meget nervøs, fordi jeg skulle opsummere mine mange års erfaring på fem minutter.
Som resultat gav jeg følgende definition af DevOps: det er et sæt praksisser og mønstre, der muliggør at omdanne menneskelig kapital til højtydende organisatorisk kapital. Et eksempel er, hvordan Toyota har arbejdet de sidste 50 eller 60 år.
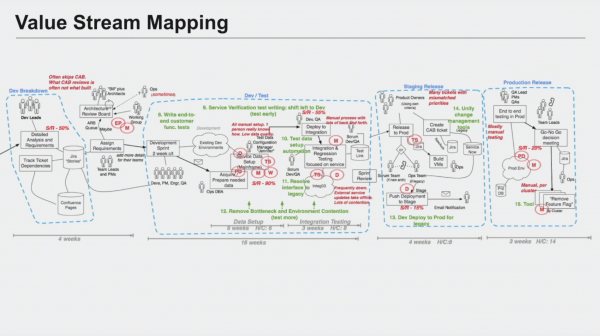
(Disse skemaer præsenteres ikke som referencemateriale, men som illustration. Deres indhold vil variere for hver ny virksomhed. Alligevel kan billedet ses individuelt og forstørres
En af de mest succesfulde sådanne praksisser er value stream mapping. Der er skrevet flere gode bøger om dette, og forfatteren af de mest succesfulde af dem er Karen Martin. Men det sidste år er jeg kommet til den konklusion, at selv denne tilgang er for højteknologisk. Den har bestemt mange fordele, og jeg har brugt den meget. Men når en administrerende direktør spørger dig, hvorfor hans virksomhed ikke kan skifte til nye spor, er det for tidligt at tale om value stream mapping. Der er mange langt mere fundamentale spørgsmål, der først skal besvares.
Jeg mener, at fejlen hos mange af mine kolleger er, at de blot giver virksomheden en vejledning på fem punkter, og derefter vender de tilbage efter et halvt år for at se, hvad der er sket. Selv med et godt skema som value stream mapping er der, så at sige, blinde zoner. Efter hundreder af interviews med direktører for forskellige virksomheder har jeg udviklet et bestemt mønster, der gør det muligt at opdele problemet i komponenter, og nu vil vi diskutere hver af disse komponenter i rækkefølge. Før jeg anvender nogen teknologiske løsninger, bruger jeg dette mønster, og resultatet er, at alle vægge ender med at være fyldt med skemaer. For nylig arbejdede jeg med en gensidig fond, og jeg endte med 100-150 sådanne skemaer.
Dålig kultur spiser gode tilgange til morgenmad
Hovedtanken er denne: intet Lean, Agile, SAFE eller DevOps vil hjælpe, hvis virksomhedens kultur er dårlig. Det er som at dykke i dybden uden dykkerudstyr eller operere uden røntgenbillede. Med andre ord, for at parafrasere Drucker og Deming: en dårlig organisationskultur vil opsluge ethvert godt system og ikke kvæles.
For at løse dette hovedproblem skal følgende skridt tages:
- Gør alt arbejde synligt: du skal gøre alt arbejde synligt. Ikke i den forstand, at det nødvendigvis skal vises på en skærm, men i den forstand, at det skal kunne observeres.
- Konsolider arbejdshåndteringssystemer: det er nødvendigt at konsolidere ledelsessystemerne. I problemet med «stammekendskab» og institutionelt kendskab er menneskene i 9 ud af 10 tilfælde flaskehalsene. I bogen var problemet i én enkelt person, Brent, som fik projektet til at blive tre år forsinket. Og jeg støder på sådanne «Brent» overalt. For at løse disse flaskehalse anvender jeg følgende to punkter på vores liste.
- Theory of Constraints Methodology: teori om begrænsninger.
- Collaboration hacks: samarbejdshacks.
- Toyota Kata (): jeg vil ikke tale meget om Toyota Kata. Hvis du er interesseret, har jeg på min GitHub om nærmest hver af disse emner.
- Market Oriented Organization: markedsorienteret organisation.
- Shift-left auditors: revision i de tidlige faser af cyklussen.
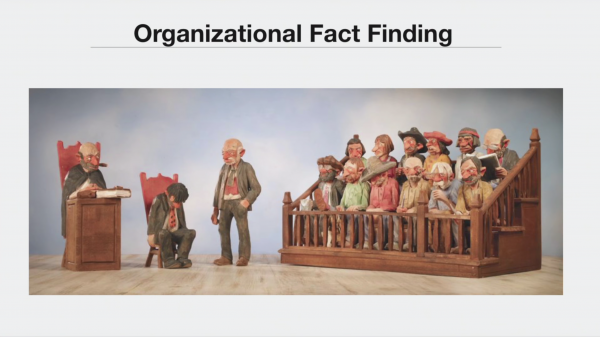
Jeg starter arbejdet med organisationen meget simpelt: jeg går ind i virksomheden og taler med medarbejderne. Som vi ser, er der ingen høj teknologi. Alt der kræves er, at der er noget at skrive med. Jeg samler flere teams i et rum og analyserer, hvad de fortæller mig, ud fra mine 7 arketyper. Så giver jeg dem selv en markør og beder dem udtrykke alt det, de indtil nu har sagt højt, skriftligt på tavlen. Normalt er der én person til stede på sådanne møder, der skriver alt ned, og i bedste fald får han indfanger 10% af diskussionen. Ved min metode lykkes det at hæve denne procentdel til omkring 40%.
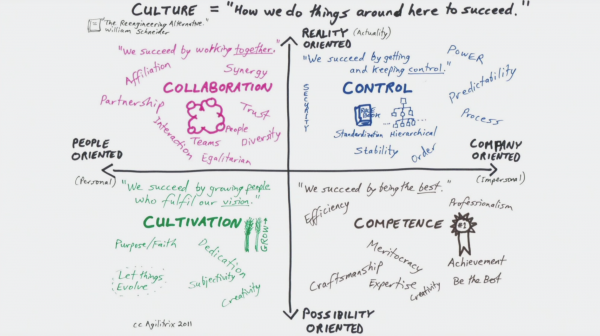
(Separat kan denne illustration )
Mit tilgang er baseret på arbejde af William Schneider (William Schneider, ). Grundtanken i tilgangen er, at enhver organisation kan opdeles i fire kvadrater. Dette diagram er typisk resultatet af mit arbejde med de hundredvis af andre diagrammer, der opstår under analysen af organisationen. Antag, at vi har en organisation med høj kontrol, men samtidig med lav kompetence. Dette er en yderst uønsket situation: når alle går efter reglerne, men ingen ved, hvad der skal gøres.
En bedre mulighed med højt niveau af både kontrol og kompetence. Hvis en virksomhed er profitabel, er DevOps måske ikke nødvendigt for dem. Det mest interessante er at arbejde med en virksomhed, som har højt niveau af kontrol, lav kompetence og samarbejde, men samtidig en høj kultur (cultivation). Det betyder, at der er mange mennesker i virksomheden, som nyder at arbejde der, og medarbejderomsætningen er lav.
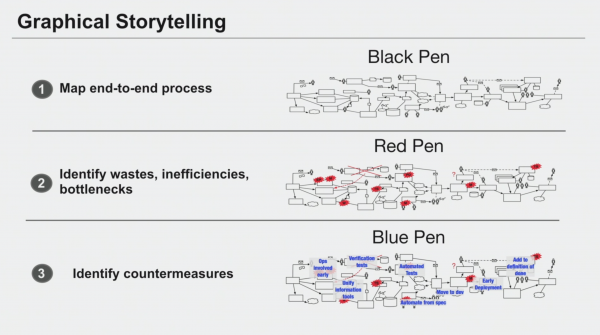
(Separat kan denne illustration )
Jeg tror, at metoder med strenge retningslinjer i sidste ende hindrer os i at nå sandheden. Især i value stream mapping er der mange regler om, hvordan information skal struktureres. I de tidlige faser, som jeg taler om nu, er disse regler unødvendige. Hvis en person med en marker i hånden beskriver den reelle situation i virksomheden på en tavle, er det den bedste måde at få indsigt i situationen. Den information når aldrig op til lederne. I det øjeblik er det dumt at afbryde personen og sige, at de har tegnet en pil forkert. I denne fase er det bedre at bruge enkle regler, for eksempel kan man skabe en flerlagdet abstraktion ved bare at bruge farverige markører.
Jeg gentager, ingen højteknologi. Den objektive virkelighed, hvordan alt fungerer, tegnes med sort marker. Med rød marker angiver folk, hvad de ikke kan lide ved den nuværende situation. Det er vigtigt, at det er dem, der skriver det, og ikke mig. Når jeg efter mødet går til IT-direktøren, præsenterer jeg ikke en liste med 10 ting, der skal rettes. Jeg forsøger at finde forbindelser mellem det, som folk siger i virksomheden, og eksisterende bekræftede mønstre. Til sidst foreslår man mulige løsninger på problemet med den blå marker.
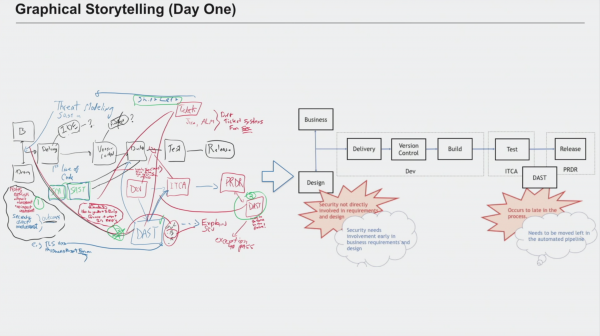
(Separat kan denne illustration )
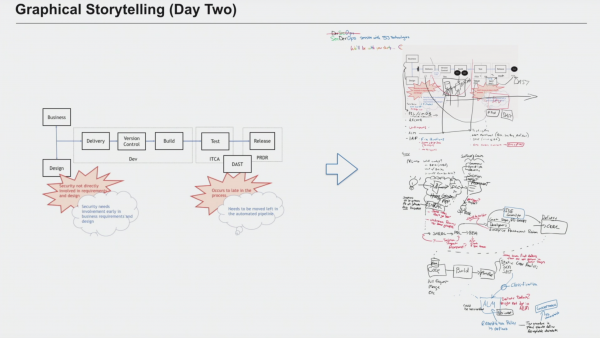
Et eksempel på denne tilgang er vist ovenfor. I begyndelsen af dette år arbejdede jeg med en bank. Medarbejdere fra sikkerhedsafdelingen der var overbeviste om, at de ikke måtte deltage i krav- og designgennemgange (design and requirement reviews).
(Separat kan denne illustration )
Og så talte vi med folk fra andre afdelinger og fandt ud af, at for omkring 8 år siden havde softwareudviklerne ekskluderet sikkerhedsmedarbejderne, fordi de forsinkede arbejdet. Og så blev det til et forbud, der blev opfattet som en given ting. Selvom der reelt ikke var noget forbud.
Vores møde forløb på en ekstremt forvirrende måde: i omkring tre timer kunne fem forskellige teams slet ikke forklare mig, hvad der sker mellem koden og bygningen. Og det burde egentlig være den enkleste ting. De fleste DevOps-konsulenter antager på forhånd, at alle allerede kender dette.
Så pludselig gik personen, der stod for IT-reguleringen (IT governance), der havde været tavs i fire timer, i gang, da vi nåede til hans emne, og han optog os i lang tid. Til sidst spurgte jeg ham, hvad han tænkte om mødet, og jeg vil aldrig glemme hans svar. Han sagde: „Tidligere troede jeg, at der kun var to metoder til at levere software i vores bank, men nu ved jeg, at der er hele fem, og at jeg ikke engang anede, at der var tre af dem.”
(Separat kan denne illustration )
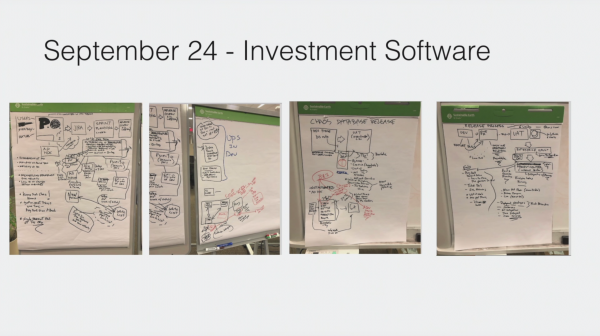
Det sidste møde i denne bank var med teamet, der arbejdede med software til investeringer. Det viste sig, at det er bedre at skrive diagrammer med en tusch på papir end på en tavle, og endda bedre end på en smartboard.
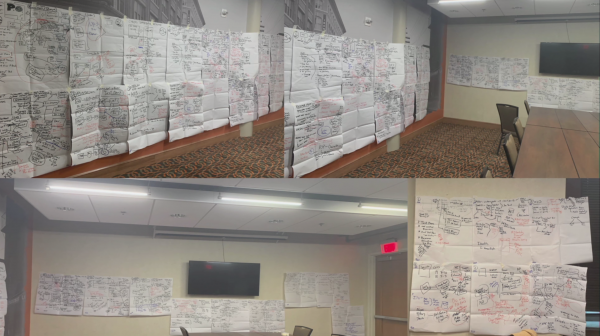
Billederne, du ser, er hvordan konferencerummet i hotellet så ud på den fjerde dag af vores møde. Og disse diagrammer brugte vi til at finde mønstre, det vil sige archetyper.
Så jeg stiller spørgsmål til medarbejderne, de skriver deres svar med tuscher i tre farver (sort, rød og blå). Jeg analyserer deres svar for archetyper. Lad os nu diskutere alle archetyperne i rækkefølge.
1. Make All Work Visible: Gøre al arbejde synligt
I de fleste virksomheder, jeg arbejder med, er der en meget høj procentdel af ukendt arbejde. For eksempel når en medarbejder går til en anden og bare beder om at få noget gjort. I store organisationer kan op til 60% af arbejdet være uplanlagt. Og op til 40% af arbejdet er slet ikke dokumenteret. Hvis det var Boeing, ville jeg aldrig sætte mig ind i deres fly igen. Hvis kun halvdelen af arbejdet bliver dokumenteret, er det uklart, om dette arbejde bliver udført korrekt eller ej. Alle andre metoder viser sig at være ubrugelige - der er ikke nogen mening i at forsøge at automatisere noget, fordi de kendte 50% muligvis er den mest velkoordinerede og præcise del af arbejdet, hvor automatisering ikke vil give store resultater, mens det værste findes i den usynlige halvdel. Uden dokumentation er det umuligt at finde forskellige hacks og skjult arbejde, samt identificere flaskehalse og de såkaldte 'Brent's', som jeg allerede har nævnt. Der er en fremragende bog skrevet af Dominica DeGrandis. . Den identificerer fem forskellige 'tidstyve' (thieves of time):
- For meget arbejde i proces (WIP)
- Ukendte afhængigheder
- Uplanlagt arbejde
- Modstridende prioriteter
- Forsømt arbejde
Dette er en meget værdifuld analyse, og bogen er fantastisk, men alle disse råd er nytteløse, hvis kun 50% af dataene er synlige. Metoderne foreslået af Dominica kan anvendes, hvis nøjagtigheden er over 90%. Jeg taler om situationer, hvor chefen giver en medarbejder en opgave på 15 minutter, men den tager tre dage; men chefen ved faktisk ikke, at denne medarbejder afhænger af fire eller fem andre personer.
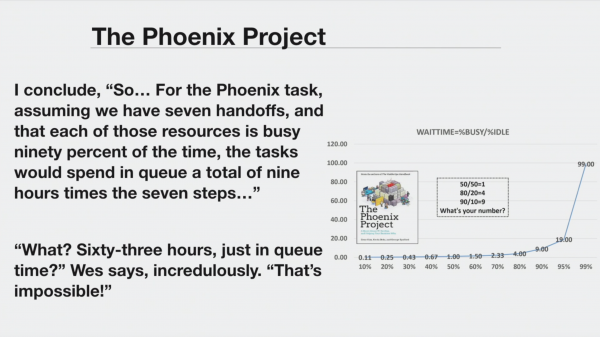
Phoenix Project er en fascinerende fortælling om et projekt, der er tre år forsinket. En af karaktererne står over for opsigelse på grund af dette, og han møder en anden karakter, der repræsenteres som en slags Sokrates. Denne hjælper med at klarlægge, hvad der præcist er gået galt. Det viser sig, at der i virksomheden er en systemadministrator ved navn Brent, og alt arbejde går ind og ud af ham. På et møde spørger en af underordnede: hvorfor tager hver halv times opgave en uge? Svaret er en meget forenklet forklaring på køteori og Little's lov, og i denne forklaring viser det sig, at ved 90 % belægning tager hver arbejdstime 9 timer. Hver opgave skal sendes til syv andre personer, hvilket betyder, at den time bliver til 63 timer, 7 ganget med 9. Jeg siger dette for at påpege, at for at kunne anvende Little's lov eller nogen som helst kompleks køteori, skal man i det mindste have data.
Når jeg taler om synlighed, mener jeg ikke, at alt skal være på skærmen, men at man mindst skal have dataene. Når de er til stede, viser det sig ofte, at der er en meget stor mængde planlagt arbejde, som af en eller anden grund sendes til Brent, selvom der ikke er nogen nødvendighed for det. Brent er en fantastisk fyr, han vil aldrig sige 'nej', men han fortæller aldrig nogen, hvordan han udfører sit arbejde.
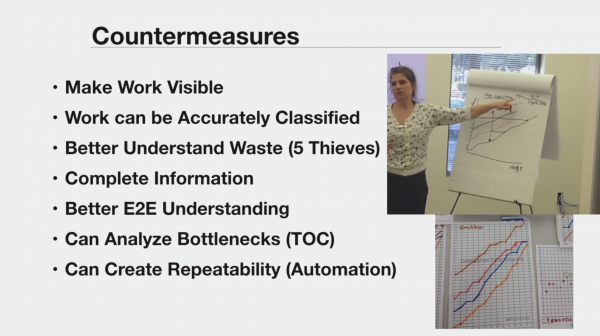
Når arbejdet er synligt, kan dataene omhyggeligt klassificeres (det er netop, hvad Dominika gør på billedet), man kan anvende abstrahering af fem tidstyve, og man kan automatisere.
2. Konsolider arbejdsstyringssystemer: Opgavestyring
De arketyper, jeg taler om, udgør en form for pyramide. Hvis den første udføres korrekt, fungerer den anden som en form for overbygning. Mange af dem virker ikke for startups; de skal overvejes i forbindelse med store virksomheder, der kommer på Fortune 5000-listen. I den sidste virksomhed, hvor jeg arbejdede, var der 10 systemer til fejlhåndtering (ticketing system). Én gruppe brugte Remedy, en anden havde skrevet deres eget system, en tredje brugte Jira, og nogen klarede sig endda med e-mail. Det samme problem opstår, hvis et firma har 30 forskellige pipelines, men jeg har ikke tid til at diskutere alle disse tilfælde.
Jeg diskuterer med folk, hvordan billetter oprettes, hvad der sker med dem bagefter, og hvordan de omgås. Det mest interessante er, at folk på vores møder taler ret ærligt. Jeg spurgte, hvor mange der markerer 'mindre / ingen indvirkning' for billetter, der faktisk skulle have fået 'stor indvirkning'. Det viste sig, at næsten alle gør det. Jeg er ikke en anmelder og forsøger på alle måder ikke at identificere folk. Når jeg får en oprigtig indrømmelse, afslører jeg ikke personen. Men når næsten alle omgår systemet, betyder det, at hele sikkerheden i bund og grund er en facade. Så man kan ikke drage nogen konklusioner ud fra dataene fra dette system.
For at løse problemet med billetterne er det nødvendigt at vælge et hovedsystem. Hvis du bruger Jira, så lad det være kun Jira. Hvis der er et alternativ, så lad det være kun det. Sagen er, at billetter skal betragtes som endnu et trin i udviklingsprocessen. Hver handling skal have en billet, som skal gennemløbe arbejdsprocessen for udviklingen. Billetter sendes til teamet, som placerer dem på storyboardet, og derefter har ansvaret for dem.
Dette gælder for alle afdelinger, herunder både infrastruktur- og driftsafdelingen. På den måde kan man danne et hvilket som helst plausibelt billede af situationen. Når denne proces er etableret, viser det sig pludselig, at man nemt kan fastslå, hvem der har ansvaret for hver applikation. For nu får vi ikke 50%, men 98% af de nye tjenester. Hvis denne centrale proces fungerer, så øges nøjagtigheden i hele systemet.
Pipeline for tjenester
Det handler igen kun om store virksomheder. Hvis du er et nyt firma inden for et nyt område, så opretter du dine ærmer og arbejder med din Travis CI eller CircleCI. Hvad angår Fortune 5000-virksomheder, er der et relevant eksempel fra banken, hvor jeg arbejdede. De blev kontaktet af Google, som viste dem diagrammer med de gamle IBM-systemer. Google-folkene spurgte forundret: hvor er koden til dette? Der er ingen kildekode, ikke engang et GUI. Dette er den virkelighed, som store organisationer må arbejde med: 40-årige bankoptegnelser på en gammel mainframe. En af mine kunder bruger Kubernetes-containere med Circuit Breaker-mønstre plus Chaos Monkey, alt dette til KeyBank-applikationen. Men i sidste ende forbindes disse containere til en applikation skrevet i COBOL.
Google-folkene var overbevist om, at de ville løse alle mine kunders problemer, men begyndte så at stille spørgsmål: hvad er IBM datapipe? De får at vide: det er en connector. Hvad forbinder det? Til Sperry-systemet. Og hvad er det? Og så videre. Ved første øjekast ser det ud til, at der ikke kan være nogen DevOps her. Men faktisk er det muligt. Der findes leveringssystemer, der gør det muligt at overføre workflow til de teams, der arbejder med leveringen.
3. Theory of Constraints: Begrænsningsteori
Lad os gå videre til den tredje arketype: institutionel / "stamme" viden. Som regel er der i enhver organisation et par personer, der ved alt og leder alle. Det er dem, der har været længst i organisationen, og som kender alle genveje.
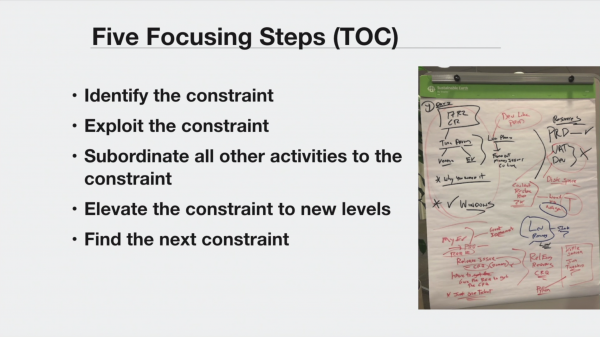
Når dette identificeres på diagrammet, markerer jeg med vilje sådanne personer med en markeringspen: for eksempel viser det sig, at en person ved navn Lou er til stede ved alle møder. Og for mig er det klart: han er den lokale Brent. Når IT-chefen vælger mellem mig i T-shirt og sneakers og en fyr fra IBM i jakkesæt, vælger de mig, fordi jeg kan fortælle chefen om ting, som den anden fyr ikke vil fortælle, og som chefen måske ikke ønsker at høre. Jeg fortæller dem, at der er et flaskehals i deres firma, der hedder Fred og en der hedder Lou. Denne flaskehals skal løses, og deres viden skal på en eller anden måde udvindes fra dem.
For at løse denne type problem kan jeg for eksempel foreslå at bruge Slack. Den snedige direktør ville spørge — hvorfor? Typisk vil DevOps-konsulenter i sådanne tilfælde svare: fordi alle andre gør det. Hvis direktøren er virkelig snedig, vil han sige: og så? Og så er dialogen sluttet. Og jeg svarer: fordi der i virksomheden er fire flaskehalse, Fred, Lou, Suzy og Jane. For at gøre deres viden institutionaliseret, skal Slack indføres. Alle jeres wikis er totalt værdiløse, fordi ingen ved, at de eksisterer. Hvis ingeniørteamet arbejder med ekstern og intern udvikling, skal alle vide, at de kan kontakte den eksterne udvikling eller infrastrukturteamet med spørgsmål. Lige dér kan det være, at Lou eller Fred får tid til at tilføje noget til wikis. Og senere kan nogen i Slack spørge, hvorfor for eksempel trin 5 ikke virker. Og så vil Lou eller Fred rette vejledningen i wikis. Hvis denne proces er på plads, vil meget af sig selv falde på plads.
Mit hovedbudskab er: for at anbefale højteknologi, skal man først få fundamentet på plads, og dette kan gøres med de lavteknologiske løsninger, jeg netop har beskrevet. Hvis man derimod starter med højteknologi uden at forklare, hvorfor de er nødvendige, ender det som regel ikke godt. En af vores kunder bruger Azure ML, et meget billigt og simpelt løsning. Omkring 30% af deres spørgsmål blev allerede besvaret af den selvlærende maskine. Og denne løsning blev udviklet af operatører, der ikke havde erfaring med data science, statistik eller matematik. Det er sigende. Omkostningerne ved denne løsning er minimale.
4. Samarbejds hacks: Hacks til samarbejde
Den fjerde arketype handler om, at man skal bekæmpe isolation. De fleste mennesker ved allerede: isolation skaber fjendskab. Hvis hver afdeling er på sin egen etage, og folk kun mødes i elevatoren, så opstår fjendskab let mellem dem. Men hvis folk derimod er i samme rum, forsvinder det straks. Når nogen fremsætter en fælles anklage, for eksempel at en bestemt grænseflade aldrig fungerer — så er det ikke svært at dekonstruere sådan en anklage. Programmørerne, der har skrevet grænsefladen, skal blot begynde at stille konkrete spørgsmål, og snart vil det vise sig, at brugeren bare har brugt værktøjet forkert.
Der er mange måder at overvinde isolation på. Jeg blev engang bedt om at rådgive en bank i Australien, men jeg afslog, fordi jeg har to børn og en kone. Alt hvad jeg kunne hjælpe dem med — jeg anbefalede dem grafisk storytelling. Det er noget, der viser sig at virke. En anden interessant metode er møder i lean coffee-format. I en stor organisation er det en udmærket måde at sprede viden på. Derudover kan man afholde interne devopsdays, hackathons og så videre.
5. Coaching Kata
Som jeg allerede har advaret om i starten, vil jeg ikke tale om dette i dag. Hvis du er interesseret, kan du tage et kig på .
Der er også et godt foredrag om dette emne fra Mike Rother:
6. Market Oriented: markedsorienteret organisation
Her er der forskellige problemer. For eksempel, "I" mennesker, "T" mennesker og "E" mennesker. "I" mennesker er dem, der kun beskæftiger sig med én ting. Normalt eksisterer de i organisationer med isolerede afdelinger. "T" er, hvis en person er dygtig til én ting, men også excel på nogle andre områder. "E" eller endda "kæmpe" — når en person har mange færdigheder.
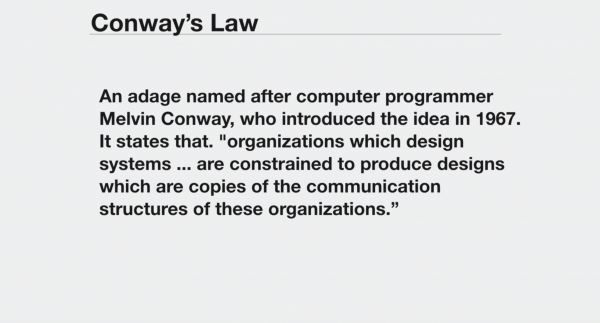
Her gælder Conways lov (), som i en maximalt forenklet form kan opsummeres sådan: hvis tre teams arbejder på en compiler, ender man med en compiler bestående af tre dele. Derfor, hvis der i organisationen er et højt niveau af isolation, så vil selv Kubernetes, Circuit breaker, API extensibility og andre trendy ting i denne organisation være struktureret på samme måde som selve organisationen. Strengt ifølge Conway og trods alt jer, unge nørder.
Problemet er blevet beskrevet mange gange. Der er for eksempel organisatoriske arketyper, beskrevet af Fernando Fernandez. Den problematiske arkitektur, jeg netop har nævnt, med isolation – det er en funktionsorienteret arkitektur. Den anden type – den værste, er den matrixarkitektur, hvor der er en blanding af de to andre. Den tredje – er den, der ses i de fleste startups, og som store virksomheder også forsøger at tilpasse sig. Det er en markedsorienteret organisation. Her sker der en optimering for at opnå den hurtigst mulige respons på kundernes forespørgsler. Nogle gange kaldes dette en flad organisation.
Denne struktur beskriver mange forskelligt, jeg kan lide formuleringen build/run teams, i Amazon kaldes det two pizza teams. I denne struktur samles alle personer af typen 'I' omkring en enkelt service, og gradvist bliver de tættere på typen 'T', og hvis ledelsen er korrekt, kan de til og med blive 'E'. Det første modargument her er, at der i en sådan struktur er overflødige elementer. Hvorfor have en tester i hvert afdeling, hvis man kan have en specialiseret testafdeling? Til dette svarer jeg: overflødige udgifter er i dette tilfælde prisen for, at hele organisationen i fremtiden kan blive type 'E'. I en sådan struktur lærer testeren gradvist om netværk, arkitektur, design og så videre. I sidste ende er hver deltager i organisationen fuldt informeret om alt, hvad der sker i organisationen. Hvis du vil vide, hvordan dette system fungerer i industrien, så læs .
7. Shift-left auditors: revision i de tidlige faser af cyklus. Overholdelse af sikkerhedsregler belyst
Det er, når ens handlinger ikke, så at sige, består lugttesten. Folk, der arbejder for dig, er ikke dumme. Hvis de, som i eksemplet ovenfor, har angivet minor/no impact overalt, og det har varet i tre år, og ingen har bemærket noget, så ved alle, at systemet ikke fungerer. Eller et andet eksempel — råd om ændringer (change advisory board), hvor hver onsdag man skal indsende rapporter. Der arbejder en gruppe mennesker (for øvrigt ikke alt for godt betalt), som i teorien burde vide, hvordan systemet fungerer som helhed. Og i de sidste fem år har du sikkert bemærket, at vores systemer er vanvittigt komplekse. Og fem-seks personer skal træffe en beslutning om en ændring, de ikke har bidraget til, og som de ikke ved noget om.
Selvfølgelig fungerer en sådan tilgang ikke. Jeg må slippe af med sådan noget, fordi disse mennesker ikke beskytter systemet. Beslutningen skal træffes af teamet selv, fordi teamet skal være ansvarligt for den. Ellers opstår der en paradoxal situation, hvor en manager, der aldrig har skrevet kode i sit liv, fortæller udvikleren, hvor lang tid det skal tage at skrive koden. I et firma, jeg arbejdede for, var der syv forskellige råd, der overvejede hver ændring, herunder arkitekturrådet, produkt- osv. Der var endda en obligatorisk ventetid, selvom en medarbejder fortalte mig, at ingen nogensinde i løbet af ti års ansættelse har afvist ændringer, som denne person har foreslået, inden for den obligatoriske periode.
Revisorer skal inviteres, ikke skubbes væk. Fortæl dem, at du skriver uforanderlige binære containere, som, hvis de bestanden alle tests, forbliver uændrede for altid. Fortæl dem, at du har pipeline as code, og forklar hvad det betyder. Vis dem følgende diagram: uforanderlig binær kun til læsning i en container, der har bestået alle sårbarhedstests; og dernæst rør ingen ved det — ikke engang systemet, der skaber pipeline, da det også oprettes dynamisk. Jeg har kunder, Capital One, som ved hjælp af Vault skaber noget lignende en blockchain. Revisoren behøver ikke at se "opskrifterne" fra Chef, det er tilstrækkeligt at vise blockchainen, som klart viser, hvad der skete med Jira-ticketen i produktionen, og hvem der er ansvarlig for den.
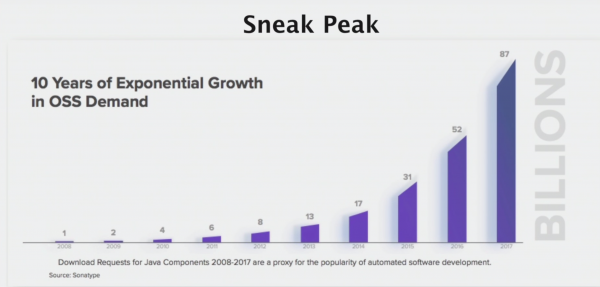
Ifølge , oprettet i 2018, blev der i 2017 registreret 87 milliarder downloads af OSS.
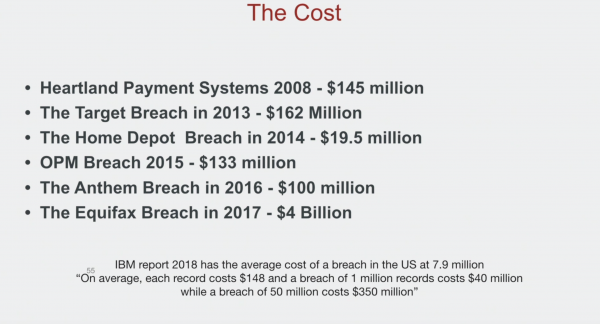
Tabene forårsaget af sårbarheder er uforholdsmæssigt høje. Desuden inkluderer de tal, du ser ovenfor, ikke alternativer omkostninger. Kort om, hvad DevSecOps er. Jeg vil straks sige, at jeg ikke er interesseret i diskussioner om, hvorvidt dette navn er vellykket. Pointen er, at når DevOps var meget succesfulde, så skal der prøves at tilføje sikkerhed til denne pipeline.
Et eksempel på en sådan sekvens:
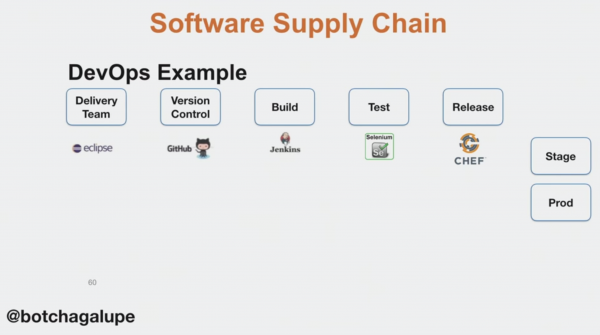
Dette er ikke en anbefaling af bestemte produkter, selvom jeg synes godt om dem alle. Jeg nævner dem som eksempler for at vise, at DevOps, der oprindeligt er baseret på en industriel organisationsparadigme, kan automatisere hver fase af produktarbejdet.
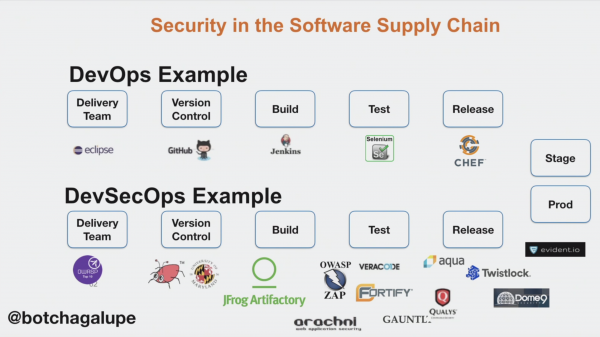
Og der er ingen grund til, at vi ikke kunne anvende den samme tilgang til sikkerhed.
Resultat
Som afslutning vil jeg give et par råd til DevSecOps. Det er vigtigt at inkludere revisorer i processen med at opbygge jeres systemer og at bruge tid på deres uddannelse. Samarbejd med revisorerne. Dernæst skal der føres en absolut nådesløs kamp mod falske alarmer. Selv med det dyreste værktøj til scanning af sårbarheder kan man ende med at skabe skadelige vaner hos jeres udviklere, hvis man ikke ved, hvordan signalet står i forhold til støj. Udviklerne vil ende med at blive overvældet af hændelser, og de vil blot slette dem. Hvis du har hørt om historien med Equifax, så skete der noget lignende der; et signal af højeste fare blev ignoreret. Desuden skal sårbarheder forklares, så det er klart, hvordan de påvirker forretningen. For eksempel kan det nævnes, at det er den samme sårbarhed som i historien med Equifax. Sikkerhedsrelaterede sårbarheder skal behandles ligesom andre softwareproblemer, det vil sige, de skal indgå i den samlede DevOps-proces. De skal behandles gennem Jira, Kanban osv. Udviklerne må ikke tro, at dette er noget, nogen andre skal tage sig af – tværtimod skal alle være involveret. Endelig skal der investeres ressourcer i at uddanne folk.
Nyttige links
Her er et par præsentationer fra DevOops-konferencen, som du måske finder nyttige:
- Sergey Berdnikov, Artyom Kalichkin – En succeshistorie, eller 'Dev+DevOps+Ops' (, )
- Baruch Sadogursky, Leonid Igolnik – DevOps i stor skala: en græsk tragedie i tre akter (, )
- Alexander Titov, Kirill Tolkachev –
- Timothy Lister –
Tag et kig på DevOops 2020 Moscow – der er også meget interessant der.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish