

En este artículo nos gustaría compartir una forma interesante de abordar la configuración de un sistema distribuido.
La configuración se representa directamente en el lenguaje Scala de manera segura en cuanto a tipos. Se describe una implementación de ejemplo en detalle. Se discuten varios aspectos de la propuesta, incluida su influencia en el proceso de desarrollo general.
()
Introducción
Construir sistemas distribuidos robustos requiere el uso de configuraciones correctas y coherentes en todos los nodos. Una solución típica es utilizar una descripción de despliegue textual (terraform, ansible o algo similar) y archivos de configuración generados automáticamente (a menudo dedicados para cada nodo/rol). También querríamos usar los mismos protocolos de las mismas versiones en cada uno de los nodos comunicantes (de lo contrario, experimentaríamos problemas de incompatibilidad). En el mundo JVM, esto significa que al menos la biblioteca de mensajería debería ser de la misma versión en todos los nodos comunicantes.
¿Y qué pasa con la prueba del sistema? Por supuesto, debemos tener pruebas unitarias para todos los componentes antes de pasar a las pruebas de integración. Para poder extrapolar los resultados de las pruebas en tiempo de ejecución, debemos asegurarnos de que las versiones de todas las bibliotecas se mantengan idénticas tanto en el entorno de ejecución como en el de pruebas.
Al ejecutar pruebas de integración, a menudo es mucho más fácil tener el mismo classpath en todos los nodos. Solo necesitamos asegurarnos de que se utilice el mismo classpath en el despliegue. (Es posible utilizar diferentes classpaths en diferentes nodos, pero es más difícil representar esta configuración y desplegarla correctamente). Así que, para mantener las cosas simples, solo consideraremos classpaths idénticos en todos los nodos.
La configuración tiende a evolucionar junto con el software. Normalmente utilizamos versiones para identificar diversas
etapas de la evolución del software. Parece razonable incluir la configuración bajo gestión de versiones e identificar diferentes configuraciones con alguna etiqueta. Si solo hay una configuración en producción, podemos usar una sola versión como identificador. A veces podemos tener múltiples entornos de producción. Y para cada entorno podríamos necesitar una rama separada de configuración. Por lo tanto, las configuraciones pueden etiquetarse con rama y versión para identificar de forma única diferentes configuraciones. Cada etiqueta de rama y versión corresponde a una única combinación de nodos distribuidos, puertos, recursos externos y versiones de bibliotecas del classpath en cada nodo. Aquí solo cubriremos la única rama e identificaremos las configuraciones con una versión decimal de tres componentes (1.2.3), de la misma manera que otros artefactos.
En entornos modernos, los archivos de configuración ya no se modifican manualmente. Típicamente, generamos
archivos de configuración en el momento del despliegue y después. Por lo tanto, uno podría preguntar por qué seguimos usando formato de texto para los archivos de configuración. Una opción viable es colocar la configuración dentro de una unidad de compilación y beneficiarse de la validación de configuración en tiempo de compilación.
En este artículo examinaremos la idea de mantener la configuración en el artefacto compilado.
Configuración compilable
En esta sección discutiremos un ejemplo de configuración estática. Se configuran e implementan dos servicios simples: el servicio de eco y el cliente del servicio de eco. Luego, se instancian dos sistemas distribuidos diferentes con ambos servicios. Uno es para una configuración de un solo nodo y el otro para una configuración de dos nodos.
Un sistema distribuido típico consiste en unos pocos nodos. Los nodos podrían identificarse usando algún tipo:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
o simplemente
case class NodeId(hostName: String)o incluso
object Singleton
type NodeId = Singleton.type
Estos nodos realizan varios roles, ejecutan algunos servicios y deben ser capaces de comunicarse con otros nodos por medio de conexiones TCP/HTTP.
Para la conexión TCP se requiere al menos un número de puerto. También queremos asegurarnos de que el cliente y el servidor estén utilizando el mismo protocolo. Para modelar una conexión entre nodos, declaremos la siguiente clase:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])donde Puerto es solo un Int dentro del rango permitido:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Tipos refinados
Ver biblioteca. En resumen, permite añadir restricciones de tiempo de compilación a otros tipos. En este caso Int solo puede tener valores de 16 bits que pueden representar números de puerto. No hay requisito para usar esta biblioteca para este enfoque de configuración. Simplemente parece encajar muy bien.
Para HTTP (REST) también podríamos necesitar una ruta del servicio:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
tipo fantasma
Para identificar el protocolo durante la compilación, estamos utilizando la característica de Scala de declarar un argumento de tipo. Protocolo que no se utiliza en la clase. Es un llamado tipo fantasma. En tiempo de ejecución rara vez necesitamos una instancia del identificador de protocolo, por eso no lo almacenamos. Durante la compilación, este tipo fantasma proporciona una seguridad de tipo adicional. No podemos pasar un puerto con un protocolo incorrecto.
Uno de los protocolos más utilizados es REST API con serialización Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]donde RequestMessage es el tipo base de mensajes que el cliente puede enviar al servidor y ResponseMessage es el mensaje de respuesta del servidor. Por supuesto, podemos crear otras descripciones de protocolo que especifiquen el protocolo de comunicación con la precisión deseada.
Para los propósitos de esta publicación, usaremos una versión más simple del protocolo:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]En este protocolo, el mensaje de solicitud se anexa a la URL y el mensaje de respuesta se devuelve como una cadena plana.
Una configuración de servicio podría describirse por el nombre del servicio, una colección de puertos y algunas dependencias. Hay algunas formas posibles de representar todos estos elementos en Scala (por ejemplo, HList, tipos de datos algebraicos). Para los propósitos de esta publicación, utilizaremos el Patrón Cake y representaremos las piezas combinables (módulos) como traits. (El Patrón Cake no es un requisito para este enfoque de configuración compilable. Simplemente es una posible implementación de la idea.)
Las dependencias podrían representarse utilizando el Patrón Cake como puntos finales de otros nodos:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
El servicio Echo solo necesita un puerto configurado. Y declaramos que este puerto admite el protocolo de eco. Tenga en cuenta que no necesitamos especificar un puerto particular en este momento, porque los traits permiten declaraciones de métodos abstractos. Si utilizamos métodos abstractos, el compilador requerirá una implementación en una instancia de configuración. Aquí hemos proporcionado la implementación (8081) y se utilizará como valor predeterminado si la omitimos en una configuración concreta.
Podemos declarar una dependencia en la configuración del cliente del servicio echo:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
La dependencia tiene el mismo tipo que el echoService. En particular, exige el mismo protocolo. Por lo tanto, podemos estar seguros de que si conectamos estas dos dependencias, funcionarán correctamente.
Implementación de servicios
Un servicio necesita una función para iniciarse y apagarse de manera controlada. (La capacidad de apagar un servicio es crítica para las pruebas). Nuevamente, hay algunas opciones para especificar tal función para un config dado (por ejemplo, podríamos utilizar clases de tipo). Para esta publicación, nuevamente utilizaremos el Patrón Cake. Podemos representar un servicio utilizando cats.Resource que ya proporciona estructura y liberación de recursos. Para adquirir un recurso, debemos proporcionar una configuración y algún contexto de tiempo de ejecución. Así que la función de inicio del servicio podría verse así:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
donde
Configuración— tipo de configuración que es requerida por este iniciador de servicioAddressResolver— un objeto de tiempo de ejecución que tiene la capacidad de obtener direcciones reales de otros nodos (siga leyendo para más detalles).
los otros tipos provienen de cats:
F[_]— tipo de efecto (en el caso más simpleF[A]podría ser simplemente() => A. En esta publicación usaremoscats.IO.)Reader[A,B]— es más o menos un sinónimo de una funciónA => Bcats.Resource— tiene formas de adquirir y liberarTimer— permite dormir/mide el tiempoContextShift— análogo deExecutionContextApplicative— envoltura de funciones en efecto (casi un mónada) (podríamos eventualmente reemplazarlo con algo más)
Usando esta interfaz, podemos implementar algunos servicios. Por ejemplo, un servicio que no hace nada:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Vea para otras implementaciones de servicios — ,
y .)
Un nodo es un solo objeto que ejecuta algunos servicios (iniciar una cadena de recursos está habilitado por el Patrón Cake):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Tenga en cuenta que en el nodo especificamos el tipo exacto de configuración que necesita este nodo. El compilador no nos permitirá construir el objeto (Cake) con un tipo insuficiente, porque cada trait de servicio declara una restricción sobre el Configuración tipo. Además, no podremos iniciar un nodo sin proporcionar una configuración completa.
Resolución de direcciones de nodo
Para establecer una conexión, necesitamos una dirección de host real para cada nodo. Esta podría conocerse más tarde que otras partes de la configuración. Por lo tanto, necesitamos una forma de suministrar un mapeo entre el ID del nodo y su dirección real. Este mapeo es una función:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Hay algunas formas posibles de implementar dicha función.
- Si conocemos las direcciones reales antes del despliegue, durante la instanciación de los hosts de nodo, entonces podemos generar código Scala con las direcciones reales y ejecutar la compilación posterior (que realiza verificaciones en tiempo de compilación y luego ejecuta la suite de pruebas de integración). En este caso, nuestra función de mapeo se conoce de manera estática y se puede simplificar a algo como un
Map[NodeId, NodeAddress]. - A veces obtenemos direcciones reales solo en un momento posterior cuando el nodo se inicia realmente, o no tenemos direcciones de nodos que no se han iniciado aún. En este caso, podríamos tener un servicio de descubrimiento que se inicie antes de todos los demás nodos y cada nodo podría anunciar su dirección en ese servicio y suscribirse a las dependencias.
- Si podemos modificar
/etc/hosts, podemos usar nombres de host predefinidos (comomy-project-main-nodeyecho-backend) y simplemente asociar este nombre con la dirección IP en el momento del despliegue.
En esta publicación no cubrimos estos casos en más detalle. De hecho, en nuestro ejemplo, todos los nodos tendrán la misma dirección IP — 127.0.0.1.
En esta publicación consideraremos dos disposiciones de sistemas distribuidos:
- Disposición de nodo único, donde todos los servicios se colocan en un solo nodo.
- Disposición de dos nodos, donde el servicio y el cliente están en nodos diferentes.
La configuración para un la disposición es la siguiente:
Configuración de nodo único
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identificador del nodo único
  \/\/ configuración del servidor
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Especificación de puerto de servicio segura. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configuración del cliente

  \/** Usaremos el servicio proporcionado por el mismo host. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hola"

  def pollInterval: FiniteDuration = 1.second

  \/\/ configuración del controlador de ciclo de vida
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0.5 segundos adicionales para que haya 10 solicitudes, no 9.
}
Aquí creamos una única configuración que extiende tanto la configuración del servidor como la del cliente. También configuramos un controlador de ciclo de vida que normalmente terminará el cliente y el servidor después de lifetime que transcurra el intervalo.
El mismo conjunto de implementaciones de servicios y configuraciones se puede usar para crear la disposición de un sistema con dos nodos separados. Solo necesitamos crear con los servicios apropiados:
Configuración de dos nodos
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! especificación de dependencia
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0.5 segundos adicionales para que haya 10 solicitudes, no 9.

    def testMessage: String = "dolly"
  }
Vea cómo especificamos la dependencia. Mencionamos el servicio proporcionado por el otro nodo como una dependencia del nodo actual. El tipo de dependencia se verifica porque contiene un tipo fantasma que describe el protocolo. Y en tiempo de ejecución, tendremos el ID correcto del nodo. Este es uno de los aspectos importantes del enfoque de configuración propuesto. Nos brinda la capacidad de configurar el puerto una sola vez y asegurarnos de que estamos haciendo referencia al puerto correcto.
Implementación de dos nodos
Para esta configuración, usamos exactamente las mismas implementaciones de servicios. No hay cambios en absoluto. Sin embargo, creamos dos implementaciones de nodo diferentes que contienen diferentes conjuntos de servicios:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
El primer nodo implementa el servidor y solo necesita la configuración del lado del servidor. El segundo nodo implementa el cliente y necesita otra parte de la configuración. Ambos nodos requieren una especificación de duración. Para los propósitos de esta publicación, el nodo del servicio tendrá una duración infinita que podría ser terminada usando SIGTERM, mientras que el cliente de eco terminará después de la duración finita configurada. Consulte la para más detalles.
Proceso de desarrollo en general
Veamos cómo este enfoque cambia la forma en que trabajamos con la configuración.
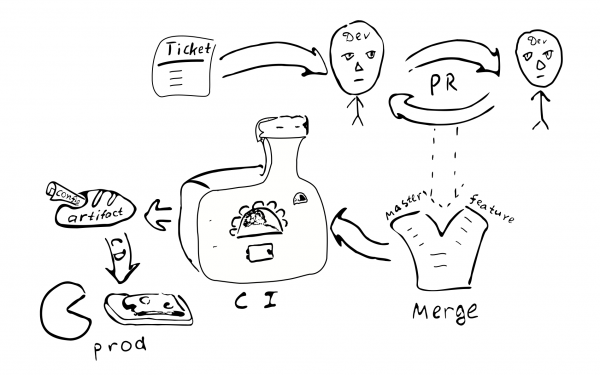
La configuración como código se compilará y producirá un artefacto. Parece razonable separar el artefacto de configuración de otros artefactos de código. A menudo, podemos tener multitud de configuraciones en la misma base de código. Y, por supuesto, podemos tener múltiples versiones de varias ramas de configuración. En una configuración, podemos seleccionar versiones particulares de bibliotecas y esto permanecerá constante cada vez que despleguemos esta configuración.
Un cambio en la configuración se convierte en un cambio en el código. Por lo tanto, debe estar cubierto por el mismo proceso de aseguramiento de calidad:
Ticket -> PR -> revisión -> fusión -> integración continua -> despliegue continuo
Existen las siguientes consecuencias del enfoque:
- La configuración es coherente para una instancia particular del sistema. Parece que no hay forma de tener una conexión incorrecta entre los nodos.
- No es fácil cambiar la configuración en un solo nodo. Parece poco razonable iniciar sesión y cambiar algunos archivos de texto. Por lo tanto, el desvío de configuración se vuelve menos posible.
- No es fácil hacer pequeños cambios en la configuración.
- La mayoría de los cambios en la configuración seguirán el mismo proceso de desarrollo, y pasarán por alguna revisión.
¿Necesitamos un repositorio separado para la configuración de producción? La configuración de producción puede contener información sensible que nos gustaría mantener fuera del alcance de muchas personas. Por lo que podría valer la pena mantener un repositorio separado con acceso restringido que contenga la configuración de producción. Podemos dividir la configuración en dos partes: una que contenga la mayoría de los parámetros abiertos de producción y otra que contenga la parte secreta de la configuración. Esto permitiría acceso a la mayoría de los desarrolladores a la gran mayoría de los parámetros mientras se restringe el acceso a cosas realmente sensibles. Es fácil lograr esto utilizando rasgos intermedios con valores predeterminados de parámetros.
Variaciones
Veamos los pros y los contras del enfoque propuesto en comparación con otras técnicas de gestión de configuración.
Primero que nada, enumeraremos algunas alternativas a los diferentes aspectos de la forma propuesta de manejar la configuración:
- Archivo de texto en la máquina objetivo.
- Almacenamiento centralizado de clave-valor (como
etcd/zookeeper). - Componentes de subprocesso que podrían ser reconfigurados/reiniciados sin reiniciar el proceso.
- Configuración fuera del artefacto y control de versiones.
El archivo de texto ofrece cierta flexibilidad en términos de correcciones ad-hoc. Un administrador del sistema puede iniciar sesión en el nodo objetivo, realizar un cambio y simplemente reiniciar el servicio. Esto podría no ser tan bueno para sistemas más grandes. No quedan rastros del cambio. El cambio no ha sido revisado por otra persona. Puede ser difícil averiguar qué causó el cambio. No ha sido probado. Desde la perspectiva de un sistema distribuido, un administrador puede simplemente olvidar actualizar la configuración en uno de los otros nodos.
(Por cierto, si eventualmente se necesita comenzar a utilizar archivos de configuración de texto, solo tendremos que agregar un analizador + validador que pueda producir el mismo Configuración tipo y eso sería suficiente para comenzar a usar configuraciones de texto. Esto también muestra que la complejidad de la configuración en tiempo de compilación es un poco menor que la complejidad de las configuraciones basadas en texto, porque en la versión basada en texto necesitamos algo de código adicional.)
El almacenamiento centralizado de clave-valor es un buen mecanismo para distribuir parámetros meta de aplicación. Aquí necesitamos pensar en lo que consideramos como valores de configuración y qué es solo datos. Dada una función C => A => B generalmente llamamos valores que cambian raramente C «configuración», mientras que los datos que cambian frecuentemente A son solo datos de entrada. La configuración debe proporcionarse a la función antes que los datos. ADada esta idea, podemos decir que es la frecuencia esperada de cambios lo que se podría usar para distinguir los datos de configuración de solo datos. Además, los datos típicamente provienen de una fuente (usuario) y la configuración proviene de una fuente diferente (administrador). Manejar parámetros que pueden cambiar después de la inicialización del proceso lleva a un aumento de la complejidad de la aplicación. Para tales parámetros, tendremos que manejar su mecanismo de entrega, análisis y validación, y el manejo de valores incorrectos. Por lo tanto, para reducir la complejidad del programa, sería mejor reducir el número de parámetros que pueden cambiar en tiempo de ejecución (o incluso eliminarlos por completo).
Desde la perspectiva de esta publicación, debemos hacer una distinción entre parámetros estáticos y dinámicos. Si la lógica del servicio requiere un cambio raro de algunos parámetros en tiempo de ejecución, entonces podemos llamarlos parámetros dinámicos. De lo contrario, son estáticos y se pueden configurar utilizando el enfoque propuesto. Para la reconfiguración dinámica, pueden ser necesarios otros enfoques. Por ejemplo, partes del sistema podrían reiniciarse con los nuevos parámetros de configuración de manera similar a reiniciar procesos separados de un sistema distribuido.
(En mi humilde opinión, es mejor evitar la reconfiguración en tiempo de ejecución porque aumenta la complejidad del sistema.
Puede ser más directo confiar en el soporte del sistema operativo para reiniciar procesos. Sin embargo, esto puede no ser siempre posible.)
Un aspecto importante del uso de la configuración estática que a veces hace que las personas consideren la configuración dinámica (sin otras razones) es el tiempo de inactividad del servicio durante la actualización de la configuración. De hecho, si tenemos que hacer cambios en la configuración estática, debemos reiniciar el sistema para que los nuevos valores se hagan efectivos. Los requisitos de tiempo de inactividad varían según los diferentes sistemas, por lo que puede no ser tan crítico. Si es crítico, entonces debemos planificar con anticipación cualquier reinicio del sistema. Por ejemplo, podríamos implementar . En este escenario, cada vez que necesitamos reiniciar el sistema, iniciamos una nueva instancia del sistema en paralelo, luego cambiamos el ELB hacia ella, mientras dejamos que el antiguo sistema complete el servicio de las conexiones existentes.
¿Qué hay de mantener la configuración dentro de un artefacto versionado o por fuera? Mantener la configuración dentro de un artefacto significa que en la mayoría de los casos esta configuración ha pasado por el mismo proceso de aseguramiento de calidad que otros artefactos. Así que se puede estar seguro de que la configuración es de buena calidad y confiable. Por el contrario, la configuración en un archivo separado significa que no hay rastros de quién y por qué hizo cambios en ese archivo. ¿Es esto importante? Creemos que para la mayoría de los sistemas de producción es mejor tener configuraciones estables y de alta calidad.
La versión del artefacto permite averiguar cuándo fue creado, qué valores contiene, qué características están habilitadas/deshabilitadas, quién fue responsable de hacer cada cambio en la configuración. Puede requerir un esfuerzo mantener la configuración dentro de un artefacto y es una elección de diseño que hacer.
Pros y contras
Aquí nos gustaría resaltar algunas ventajas y discutir algunas desventajas del enfoque propuesto.
Ventajas
Características de la configuración compilable de un sistema distribuido completo:
- Verificación estática de la configuración. Esto brinda un alto nivel de confianza en que la configuración es correcta dada las restricciones de tipo.
- Lenguaje rico de configuración. Típicamente, otros enfoques de configuración están limitados a, como máximo, la sustitución de variables.
Usando Scala, se puede utilizar una amplia gama de características del lenguaje para mejorar la configuración. Por ejemplo, podemos usar traits para proporcionar valores predeterminados, objetos para establecer diferentes ámbitos, podemos referirnos avals definidos solo una vez en el ámbito exterior (DRY). Es posible usar secuencias literales, o instancias de ciertas clases (Seq,Map, etc.). - DSL. Scala tiene un soporte decente para escritores de DSL. Se pueden usar estas características para establecer un lenguaje de configuración que sea más conveniente y amigable para el usuario final, de modo que la configuración final sea al menos legible por los usuarios del dominio.
- Integridad y coherencia entre nodos. Uno de los beneficios de tener la configuración para todo el sistema distribuido en un solo lugar es que todos los valores se definen estrictamente una vez y luego se reutilizan en todos los lugares donde los necesitamos. Además, las declaraciones de puerto seguras en cuanto a tipo aseguran que en todas las configuraciones correctas posibles los nodos del sistema hablarán el mismo idioma. Hay dependencias explícitas entre nodos que hacen que sea difícil olvidar proporcionar algunos servicios.
- Alta calidad de los cambios. El enfoque general de pasar cambios de configuración a través del proceso normal de PR establece estándares de alta calidad también en la configuración.
- Cambios de configuración simultáneos. Cuando realizamos cambios en la configuración, el despliegue automático asegura que todos los nodos se actualicen.
- Simplificación de la aplicación. La aplicación no necesita analizar ni validar la configuración ni manejar valores de configuración incorrectos. Esto simplifica la aplicación en general. (Algunos aumentos en la complejidad están en la propia configuración, pero es un compromiso consciente hacia la seguridad). Es bastante sencillo volver a la configuración ordinaria: solo hay que añadir las piezas faltantes. Es más fácil comenzar con una configuración compilada y posponer la implementación de piezas adicionales para momentos posteriores.
- Configuración versionada. Debido a que los cambios de configuración siguen el mismo proceso de desarrollo, como resultado obtenemos un artefacto con una versión única. Nos permite revertir la configuración si es necesario. Incluso podemos desplegar una configuración que se utilizó hace un año y funcionará exactamente de la misma manera. Una configuración estable mejora la previsibilidad y fiabilidad del sistema distribuido. La configuración se fija en el tiempo de compilación y no puede ser fácilmente manipulada en un sistema de producción.
- Modularidad. El marco propuesto es modular y los módulos se pueden combinar de diversas maneras para
soportar diferentes configuraciones (configuraciones/distribuciones). En particular, es posible tener un diseño de nodo único a pequeña escala y una configuración multinode grande. Es razonable tener múltiples configuraciones de producción. - Pruebas. Con fines de prueba, se puede implementar un servicio simulado y usarlo como una dependencia de manera segura en términos de tipo. Se podrían mantener simultáneamente diferentes configuraciones de prueba con varias partes reemplazadas por simulaciones.
- Pruebas de integración. A veces, en sistemas distribuidos es difícil realizar pruebas de integración. Usando el enfoque descrito para la configuración segura por tipo del sistema distribuido completo, podemos ejecutar todas las partes distribuidas en un solo servidor de manera controlable. Es fácil emular la situación
cuando uno de los servicios se vuelve inalcanzable.
Desventajas
El enfoque de configuración compilada es diferente de la configuración «normal» y puede no adecuarse a todas las necesidades. Aquí algunas de las desventajas de la configuración compilada:
- Configuración estática. Puede que no sea adecuada para todas las aplicaciones. En algunos casos, es necesario arreglar rápidamente la configuración en producción eludiendo todas las medidas de seguridad. Este enfoque lo dificulta. La compilación y el redepliegue son necesarios después de realizar cualquier cambio en la configuración. Esta es tanto una característica como una carga.
- Generación de configuración. Cuando la configuración es generada por alguna herramienta de automatización, este enfoque requiere una compilación subsecuente (que podría fallar). Puede que requiera esfuerzo adicional integrar este paso en el sistema de construcción.
- Herramientas. Hay muchas herramientas en uso hoy que dependen de configuraciones basadas en texto. Algunas de ellas
no serán aplicables cuando la configuración esté compilada. - Se necesita un cambio de mentalidad. Los desarrolladores y DevOps están familiarizados con archivos de configuración de texto. La idea de compilar la configuración podría parecer extraña para ellos.
- Antes de introducir la configuración compilable, se requiere un proceso de desarrollo de software de alta calidad.
Hay algunas limitaciones en el ejemplo implementado:
- Si proporcionamos configuración adicional que no es demandada por la implementación del nodo, el compilador no nos ayudará a detectar la implementación ausente. Esto podría abordarse utilizando
HListo ADTs (clases de caso) para la configuración del nodo en lugar de rasgos y el patrón Cake. - Debemos proporcionar algo de código base en el archivo de configuración: (
package,import,objectdeclaraciones;
override def's para parámetros que tienen valores predeterminados). Esto podría abordarse parcialmente utilizando un DSL. - En esta publicación no cubrimos la reconfiguración dinámica de clústeres de nodos similares.
Conclusión
En este post hemos discutido la idea de representar la configuración directamente en el código fuente de una manera segura en cuanto a tipos. Este enfoque podría utilizarse en muchas aplicaciones como un reemplazo a las configuraciones basadas en XML y otros textos. A pesar de que nuestro ejemplo se ha implementado en Scala, también podría traducirse a otros lenguajes compilables (como Kotlin, C#, Swift, etc.). Se podría probar este enfoque en un nuevo proyecto y, en caso de que no funcione bien, volver a la forma tradicional.
Por supuesto, la configuración compilable requiere un proceso de desarrollo de alta calidad. A cambio, promete proporcionar una configuración robusta de igual calidad.
Este enfoque podría ampliarse de varias maneras:
- Se podrían usar macros para realizar la validación de la configuración y fallar en tiempo de compilación en caso de incumplimientos de las restricciones de lógica comercial.
- Se podría implementar un DSL para representar la configuración de una manera amigable para el usuario del dominio.
- Gestión dinámica de recursos con ajustes automáticos de configuración. Por ejemplo, cuando ajustamos el número de nodos en el clúster, podríamos querer (1) que los nodos obtengan una configuración ligeramente modificada; (2) que el administrador del clúster reciba información sobre los nuevos nodos.
Gracias
Quisiera agradecer a Andrey Saksonov, Pavel Popov, Anton Nehaev por dar retroalimentación inspiradora sobre el borrador de este post que me ayudó a hacerlo más claro.
Fuente: habr.com
