

Lo primero que hay que hacer al trabajar con un nuevo conjunto de datos es comprenderlo. Para ello, es necesario, por ejemplo, determinar los rangos de valores que pueden tomar las variables, sus tipos, así como conocer la cantidad de valores faltantes.
La biblioteca pandas nos proporciona muchas herramientas útiles para realizar análisis exploratorios de datos (Exploratory Data Analysis, EDA). Pero, antes de utilizarlas, generalmente se debe comenzar con funciones más generales, como df.describe(). Sin embargo, hay que señalar que las capacidades que ofrecen estas funciones son limitadas, y las etapas iniciales de trabajo con cualquier conjunto de datos durante el EDA suelen ser bastante similares entre sí.
El autor del material que hoy publicamos dice que no es un amante de realizar acciones repetitivas. Como resultado, en su búsqueda de herramientas que permitan realizar análisis exploratorios de datos de manera rápida y eficiente, encontró la biblioteca . Los resultados que genera no se expresan en forma de indicadores aislados, sino en un informe HTML bastante detallado que contiene gran parte de la información sobre los datos analizados que puede ser necesaria antes de iniciar un trabajo más profundo con ellos.
A continuación, se examinarán las características del uso de la biblioteca pandas-profiling, utilizando como ejemplo el conjunto de datos del Titanic.
Análisis exploratorio de datos con pandas
Decidí experimentar con pandas-profiling en el conjunto de datos del Titanic porque contiene datos de diferentes tipos y porque tiene valores ausentes. Creo que la biblioteca pandas-profiling es especialmente interesante en aquellos casos en los que los datos aún no están limpios y requieren un procesamiento adicional, dependiendo de sus características. Para llevar a cabo dicho procesamiento exitosamente, es necesario saber por dónde empezar y en qué prestar atención. Aquí es donde nos serán útiles las capacidades de pandas-profiling.
Primero importemos los datos y utilicemos pandas para obtener las métricas de estadísticas descriptivas:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Después de ejecutar este fragmento de código, obtendremos lo que se muestra en la siguiente figura.
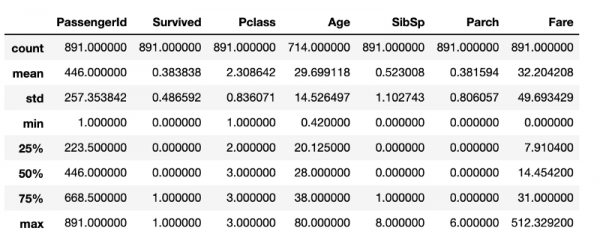
Las métricas de estadísticas descriptivas obtenidas mediante las herramientas estándar de pandas.
Aunque aquí hay mucha información útil, no contiene todo lo que sería interesante saber sobre los datos investigados. Por ejemplo, se puede suponer que en el marco de datos, en la estructura DataFrame, hay 891 filas. Si se necesita verificar esto, se requerirá otra línea de código que defina el tamaño del marco. Aunque estos cálculos no son especialmente intensivos en recursos, repetirlos constantemente llevará a la pérdida de tiempo, que probablemente sería mejor gastar en la limpieza de datos.
Análisis exploratorio de datos utilizando pandas-profiling
Ahora haremos lo mismo utilizando pandas-profiling:
pandas_profiling.ProfileReport(df)La ejecución de la línea de código mostrada arriba permitirá generar un informe con los indicadores del análisis exploratorio de datos. El código mostrado anteriormente resultará en la salida de la información encontrada sobre los datos, pero se puede hacer para que el resultado sea un archivo HTML, que, por ejemplo, se puede mostrar a alguien.
La primera parte del informe contendrá la sección Overview, que proporciona información básica sobre los datos (número de observaciones, número de variables, etc.). Además, contendrá una lista de advertencias, notificando al analista sobre lo que debe prestar especial atención. Estas advertencias pueden servir como una pista sobre en qué enfocar los esfuerzos al limpiar los datos.
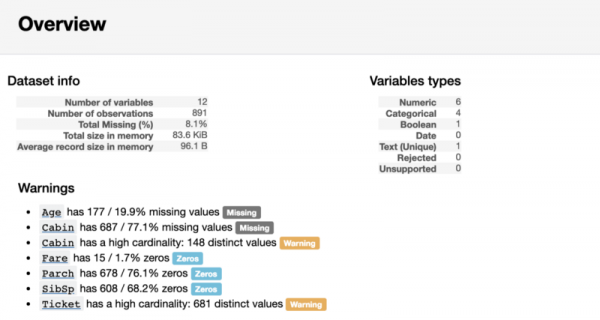
Sección del informe Overview
Análisis exploratorio de variables
Detrás de la sección Overview en el informe se pueden encontrar información útil sobre cada variable. Estos incluyen, entre otras cosas, pequeños gráficos que describen la distribución de cada variable.
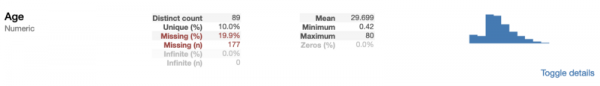
Información sobre la variable numérica Age
Como se puede ver en el ejemplo anterior, pandas-profiling nos da algunos indicadores útiles, como el porcentaje y número de valores faltantes, así como estadísticas descriptivas que ya hemos visto. Dado que Age es una variable numérica, visualizar su distribución en forma de histograma nos permite concluir que se trata de una distribución sesgada a la derecha.
Al considerar una variable categórica, los indicadores mostrados son algo diferentes de los encontrados para la variable numérica.
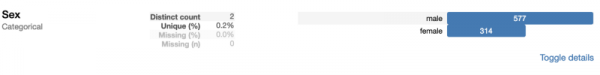
Información sobre la variable categórica Sex
Es decir, en lugar de encontrar la media, el mínimo y el máximo, la biblioteca pandas-profiling encontró el número de clases. Dado que Sexo — es una variable binaria, cuyos valores se representan en dos clases.
Si tú, al igual que yo, disfrutas explorando el código, podría interesarte cómo la biblioteca pandas-profiling calcula estas métricas. Descubrir esto, considerando que el código de la biblioteca es abierto y está disponible en GitHub, no es tan difícil. Como no soy un gran aficionado a utilizar "cajas negras" en mis proyectos, eché un vistazo al código fuente de la biblioteca. Por ejemplo, así es como luce el mecanismo para procesar variables numéricas, presentado en la función :
def describe_numeric_1d(series, **kwargs):
    """Calcula estadísticas resumidas de una variable numérica (`TYPE_NUM`) (una Serie).
    Además crea histogramas (mini y completo) de su distribución.
    Parámetros
    ----------
    series : Serie
        La variable a describir.
    Retorna
    -------
    Serie
        La descripción de la variable como una Serie con índice siendo las claves de estadísticas.
    """
    # Formatea un número como un porcentaje. Por ejemplo, 0.25 se convertirá en 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # Para evitar calcularlo varias veces
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # El dropna() es una solución temporal para https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogramas
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Aunque este fragmento de código puede parecer bastante grande y complejo, en realidad es muy fácil de entender. Se trata de que en el código fuente de la biblioteca hay una función que determina los tipos de variables. Si se determina que la biblioteca se encontró con una variable numérica, la función mencionada encontrará las métricas que discutimos. Esta función utiliza las operaciones estándar de pandas para trabajar con objetos de tipo Serie, similar a series.mean(). Los resultados de los cálculos se almacenan en un diccionario stats. Los histogramas se generan utilizando una versión adaptada de la función matplotlib.pyplot.hist. La adaptación tiene como objetivo permitir que la función opere con diversos tipos de conjuntos de datos.
Indicadores de correlación y muestra de los datos investigados
Después de analizar las variables en pandas-profiling, la sección Correlations mostrará las matrices de correlación de Pearson y Spearman.
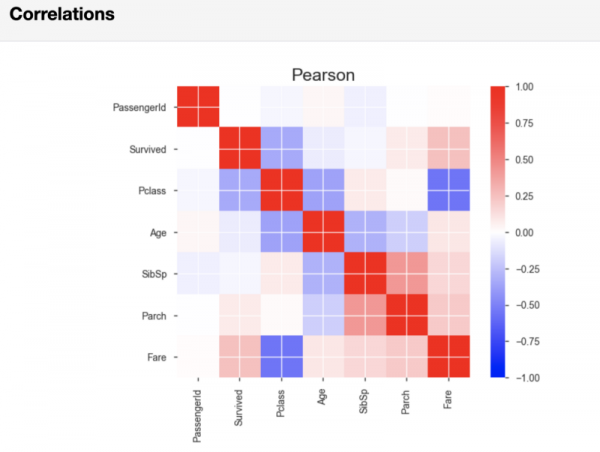
Matriz de correlación de Pearson
Si es necesario, en la línea de código que inicia la generación del informe, se pueden establecer los indicadores de los valores umbral a aplicar al calcular la correlación. Al hacerlo, puede especificar qué fuerza de correlación se considera relevante para su análisis.
Y finalmente, en el informe de pandas-profiling, en la sección Sample, se muestra, como ejemplo, un fragmento de datos tomado del principio del conjunto de datos. Este enfoque puede llevar a sorpresas no deseadas, ya que las primeras observaciones pueden ser una muestra que no refleja las características de todo el conjunto de datos.
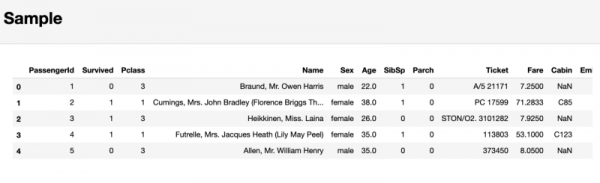
Sección que contiene la muestra de los datos investigados
Como resultado, no recomiendo prestar atención a esta última sección. En su lugar, es mejor utilizar el comando df.sample(5), que seleccionará al azar 5 observaciones del conjunto de datos.
Resultados
En resumen, se puede señalar que la biblioteca pandas-profiling ofrece a los analistas algunas capacidades útiles que serán beneficiosas en aquellos casos donde se necesita obtener rápidamente una visión general aproximada de los datos o transmitir a alguien un informe sobre el análisis exploratorio de datos. La verdadera labor con los datos, teniendo en cuenta sus características, se realiza, como antes, manualmente, independientemente del uso de pandas-profiling.
Si desea ver cómo se ve todo el análisis exploratorio de datos en un solo cuaderno de Jupyter, eche un vistazo a mi proyecto creado con nbviewer. Y en el repositorio de GitHub puede encontrar el código correspondiente.
¡Estimados lectores! ¿Por dónde empiezas el análisis de nuevos conjuntos de datos?
Fuente: habr.com
