

Első lépésként, amikor új adathalmazon kezdenek dolgozni, meg kell érteni azt. Ennek érdekében például meg kell határozni a változók által elfogadott értékek tartományait, típusaikat, valamint információkat kell gyűjteni a hiányzó értékek számáról.
A pandas könyvtár számos hasznos eszközt biztosít az adatfeltáró elemzés (Exploratory Data Analysis, EDA) elvégzéséhez. Azonban mielőtt igénybe vennénk ezeket, általában a közvetlenebb használatú funkciókkal kell kezdenünk, mint például a df.describe(). Igaz, hogy ezen funkciók által biztosított lehetőségek korlátozottak, és a bármilyen adathalmazon végzett EDA kezdeti szakaszai gyakran nagyon hasonlóak egymáshoz.
A mai cikk szerzője elmondja, hogy nem kedveli a repetitív feladatok végrehajtását. Ennek eredményeként, abban a keresésben, hogy hogyan lehet gyorsan és hatékonyan elvégezni az adatfeltáró elemzést, rátalált a könyvtárra . Az általa generált eredmények nem különálló mutatók formájában jelennek meg, hanem egy viszonylag részletes HTML-jelentés formájában, amely a vizsgált adatok nagy részét tartalmazza, amit a mélyebb elemzés előtt tudni érdemes.
Itt a pandas-profiling könyvtár használatának sajátosságait fogjuk megvizsgálni a Titanic adathalmazon keresztül.
Adatfeltáró elemzés pandas segítségével
Kísérletezni akartam a pandas-profiling könyvtárral a Titanic adathalmazon, mivel ez különböző típusú adatokat tartalmaz, és hiányzó értékekkel is rendelkezik. Úgy gondolom, hogy a pandas-profiling könyvtár különösen érdekes azokban az esetekben, amikor az adatok még nincsenek megtisztítva és további feldolgozást igényelnek, amely az adatok jellemzőitől függ. A sikeres feldolgozáshoz tudni kell, honnan induljunk és mire figyeljünk. Itt jön a képbe a pandas-profiling lehetősége.
Első lépésként importáljuk az adatokat, és használjuk a pandast az leíró statisztikák megszerzésére:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
A kód ezen részének végrehajtása után a következő ábrához hasonló eredmény jön létre.
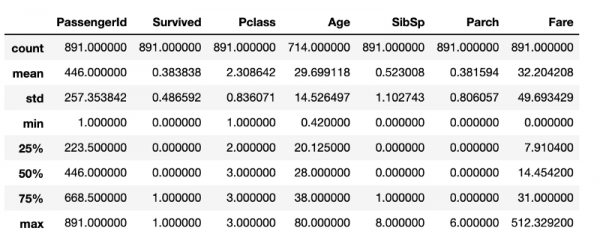
A leíró statisztikák, amelyeket a pandas standard eszközeivel nyertünk.
Bár sok hasznos információ található itt, nem minden van meg, amit az adatokról tudni érdemes. Például feltételezhető, hogy az adathalmazon, a struktúrában DataFrame, 891 sor található. Ha ezt ellenőrizni szeretnénk, akkor még egy sor kódra van szükség, amely meghatározza az adathalmaz méretét. Bár ezek a számítások nem különösebben erőforrás-igényesek, azok folyamatos ismétlése időveszteséghez vezet, amit valószínűleg jobban költhetnénk az adatok tisztítására.
Felfedező adat-elemzés a pandas-profiling segítségével
Most ugyanazt fogjuk tenni a pandas-profiling használatával:
pandas_profiling.ProfileReport(df)A fenti kódsor végrehajtása lehetővé teszi egy jelentés elkészítését az adatfelfedezés mutatóival. A fenti kód az adatokkal kapcsolatos információk megjelenítésére vezet, de lehetőség van arra is, hogy az eredmény egy HTML-fájl legyen, amit például meg lehet mutatni valakinek.
A jelentés első része tartalmazni fog egy Áttekintés (Overview) szakaszt, amely az adatok alapvető információit nyújtja (megfigyelések száma, változók száma stb.). Ezen kívül tartalmazni fog egy figyelmeztetések listáját, amely értesíti az elemzőt arról, hogy mire érdemes külön figyelmet fordítani. Ezek a figyelmeztetések nyújthatnak útmutatást arról, hogy miken érdemes dolgozni az adatok tisztítása során.
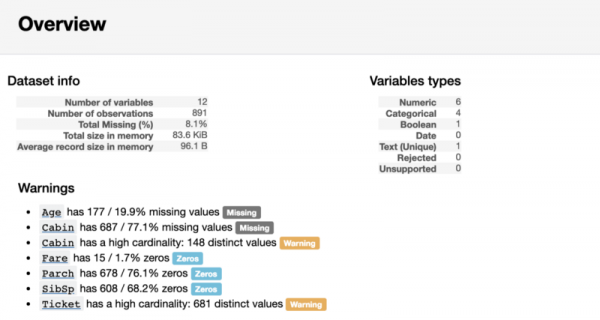
Az Áttekintés jelentés szakasza
Változók felfedező elemzése
Az Áttekintés után a jelentésben hasznos információkat találunk minden változóról. Ezek között, többek között, kis diagramok találhatók, amelyek a változók eloszlását mutatják be.
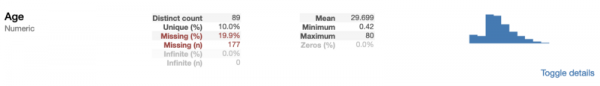
A kor (Age) számadatokról
Amint azt az előző példából láthatjuk, a pandas-profiling több hasznos indikátort ad nekünk, mint például a hiányzó értékek aránya és száma, valamint a már látott leíró statisztikai mutatók. Mivel Age ez egy számszerű változó, a hisztogram formájában való vizualizálása lehetővé teszi számunkra, hogy az eloszlás jobbra ferde.
A kategóriás változó vizsgálatakor a megjelenített mutatók némileg eltérnek a számszerű változó esetén találtaktól.
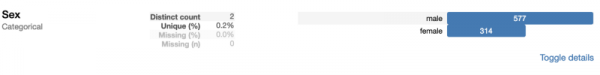
A nem (Sex) kategóriás változóról
Nevezetesen, ahelyett, hogy az átlagot, minimumot és maximumot keresne, a pandas-profiling könyvtár megtalálta az osztályok számát. Mivel Nem — bináris változó, értékei két osztályt képviselnek.
Ha ön, ahogyan én is, szeret felfedezni kódokat, akkor érdekelheti, hogy pontosan hogyan számolja ki a pandas-profiling könyvtár ezeket a mutatókat. Ennek megismerése, figyelembe véve, hogy a könyvtár kódja nyílt és elérhető a GitHubon, nem túl bonyolult. Mivel nem vagyok nagy rajongója a szürke dobozok használatának a projektjeimben, belepillantottam a könyvtár forráskódjába. Például, így néz ki a numerikus változók feldolgozásának mechanizmusa, amelyet a következő funkció mutat be: :
def describe_numeric_1d(series, **kwargs):
    """Számolja ki egy numerikus (`TYPE_NUM`) változó (egy Sorozat) összefoglaló statisztikáit.
    Emellett histogramokat (mini és teljes) készít az eloszlásáról.
    Paraméterek
    ----------
    sorozat : Sorozat
        A leírandó változó.
    Visszatér
    -------
    Sorozat
        A változó leírása Sorozatként, ahol az index az statisztikai kulcsok.
    """
    # Formázza a számot százalékos értékként. Például 0.25 -et 25% -okká alakít.
    _percentile_format = "{:.0%}"
    statisztika = dict()
    statisztika['típus'] = base.TYPE_NUM
    statisztika['átlag'] = sorozat.mean()
    statisztika['szórás'] = sorozat.std()
    statisztika['variancia'] = sorozat.var()
    statisztika['minimum'] = sorozat.min()
    statisztika['maximum'] = sorozat.max()
    statisztika['tartomány'] = statisztika['maximum'] - statisztika['minimum']
    # Anélkül, hogy többször kiszámolnánk
    _sorozat_no_na = sorozat.dropna()
    for percentil in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # A dropna() egy megoldás a https://github.com/pydata/pandas/issues/13098 problémára
        statisztika[_percentile_format.format(percentil)] = _sorozat_no_na.quantile(percentil)
    statisztika['iqr'] = statisztika['75%'] - statisztika['25%']
    statisztika['kurtózis'] = sorozat.kurt()
    statisztika['ferdeség'] = sorozat.skew()
    statisztika['összeg'] = sorozat.sum()
    statisztika['mad'] = sorozat.mad()
    statisztika['cv'] = statisztika['szórás'] / statisztika['átlag'] if statisztika['átlag'] else np.NaN
    statisztika['n_zeros'] = (len(sorozat) - np.count_nonzero(sorozat))
    statisztika['p_zeros'] = statisztika['n_zeros'] * 1.0 / len(sorozat)
    # Histogramok
    statisztika['hisztogram'] = hisztogram(sorozat, **kwargs)
    statisztika['mini_hisztogram'] = mini_hisztogram(sorozat, **kwargs)
    return pd.Series(statisztika, name=sorozat.name)
Bár ez a kódrészlet meglehetősen nagy és bonyolultnak tűnhet, valójában nagyon egyszerű megérteni. Arról van szó, hogy a könyvtár forráskódjában található egy függvény, amely meghatározza a változók típusait. Ha kiderül, hogy a könyvtár numerikus változót talált, akkor a fenti függvény megtalálja azokat a mutatókat, amelyeket megvizsgáltunk. Ebben a függvényben a pandas standard műveletei használatosak az Sorozatokkal, hasonlóan a sorozat.mean(). A számítások eredményei a statisztika. A histogramokat az adaptált változatú matplotlib.pyplot.histA módosítás célja, hogy a funkció különféle adathalmazokkal működjön.
Korrelációs mutatók és a vizsgált adatok mintája
A pandas-profiling változói elemzésének eredménye után a Korrelációk szakaszban megjelenik a Pearson és Spearman korrelációs mátrix.
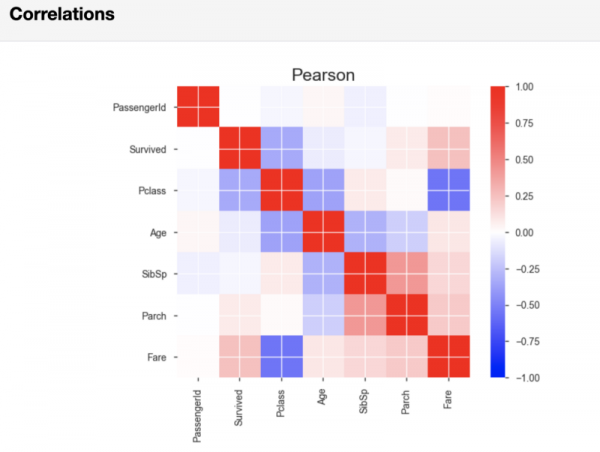
Pearson korrelációs mátrix
Ha szükséges, a jelentés generálását elindító kódsorban megadhatja a korreláció számítása során alkalmazott küszöbértékek mutatóit. Ezzel meg tudja határozni, hogy milyen korrelációs erő számít fontosnak az elemzése szempontjából.
Végül a pandas-profiling jelentésében, a Minta szakaszban a kezdeti adathalmazból származó adatmintát, példaként, megjelenít.
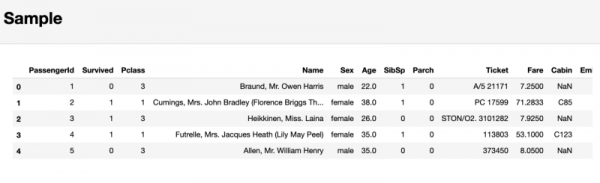
A vizsgált adatok mintáját tartalmazó szakasz
Ezért nem ajánlom figyelmet fordítani erre az utolsó szakaszra. Helyette inkább használja a parancsot df.sample(5), amely véletlenszerűen kiválaszt 5 megfigyelést az adathalmazból.
Összegzés
Összefoglalva elmondható, hogy a pandas-profiling könyvtár hasznos lehetőségeket kínál az elemzőknek, amelyek hasznosak lehetnek, amikor gyorsan általános képet szeretnének kapni az adatokról, vagy jelentést kell átadniuk valakinek az adatok feltáró elemzéséről. Az igazi munkát azonban, amely figyelembe veszi az adatok sajátosságait, akár a pandas-profiling használata nélkül is, manuálisan kell elvégezni.
Ha szeretné látni, hogyan néz ki a teljes feltáró adatvizsgálat egy Jupyter-notebookban, nézze meg a projektjeimet, amelyeket az nbviewer segítségével hoztam létre. A GitHub-repozitóriumban megtalálja a megfelelő kódot.
Használjátok a CI/CD technológiákat a projektjeitekben? Honnan kezd egy új adathalmaz elemzését?
Forrás: habr.com
