

Allereerst, wanneer je begint te werken met een nieuwe dataset, is het belangrijk om deze te begrijpen. Om dat te doen, moet je bijvoorbeeld de waarde-intervallen van de variabelen, hun typen en het aantal ontbrekende waarden achterhalen.
De pandas-bibliotheek biedt ons veel nuttige tools voor het uitvoeren van Exploratory Data Analysis (EDA). Maar voordat we deze gebruiken, beginnen we meestal met meer algemene functies, zoals df.describe(). Het is echter belangrijk op te merken dat de mogelijkheden van dergelijke functies beperkt zijn, en de eerste stappen in het werken met datasets tijdens EDA vaak sterk op elkaar lijken.
De auteur van het materiaal dat we vandaag publiceren, geeft aan dat hij geen fan is van herhaalde handelingen. Daarom vond hij, op zoek naar middelen om snel en efficiënt EDA uit te voeren, de bibliotheek . De resultaten van deze bibliotheek worden niet gepresenteerd als afzonderlijke statistieken, maar in de vorm van een vrij gedetailleerd HTML-rapport, dat het meeste van de informatie over de te analyseren gegevens bevat die je moet weten voordat je verder gaat met het werken ermee.
Hier zullen we de kenmerken van de pandas-profiling bibliotheek bekijken aan de hand van de Titanic-dataset.
Verkennende data-analyse met behulp van pandas
Ik besloot te experimenteren met pandas-profiling op de Titanic-dataset omdat deze gegevens van verschillende types bevat en ontbrekende waarden heeft. Ik geloof dat de pandas-profiling bibliotheek vooral interessant is in gevallen waarin de gegevens nog niet zijn schoongemaakt en verdere verwerking vereisen, afhankelijk van hun kenmerken. Om dergelijke bewerkingen succesvol uit te voeren, is het belangrijk om te weten waar je moet beginnen en waar je op moet letten. Hier komen de mogelijkheden van pandas-profiling goed van pas.
Laten we beginnen met het importeren van de gegevens en gebruik maken van pandas om beschrijvende statistieken te verkrijgen:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Na het uitvoeren van dit codefragment zal het resultaat eruitzien als getoond in de volgende afbeelding.
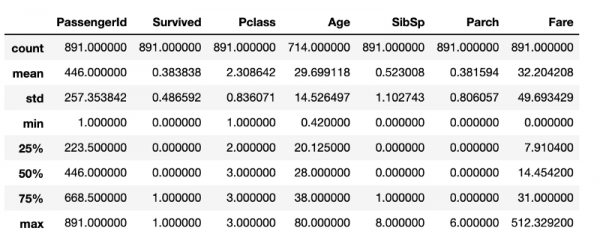
Beschrijvende statistieken verkregen met behulp van de standaard pandas-tools.
Hoewel hier veel nuttige informatie te vinden is, ontbreekt alles wat interessant zou zijn om te weten over de onderzochte gegevens. Zo kan worden aangenomen dat het DataFrame, in de structuur, DataFrame, 891 rijen bevat. Om dit te controleren, is er nog een regel code nodig om de grootte van het frame te bepalen. Hoewel deze berekeningen niet bijzonder hulpbronnenintensief zijn, zal het voortdurend herhalen ervan zeker leiden tot tijdverlies, dat waarschijnlijk beter besteed kan worden aan het opschonen van de gegevens.
Exploratieve data-analyse met behulp van pandas-profiling
Laten we hetzelfde doen met pandas-profiling:
pandas_profiling.ProfileReport(df)Het uitvoeren van de bovenstaande regel code zal een rapport genereren met de resultaten van de exploratieve data-analyse. De bovenstaande code zal informatie over de gegevens opleveren, maar het is ook mogelijk om een HTML-bestand te maken dat bijvoorbeeld aan iemand kan worden getoond.
Het eerste deel van het rapport zal een sectie Overzicht bevatten, die de basisinformatie over de gegevens geeft (aantal waarnemingen, aantal variabelen, enzovoort). Daarnaast bevat het een lijst met waarschuwingen die de analist waarschuwen voor zaken om extra op te letten. Deze waarschuwingen kunnen een hint geven over waar de focus moet liggen bij het opschonen van de gegevens.
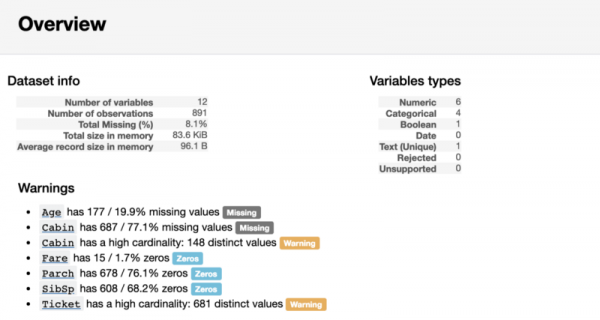
Sectie overzicht van het rapport
Exploratieve analyse van variabelen
Na de sectie Overzicht in het rapport kunnen nuttige informatie over elke variabele worden gevonden. Deze omvatten, naast andere dingen, kleine diagrammen die de distributie van elke variabele beschrijven.
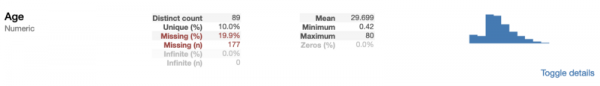
Informatie over de numerieke variabele Leeftijd
Zoals te zien is in het vorige voorbeeld, geeft pandas-profiling ons enkele nuttige indicatoren, zoals het percentage en aantal ontbrekende waarden, evenals beschrijvende statistieken die we al hebben gezien. Aangezien Leeftijd een numerieke variabele is, stelt de visualisatie van de distributie daarvan in de vorm van een histogram ons in staat de conclusie te trekken dat we te maken hebben met een rechtsscheve distributie.
Bij het bekijken van een categorische variabele verschillen de weergegeven indicatoren iets van die voor de numerieke variabele.
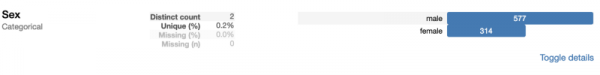
Informatie over de categorische variabele Geslacht
Specifiek, in plaats van het gemiddelde, minimum en maximum te berekenen, heeft de pandas-profiling bibliotheek het aantal klassen gevonden. Aangezien Geslacht — een binaire variabele, waarvan de waarden door twee klassen worden vertegenwoordigd.
Als je, net als ik, graag met code experimenteert, dan ben je misschien geïnteresseerd in hoe de pandas-profiling bibliotheek deze statistieken berekent. Het is niet zo moeilijk om daarover meer te leren, aangezien de bibliotheekcode open-source is en beschikbaar op GitHub. Omdat ik niet echt van het gebruik van 'zwarte dozen' in mijn projecten hou, heb ik een blik geworpen op de broncode van de bibliotheek. Hier is bijvoorbeeld hoe het mechanisme voor het verwerken van numerieke variabelen eruitziet, weergegeven door de functie :
def describe_numeric_1d(series, **kwargs):
    """Bereken samenvattende statistieken van een numerieke (`TYPE_NUM`) variabele (een Series).
    Maak ook histogrammen (mini en volledig) van de distributie.
    Parameters
    ----------
    series : Series
        De variabele die beschreven moet worden.
    Returns
    -------
    Series
        De beschrijving van de variabele als een Serie met de index als statistiek sleutels.
    """
    # Format een getal als percentage. Bijvoorbeeld 0.25 wordt 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # Om te voorkomen dat het meerdere keren wordt berekend
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # De dropna() is een oplossing voor https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogram
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Hoewel dit codefragment groot en complex lijkt, is het in feite heel eenvoudig te begrijpen. Het gaat erom dat er in de bibliotheekcode een functie aanwezig is die de types van variabelen bepaalt. Wanneer de bibliotheek een numerieke variabele tegenkomt, zal de hierboven genoemde functie de statistieken vinden die we hebben besproken. In deze functie worden de standaard pandas operaties voor objecten van het type Series, zoals series.mean(). De resultaten van de berekeningen worden opgeslagen in een woordenboek stats. Histogrammen worden gegenereerd met behulp van een aangepaste versie van de functie matplotlib.pyplot.hist. De aanpassing is erop gericht dat de functie kan werken met verschillende soorten datasets.
Correlatie-indicatoren en monster van de onderzochte gegevens
Na de analyse van de variabelen zal pandas-profiling in de sectie Correlaties de Pearson- en Spearman-correlatiematrices tonen.
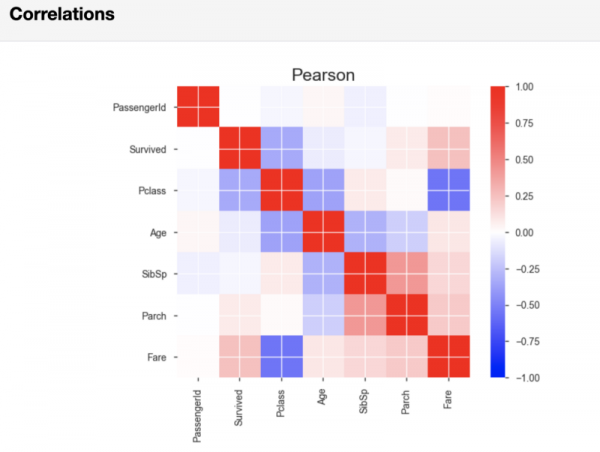
Pearson-correlatiematrix
Indien nodig, kunt u in die regel code die het rapport genereert, drempelwaarden instellen die worden toegepast bij de berekening van de correlatie. Hiermee kunt u aangeven welke sterkte van correlatie als belangrijk wordt beschouwd voor uw analyse.
Ten slotte toont het pandas-profiling rapport, in de sectie Monster, een voorbeeld van gegevens genomen uit het begin van de dataset. Deze aanpak kan leiden tot onaangename verrassingen, aangezien de eerste paar observaties een deelverzameling kunnen zijn die niet de kenmerken van de volledige dataset weerspiegelt.
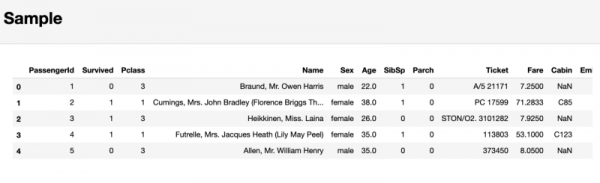
Sectie met een monster van de onderzochte gegevens
Daarom raad ik aan om niet veel aandacht aan deze laatste sectie te besteden. Het is beter om de opdracht df.sample(5), die willekeurig 5 observaties uit de dataset selecteert, te gebruiken.
Conclusies
Samenvattend kan worden opgemerkt dat de pandas-profiling bibliotheek analisten enkele nuttige mogelijkheden biedt die van pas komen wanneer snel een algemeen overzicht van de gegevens moet worden verkregen of wanneer een rapport over verkennende gegevensanalyse aan iemand anders moet worden overgedragen. In dit geval wordt het echte werk met gegevens, rekening houdend met hun kenmerken, zoals voorheen handmatig uitgevoerd en zonder het gebruik van pandas-profiling.
Als u wilt zien hoe een volledige verkennende gegevensanalyse eruitziet in één Jupyter-notebook, kijk dan naar mijn project gemaakt met behulp van nbviewer. En in de GitHub-repository kunt u de bijbehorende code vinden.
Geachte lezers! Waar begin je met het analyseren van nieuwe datasets?
Bron: habr.com
