

Às vezes, para resolver um problema, é preciso apenas olhá-lo de uma nova perspectiva. Mesmo que, nos últimos 10 anos, problemas semelhantes tenham sido resolvidos da mesma forma com efeitos diferentes, não é certo que esse modo seja o único.
Há uma questão chamada de evasão de clientes. É um fenômeno inevitável, pois clientes de qualquer empresa podem, por várias razões, parar de utilizar seus produtos ou serviços. Naturalmente, para a empresa, a evasão é uma ação não desejada, embora natural, e todos tentam minimizá-la. Melhor ainda seria prever a probabilidade de evasão de certas categorias de usuários ou de um usuário específico, e propor algumas ações para retenção.
Analisar e tentar reter o cliente, se possível, é necessário, pelo menos, pelas seguintes razões:
- a aquisição de novos clientes é mais cara do que os procedimentos de retenção.. Para atrair novos clientes, geralmente, é necessário gastar um certo valor (publicidade), enquanto os clientes existentes podem ser ativados com uma oferta especial com condições diferenciadas;
- entender as razões pela qual os clientes saem é a chave para melhorar produtos e serviços..
Existem abordagens padrão para prever a evasão. Mas, em um dos campeonatos de IA, decidimos experimentar a distribuição de Weibull para isso. Ela é utilizada principalmente para análise de sobrevivência, previsão do tempo, análise de desastres naturais, engenharia industrial e afins. A distribuição de Weibull é uma função de distribuição especial, parametrizada por dois parâmetros.  e
 .
Wikipedia
De modo geral, é um assunto interessante, mas que para prever a evasão, e também no fintech, não é utilizado com frequência. Vamos explicar a seguir como nós (Laboratório de Análise de Dados Inteligentes) fizemos isso, conquistando ao mesmo tempo uma medalha de ouro no Campeonato de Inteligência Artificial na categoria "IA nos Bancos".
Sobre a evasão em geral
Vamos esclarecer um pouco o que é a rotatividade de clientes e por que ela é tão importante. Para os negócios, a base de clientes é fundamental. Essa base é composta por novos clientes que chegam, por exemplo, após conhecer um produto ou serviço através de publicidade, usam os produtos por um tempo e, após um período, param de usá-los. Esse período é chamado de "Ciclo de Vida do Cliente" (em inglês, Customer Lifecycle) — um termo que descreve as etapas que um cliente atravessa ao conhecer um produto, decidir pela compra, pagar, usar e se tornar um consumidor fiel, e, finalmente, parar de usar os produtos por razões diversas. Assim, a rotatividade é a última etapa do ciclo de vida do cliente, quando ele deixa de usar os serviços, o que significa para os negócios que o cliente deixou de gerar lucro e qualquer benefício.
Cada cliente do banco é uma pessoa específica que escolhe um cartão bancário de acordo com suas necessidades. Viaja muito — precisará de um cartão com milhas. Faz muitas compras — olá, cartão com cashback. Compra bastante em lojas específicas — e para isso já existe um plástico parceiro. Claro, às vezes o cartão é escolhido com base no critério "Menores taxas de manutenção". No geral, há muitas variáveis aqui.
Além disso, a pessoa escolhe o próprio banco — qual é o sentido de escolher um cartão de um banco que só tem agências em Moscovo e arredores, quando você está em Khabarovsk? Mesmo que o cartão desse banco seja duas vezes mais vantajoso, a proximidade das agências ainda é um critério importante. Sim, já estamos em 2019 e o digital é tudo para nós, mas alguns problemas em certos bancos só podem ser resolvidos em uma agência. Além disso, uma parte da população confia muito mais em um banco físico do que em um aplicativo no smartphone, e isso também deve ser levado em consideração.
Como consequência, as razões para deixar de usar os produtos de um banco (ou mesmo o banco em si) podem ser muitas. Mudou de emprego, e a tarifa do cartão mudou de um plano de salário para "Para simples mortais", que é menos vantajosa. Mudou-se para outra cidade onde não há agências do banco. Não gostou do atendimento de um operador pouco qualificado na agência. Ou seja, as razões para encerrar uma conta podem ser muito mais numerosas do que para usar o produto.
Além disso, o cliente pode não apenas expressar claramente sua intenção — ir ao banco e escrever um pedido, mas simplesmente parar de usar os produtos, sem rescindir o contrato. Foi para entender tarefas como essa que decidimos usar aprendizado de máquina e IA.
Além disso, a perda de clientes pode ocorrer em qualquer setor (telecomunicações, provedores de internet, companhias de seguros, em resumo, em qualquer lugar onde exista uma base de clientes e transações periódicas).
O que fizemos
Primeiramente, foi necessário descrever uma fronteira clara — a partir de quando começamos a considerar um cliente como perdido. Do ponto de vista do banco que nos forneceu os dados para trabalhar, o estado de atividade do cliente era binário — ele ou está ativo ou não. Havia um sinal ACTIVE_FLAG na tabela 'Atividade', cujo valor poderia ser '0' ou '1' (respectivamente, 'Inativo' e 'Ativo'). Tudo estaria bem, mas uma pessoa pode, por algum tempo, usar ativamente, e então ficar inativa por um mês — ficou doente, viajou para o exterior para descansar ou até mesmo foi testar o cartão de outro banco. E pode, após um longo período de inatividade, começar a usar novamente os serviços do banco.
Portanto, decidimos definir o período de inatividade como um intervalo contínuo de tempo durante o qual o sinal para ele era definido como '0'.
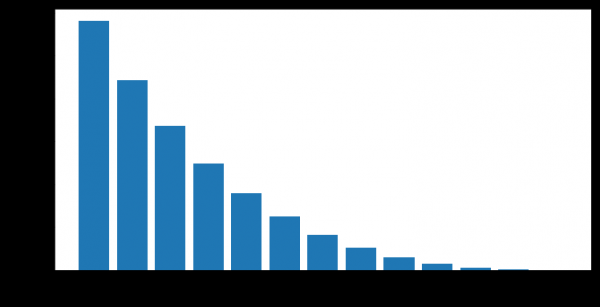
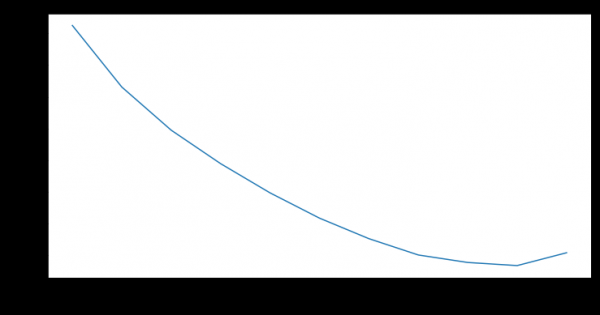
Os clientes transitam de inativos para ativos após períodos de inatividade de diferentes durações. Temos a oportunidade de calcular o grau da variável empírica 'confiabilidade dos períodos de inatividade' — ou seja, a probabilidade de que a pessoa volte a usar os produtos do banco após um período temporário de inatividade.
Por exemplo, neste gráfico está exibida a retomada da atividade (ACTIVE_FLAG=1) dos clientes após alguns meses de inatividade (ACTIVE_FLAG=0).
Aqui, vamos esclarecer um pouco o conjunto de dados com o qual começamos a trabalhar. Assim, o banco forneceu informações agregadas por 19 meses nas seguintes tabelas:
- 'Atividade' — transações mensais dos clientes (por cartão, no banco online e no banco móvel), incluindo pagamentos de salários e informações sobre os volumes de transações.
- 'Cartões' — dados sobre todos os cartões que o cliente possui, com uma grade tarifária detalhada.
- «Contratos» — informações sobre os contratos do cliente (tanto abertos quanto fechados): empréstimos, depósitos e outros, com especificação dos parâmetros de cada um.
- «Clientes» — conjunto de dados demográficos (sexo e idade) e disponibilidade de dados de contato.
Precisávamos de todas as tabelas, exceto a «Cartões».
O desafio aqui estava no fato de que nesses dados o banco não indicava qual atividade havia ocorrido em relação aos cartões. Ou seja, podíamos entender se houve transações ou não, mas já não podíamos determinar o tipo delas. Portanto, não era claro se o cliente retirava dinheiro, recebia salário ou gastava em compras. Além disso, não tínhamos dados sobre os saldos das contas, o que seria útil.
A amostra em si não foi enviesada — nesse corte, durante 19 meses, o banco não fez nenhuma tentativa de retenção de clientes ou minimização da saída.
Então, sobre os períodos de inatividade.
Para formular uma definição de saída, é necessário escolher um período de inatividade. Para criar uma previsão de saída em um determinado momento  , é necessário ter um histórico de clientes de pelo menos 3 meses no intervalo
 . O histórico que temos foi limitado a 19 meses, portanto decidimos considerar o período de inatividade de 6 meses, se existisse. E para o período mínimo de previsão de qualidade, adotamos 3 meses. Os números de 3 e 6 meses foram escolhidos empiricamente com base na análise do comportamento desses clientes.
Definimos a saída da seguinte forma: o mês de saída do cliente  é o primeiro mês com ACTIVE_FLAG=0, onde a partir desse mês há pelo menos seis zeros consecutivos no campo ACTIVE_FLAG, em outras palavras, é o mês em que o cliente ficou 6 meses inativo.
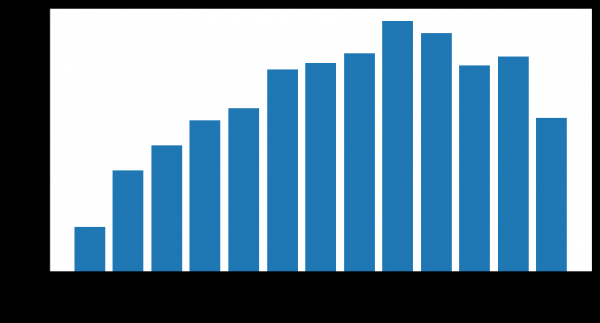
Número de clientes que saíram
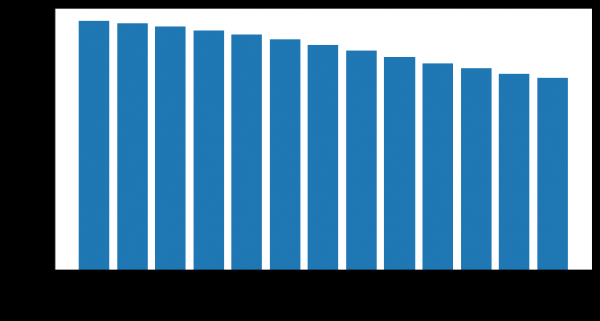
Número de clientes que permaneceram
Como é comum considerar a saída
Em competições desse tipo, e na prática em geral, a saída é frequentemente prevista desta forma. O cliente utiliza produtos e serviços em diferentes períodos, e os dados de interação com ele são apresentados na forma de vetor de características de comprimento fixo n. Com frequência, essas informações incluem:
- Dados característicos do usuário (dados demográficos, segmento de marketing).
- Histórico de uso de produtos e serviços bancários (são ações dos clientes que sempre estão vinculadas a um momento específico ou período do intervalo que nos interessa).
- Dados externos, se disponíveis — por exemplo, avaliações de redes sociais.
E somente depois disso, apresentam a definição de churn, específica para cada tarefa. Em seguida, utilizam um algoritmo de aprendizado de máquina que prevê a probabilidade de um cliente sair.  com base em um vetor de fatores.
 Para treinar o algoritmo, utiliza-se um dos conhecidos frameworks para construção de ensembles de árvores de decisão, , , ou suas modificações.
O algoritmo em si não é ruim, mas possui algumas desvantagens sérias em termos de previsão de churn.
- Ele não possui a chamada "memória".A entrada do modelo consiste em um número especificado de características que correspondem ao momento atual. Para incorporar informações sobre a história das mudanças nos parâmetros, é necessário calcular características específicas que caracterizam as mudanças ao longo do tempo, como o número ou a soma das transações bancárias nos últimos 1, 2 ou 3 meses. Essa abordagem pode apenas refletir parte da natureza das mudanças ao longo do tempo.
- Horizonte fixo de previsão. O modelo é capaz de prever o churn de clientes apenas para um período de tempo previamente definido, por exemplo, uma previsão para um mês à frente. Se for necessário uma previsão para outro intervalo de tempo, como três meses, é preciso reconstruir o conjunto de treinamento e treinar um novo modelo.
Nossa abordagem
Decidimos imediatamente que não utilizaríamos abordagens padrão. No campeonato, além de nós, 497 pessoas se inscreveram, cada uma com uma experiência considerável. Portanto, tentar fazer algo segundo o esquema padrão nessas condições não é a melhor ideia.
E começamos a resolver os problemas enfrentados pelo modelo de classificação binária, utilizando a previsão da distribuição probabilística do tempo de churn dos clientes. Essa abordagem pode ser vista , pois permite prever o churn de forma mais flexível e testar hipóteses mais complexas do que na abordagem clássica. Para a família de distribuições que modela o tempo de churn, escolhemos a distribuição devido à sua ampla aplicação na análise de sobrevivência. O comportamento do cliente pode ser considerado uma forma de sobrevivência.
Aqui estão exemplos de distribuições de densidades de probabilidade de Weibull, dependendo dos parâmetros.  e
 :
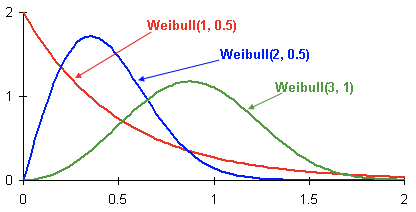
Esta é a densidade de distribuição de probabilidade da saída de três diferentes clientes ao longo do tempo. O tempo é representado em meses. Em outras palavras, este gráfico mostra quando é mais provável que ocorra a saída de clientes nos próximos dois meses. Como pode ser visto, o cliente com a distribuição possui um maior potencial de sair mais cedo do que os clientes com distribuições Weibull(2, 0.5) e Weibull(3,1).
Como resultado, obtemos um modelo que, para cada cliente, prevê para qualquer
mês os parâmetros da distribuição de Weibull que melhor refletem a probabilidade de saída ao longo do tempo. Em mais detalhes:
- As características-alvo no conjunto de treinamento são o tempo restante até a saída no mês específico para o cliente específico.
- Se o indicador de saída para o cliente não estiver disponível, supomos que o tempo de saída é maior do que o número de meses desde o atual até o final do histórico que temos.
- Modelo utilizado: rede neural recorrente com camada LSTM.
- Como função de perda, utilizamos a função de verossimilhança logarítmica negativa para a distribuição de Weibull.
Aqui estão as vantagens de tal método:
- A distribuição probabilística, além da possibilidade óbvia de classificação binária, permite prever flexivelmente diferentes eventos, por exemplo, se um cliente deixará de usar os serviços do banco em 3 meses. Também, se necessário, diversas métricas podem ser média com base nessa distribuição.
- A rede neural recorrente LSTM possui memória e utiliza de forma eficaz todo o histórico disponível. Com a ampliação ou refinamento do histórico, a precisão aumenta.
- A abordagem pode ser facilmente escalada ao dividir os períodos de tempo em intervalos menores (por exemplo, ao dividir meses em semanas).
Mas não basta criar um bom modelo, é necessário também avaliar corretamente sua qualidade.
Como avaliamos a qualidade
Como métrica, escolhemos a Lift Curve. Ela é usada em negócios para tais casos devido à sua interpretação clara, sendo bem descrita. e . Para resumir o significado dessa métrica em uma frase, é "Em quantas vezes o algoritmo faz uma previsão melhor nos primeiros  % do que aleatoriamente".
Treinamos os modelos.
As condições da competição não estabeleciam uma métrica específica de qualidade pela qual diferentes modelos e abordagens pudessem ser comparados. Além disso, a definição do conceito de churn pode variar e depender da formulação da tarefa, que, por sua vez, é definida pelos objetivos de negócio. Portanto, para entender qual método é melhor, treinamos dois modelos:
- Uma abordagem comumente utilizada de classificação binária usando o algoritmo de machine learning de ensemble de árvores de decisão ();
- Modelo Weibull-LSTM
A amostra de teste consistiu em 500 clientes previamente selecionados, que não estavam na amostra de treinamento. Para o modelo, foram ajustados hiperparâmetros utilizando validação cruzada segmentada por cliente. Para o treinamento de cada modelo, foram utilizados conjuntos de características idênticos.
Devido ao fato de que o modelo não possui memória, foram utilizados recursos especiais que mostram a relação da alteração dos parâmetros de um mês em relação à média dos parâmetros dos últimos três meses. Isso caracteriza a velocidade das alterações dos valores no último período de três meses. Sem isso, o modelo baseado em Random Forest estaria em desvantagem em relação ao Weibull-LSTM.
Por que o LSTM com distribuição Weibull é melhor do que a abordagem baseada em ensemble de árvores de decisão
Aqui estão tudo explicado de forma clara com apenas algumas imagens.
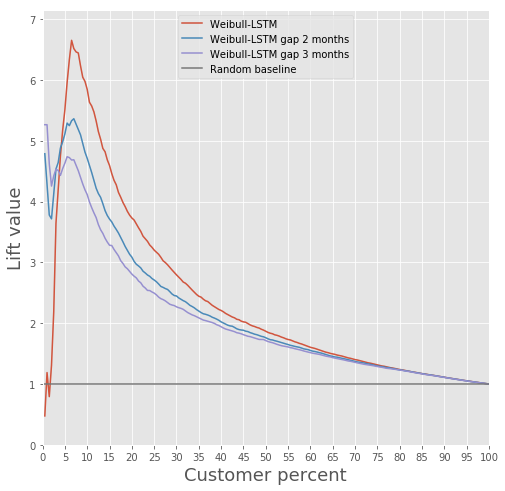
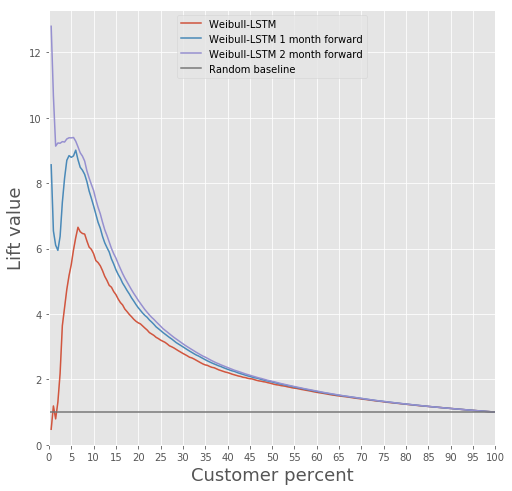
Comparação da Lift Curve para o algoritmo clássico e Weibull-LSTM
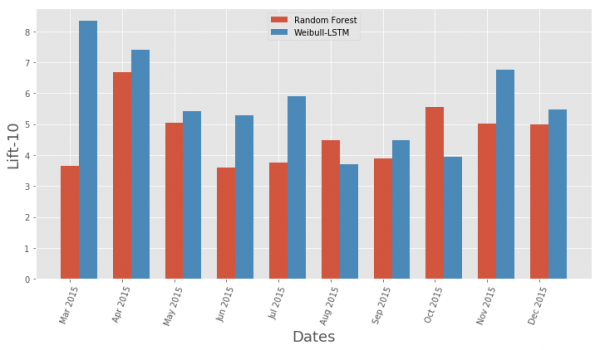
Comparação da métrica Lift Curve mês a mês para o algoritmo clássico e Weibull-LSTM
No geral, o LSTM supera o algoritmo clássico em quase todos os casos.
Previsão de churn
O modelo baseado em uma rede neural recorrente com células LSTM com distribuição Weibull pode prever o churn com antecedência, como, por exemplo, prever a saída de um cliente nos próximos n meses. Vamos considerar o caso para n = 3. Nesse caso, para cada mês, a rede neural deve identificar corretamente: se o cliente sairá, começando no próximo mês e até o n-ésimo mês. Em outras palavras, ela deve determinar corretamente se o cliente permanecerá ao final de n meses. Isso pode ser considerado uma previsão antecipada: prever o momento em que o cliente começou a pensar em sair.
Vamos comparar a Lift Curve para Weibull-LSTM 1, 2 e 3 meses antes do churn:
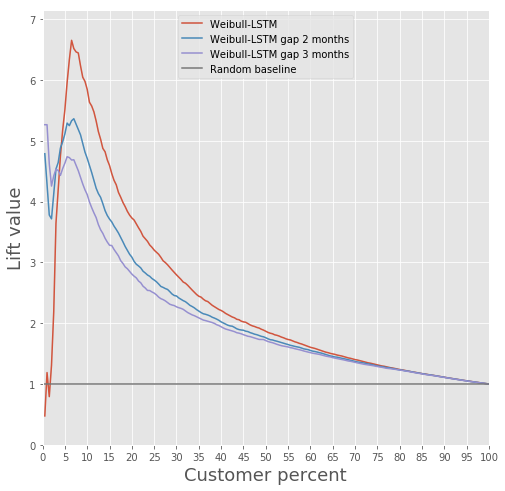
Já mencionamos anteriormente que as previsões para os clientes que ficam inativos por um tempo também são importantes. Portanto, adicionaremos à amostra casos em que um cliente que saiu já estava inativo há um ou dois meses e verificaremos se o Weibull-LSTM classifica corretamente esses casos como cancelamento. Como esses casos estavam na amostra, esperamos que a rede consiga lidar bem com eles:
Retenção de clientes
Na verdade, essa é a principal ação que podemos tomar, tendo em mãos informações sobre clientes que estão prestes a parar de usar o produto. Ao falar sobre a construção de um modelo que possa oferecer algo útil aos clientes para mantê-los — isso não será possível se você não tiver um histórico de tentativas semelhantes que terminaram bem.
Nós não tínhamos esse histórico, então decidimos fazer assim.
- Construindo um modelo que determina produtos interessantes para cada cliente.
- A cada mês, executamos o classificador e identificamos clientes potencialmente em fase de cancelamento.
- Oferecemos a parte dos clientes um produto, conforme o modelo da etapa 1, e registramos nossas ações.
- Após alguns meses, observamos quem entre esses clientes em potencial saiu e quem ficou. Dessa forma, formamos um conjunto de dados para treinamento.
- Treinamos o modelo com os dados obtidos na etapa 4.
- Opcionalmente, repetimos o procedimento, substituindo o modelo da etapa 1 pelo modelo obtido na etapa 5.
Uma verificação da qualidade dessa retenção pode ser feita por meio de um teste A/B comum — dividimos os clientes que estão prestes a sair em dois grupos. Para um grupo, oferecemos produtos com base no nosso modelo de retenção; para o outro, não oferecemos nada. Decidimos treinar um modelo que poderia ser útil já na etapa 1 do nosso exemplo.
Queríamos tornar a segmentação o mais interpretável possível. Para isso, escolhemos algumas características que pudessem ser facilmente interpretadas: número total de transações, salário, volume total na conta, idade, gênero. Características da tabela "Cartões" não foram consideradas devido à baixa informatividade, e as características da tabela 3 "Contratos" foram descartadas devido à complexidade do processamento, a fim de evitar vazamento de dados entre o conjunto de validação e o conjunto de treinamento.
A clusterização foi realizada usando modelos de mistura gaussiana. O critério de informação de Akaike permitiu determinar 2 ótimos. O primeiro ótimo corresponde a 1 cluster. O segundo ótimo, menos acentuado, corresponde a 80 clusters. Com este resultado, pode-se concluir que é extremamente difícil dividir os dados em clusters sem informações apriorísticas. Para uma clusterização de melhor qualidade, são necessários dados que descrevam detalhadamente cada cliente.
Portanto, foi considerada a tarefa de aprendizado supervisionado, a fim de oferecer a cada cliente um produto específico. Foram considerados os seguintes produtos: ‘Depósito a prazo’, ‘Cartão de crédito’, ‘Descoberto’, ‘Empréstimo pessoal’, ‘Empréstimo para veículos’, ‘Hipoteca’.
Os dados também continham outro tipo de produto: ‘Conta corrente’. Mas não o consideramos devido à sua baixa informatividade. Para usuários que são clientes do banco, ou seja, que não deixaram de usar seus produtos, um modelo foi construído para prever qual produto poderia ser de seu interesse. A regressão logística foi escolhida como modelo e o Lift para os primeiros 10 percentis foi utilizado como métrica de avaliação da qualidade.
A qualidade do modelo pode ser avaliada na figura.
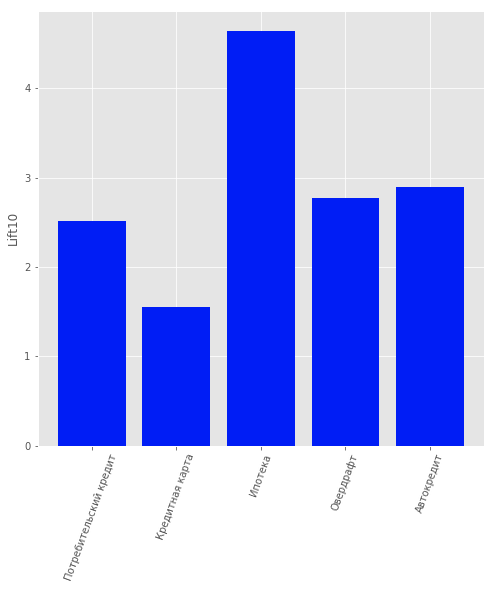
Resultados do modelo de recomendação de produtos para clientes
Resultado
Esta abordagem nos trouxe o primeiro lugar na categoria ‘IA nos bancos’ no Campeonato de IA RAIF-Challenge 2017.
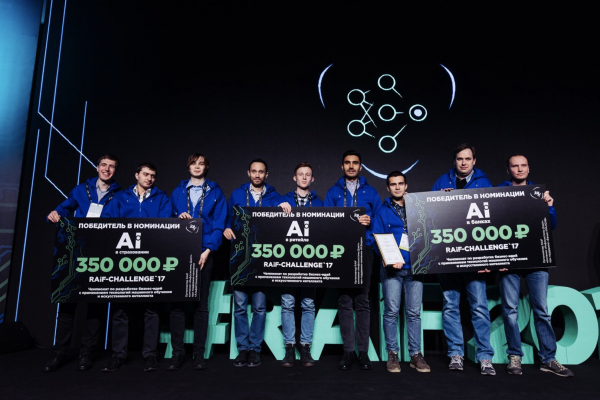
Aparentemente, o mais importante foi realmente abordar o problema de uma forma não muito convencional e usar um método geralmente aplicado a outras situações.
Embora a saída em massa de usuários possa, de fato, ser um desastre natural para os serviços.
Esse método pode ser aplicado a qualquer outra área em que a rotatividade seja importante, não apenas nos bancos. Por exemplo, nós o utilizamos para calcular nossa própria rotatividade — nas filiais da Rostelecom em Sibéria e São Petersburgo.
‘Laboratório de Análise Inteligente de Dados’ da empresa ‘Portal de Pesquisa Sputnik’
Fonte: habr.com
