

Într-unul din chat-uri, mi s-a pus o întrebare:
— Există ceva de citit despre cum să împachetăm corect serverele în rack-uri?
Am realizat că nu cunosc un astfel de text, așa că mi-am scris propriul.
În primul rând, acest text se referă la servere fizice în centre de date fizice (DC). În al doilea rând, să presupunem că există o mulțime de servere: sute sau mii, pentru un număr mai mic, acest text nu are sens. În al treilea rând, să considerăm că avem trei restricții: spațiul fizic în rack-uri, alimentarea electrică pe rack și să presupunem că rack-urile sunt aranjate în rânduri, astfel încât putem folosi un switch ToR pentru a conecta serverele din rack-urile adiacente.
Răspunsul la întrebare depinde foarte mult de ce parametru optimizăm și ce putem varia pentru a obține cel mai bun rezultat. De exemplu, poate că trebuie să ocupăm minim spațiu, pentru a lăsa mai mult loc pentru creștere ulterioară. Sau poate avem libertate în alegerea înălțimii rack-urilor, puterii pe rack, prizei în PDU, numărului de rack-uri din grupul de switch-uri (un switch pe 1, 2 sau 3 rack-uri), lungimii cablurilor și lucrărilor de instalare (acest lucru este critic la capetele rândurilor: la 10 rack-uri într-un rând și 3 rack-uri pe switch, va trebui să tragem cabluri în alt rând sau să nu utilizăm porturile din switch), etc., etc. Părți separate: alegerea serverelor și alegerea DC-ului, vom presupune că acestea au fost deja alese.
Ar fi bine să înțelegem anumite nuanțe și detalii, în special consumul mediu/maxim al serverelor și modul în care ne este furnizată electricitatea. De exemplu, dacă avem alimentare de 230V din Rusia și o fază pe rack, atunci un automat de 32A poate suporta ~7kW. Să presupunem că plătim nominal pentru 6kW pe rack. Dacă furnizorul măsoară consumul nostru doar pentru o serie de 10 rack-uri, nu pentru fiecare rack în parte, și dacă automatul este setat la o limită de 7kW, tehnic putem consuma 6.9kW într-un rack, 5.1kW în altul și totul va fi în regulă — fără penalizări.
De obicei, obiectivul nostru principal este minimizarea costurilor. Cel mai bun criteriu pentru măsurare este reducerea TCO (total cost of ownership — costul total de proprietate). Aceasta constă în următoarele componente:
- CAPEX: achiziționarea infrastructurii DC, serverelor, echipamentelor de rețea și cablurilor
- OPEX: închirierea DC-ului, electricitatea consumată, întreținerea. OPEX depinde de durata de viață. Este rezonabil să presupunem că este egal cu 3 ani.
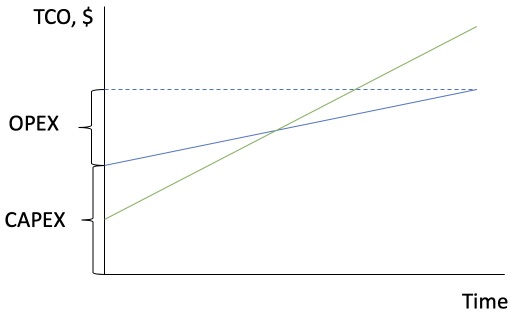
În funcție de dimensiunea fiecărei părți din tortul general, trebuie să optimizăm cel mai costisitor element, iar restul să utilizeze toate resursele rămase cât mai eficient posibil.
Să presupunem că avem un centru de date existent, avem înălțimea rack-ului H unități (de exemplu, H=47), energia pe rack Prack (Prack=6kW), și am decis să folosim servere de 2U h=2U. Vom elimina 2..4 unități din rack pentru switch-uri, patch panel-uri și organizatoare. Adică, fizic, în rack avem Sh=rounddown((H-2..4)/h) servere (adică, Sh = rounddown((47-4)/2)=21 servere pe rack). Să reținem acest Sh.
În cazul simplu, toate serverele din rack sunt identice. Așadar, dacă umplem rack-ul servers, atunci pentru fiecare server ne putem permite în medie puterea Pserv=Prack/Sh (Pserv = 6000W/21 = 287W). Pentru simplitate, aici ignorăm consumul switch-ului.
Să facem un pas înapoi și să stabilim ce este consumul maxim al unui server Pmax. Dacă este foarte simplu, foarte ineficient și complet sigur, atunci citim ceea ce este scris pe sursa de alimentare a serverului - acesta este.
Dacă lucrurile sunt mai complicate, mai eficiente, atunci luăm TDP (thermal design package) al tuturor componentelor și le adunăm (nu este foarte corect, dar se poate face și așa).
De obicei, nu știm TDP-ul componentelor (cu excepția CPU), așa că luăm cea mai corectă, dar și cea mai complexă abordare (necesită un laborator) - luăm un server experimental cu configurația dorită și îl încărcăm, de exemplu, cu Linpack (CPU și memorie) și fio (discuri), măsurăm consumul. Dacă vrem să facem lucrurile serios, trebuie să creăm și cel mai cald mediu în coridorul rece în timpul testelor, deoarece aceasta influențează atât consumul ventilatoarelor, cât și consumul CPU. Obținem consumul maxim al unui server specific cu o configurație specifică în aceste condiții specifice sub această sarcină specifică. Trebuie doar să reținem că un nou firmware, o altă versiune de software sau alte condiții pot influența rezultatul.
Așadar, ne întoarcem la Pserv și cum să-l comparăm cu Pmax. Aceasta este o chestiune de înțelegere a funcționării serviciilor și a cât de puternice sunt nervii directorului tehnic.
Dacă nu vrem să riscăm deloc, atunci considerăm că toate serverele pot începe simultan să consume maximul lor. În acel moment, poate exista un singur alimentare în centru de date. Infrastructura trebuie să ofere serviciul chiar și în aceste condiții, deci Pserv ≡ Pmax. Aceasta este o abordare în care fiabilitatea este absolut crucială.
Dacă directorul tehnic se gândește nu doar la securitate ideală, ci și la banii companiei și are suficient curaj, se poate decide că
- începem să gestionăm furnizorii noștri, în special interzicem întreținerea planificată în momentele de încărcare de vârf pentru a minimiza căderile unui singur intrări;
- și/sau arhitectura noastră permite pierderea unui server/rând/datacenter, iar serviciile continuă să funcționeze;
- și/sau distribuim bine încărcătura pe orizontală între servere, astfel încât serviciile noastre să nu atingă niciodată consumul maxim într-un singur server toate împreună.
Aici este foarte util să nu ne pliem doar pe estimări, ci să monitorizăm consumul și să știm cum consumă efectiv serverele energia în condiții normale și de vârf. Prin urmare, după o analiză, directorul tehnic comprimă tot ce are și spune: „printr-o decizie forțată, stabilim că media maximă realizabilă a consumului serverelor pe rack este **cu atât mai puțin** decât consumul maxim”, aproximativ Pserv=0.8*Pmax.
Și atunci, în rack-ul de 6kW nu mai încap 16 servere cu Pmax = 375W, ci 20 de servere cu Pserv = 375W * 0.8 = 300W. Adică cu 25% mai multe servere. Aceasta este o economie foarte mare — pentru că în acest fel avem cu 25% mai puține rack-uri (iar acolo vom economisi și pe PDU, switch-uri și cabluri). Un minus serios al acestei soluții este că trebuie să monitorizăm constant dacă ipotezele noastre rămân corecte. Că noua versiune de firmware nu afectează semnificativ funcționarea ventilatoarelor și consumul, că dezvoltarea nu a început, dintr-o dată cu un nou release, să utilizeze servere mult mai eficient (în alte cuvinte, au obținut o utilizare mai mare și un consum mai mare pe server). Pentru că, în acest caz, atât ipotezele noastre inițiale, cât și concluziile devin imediat greșite. Este un risc pe care trebuie să-l asumăm responsabil (sau să-l evităm și să plătim pentru rack-urile evident subutilizate).
O notă importantă – ar trebui să încercăm să distribuim serverele din diferite servicii pe rafturi, orizontal, dacă este posibil. Aceasta este necesară pentru a evita situațiile în care o partidă de servere pentru un singur serviciu ajunge și rafturile sunt umplute vertical pentru a crește „densitatea” (pentru că este mai simplu). În realitate, se întâmplă că un raft este umplut cu servere de la un singur serviciu, cu o încărcare scăzută, iar altul – cu acelea cu o încărcare mare. Probabilitatea ca al doilea să cedeze este semnificativ mai mare, deoarece profilul de încărcare este același, iar toate serverele din acel raft încep să consume la fel de mult din cauza creșterii sarcinii.
Să ne întoarcem la distribuția serverelor pe rafturi. Am examinat limitele fizice de spațiu din raft și limitele de alimentare electrică, acum să ne uităm și la rețea. Putem folosi switch-uri cu 24/32/48 porturi N (de exemplu, avem switch-uri ToR cu 48 de porturi). Din fericire, opțiunile nu sunt foarte multe, dacă nu ne gândim la cablurile break-out. Luăm în considerare scenariile în care avem un switch pe raft, un switch pentru două sau trei rafturi în grupul Rnet. Mi se pare că mai mult de trei rafturi în grup este deja prea mult, deoarece problema cablării între rafturi devine mult mai mare.
Așadar, pentru fiecare scenariu de rețea (1, 2 sau 3 rafturi în grup) distribuim serverele pe rafturi:
Srack = min(Sh, rounddown(Prack/Pserv), rounddown(N/Rnet))
Astfel, pentru varianta cu 2 rafturi în grup:
Srack2 = min(21, rounddown(6000/300), rounddown(48/2)) = min(21, 20, 24) = 20 servere pe raft.
La fel calculăm celelalte variante:
Srack1 = 20
Srack3 = 16
Și suntem aproape de obiectiv. Calculăm numărul de rafturi pentru distribuirea tuturor serverelor noastre S (să presupunem că există 1000):
R = roundup(S / (Srack * Rnet)) * Rnet
R1 = roundup(1000 / (20 * 1)) * 1 = 50 * 1 = 50 rafturi
R2 = roundup(1000 / (20 * 2)) * 2 = 25 * 2 = 50 rafturi
R3 = roundup(1000 / (16 * 3)) * 3 = 25 * 2 = 63 rafturi
Apoi calculăm TCO pentru fiecare variantă pe baza numărului de rafturi, numărul necesar de switch-uri, cabluri etc. Alegem varianta cu TCO mai mic. Profit!
Observăm că, deși numărul necesar de rafturi pentru variantele 1 și 2 este același, prețul lor va fi diferit, deoarece numărul de switch-uri pentru a doua variantă este de două ori mai mic, iar lungimea cablurilor necesare este mai mare.
P.S. Dacă este posibil să jucăm cu puterea pentru rack și înălțimea rack-ului, variabilitatea crește. Însă procesul poate fi redus la ceea ce am descris mai sus, pur și simplu explorând opțiunile. Da, vor fi mai multe combinații, dar totuși un număr destul de limitat — alimentarea rack-ului pentru calcul poate fi crescută cu un pas de 1 kW, rack-urile standard sunt disponibile în număr limitat de dimensiuni: 42U, 45U, 47U, 48U, 52U. Iar pentru calcule, analiza What-If din Excel în modul Data Table poate fi utilă. Ne uităm la tabelele obținute și alegem minimul.
Sursa: habr.com
