

Data Science pentru începători
1. Analiza Sentimentelor (Sentiment Analysis prin text)
Consultați implementarea completă a proiectului Data Science folosind codul sursă — .
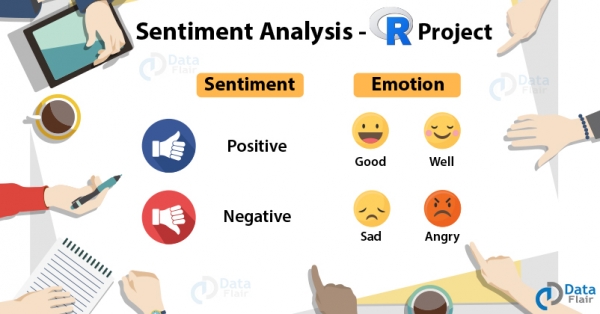
Analiza Sentimentelor — este analiza cuvintelor pentru a determina stările de spirit și opiniile, care pot fi pozitive sau negative. Acesta este un tip de clasificare, în care clasele pot fi binare (pozitive și negative) sau multiple (fericite, supărate, triste, neplăcute ...). Vom implementa acest proiect Data Science în limbajul R și vom folosi un set de date din pachetul „janeaustenR”. Vom utiliza dicționare generale, cum ar fi AFINN, bing și loughran, vom efectua o interogare internă, iar la sfârșit, vom crea un nor de cuvinte pentru a vizualiza rezultatul.
Limbaj: R
Set de date/Pachet: janeaustenR
Articolul a fost tradus cu sprijinul companiei EDISON Software, care , dar și pentru .
2. Detectarea Știrilor False (Fake News Detection)
Îmbunătățiți-vă abilitățile la un nou nivel, lucrând la un proiect Data Science pentru începători — .
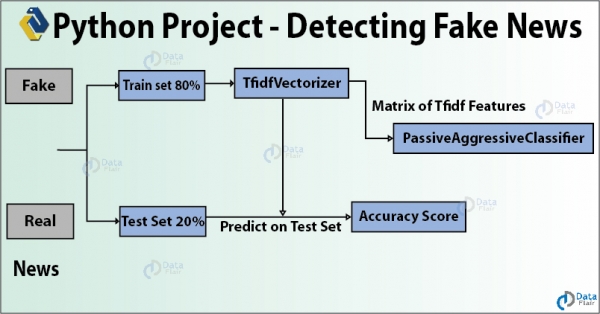
Știrile false sunt informații false, distribuite prin rețele sociale și alte mass-media online în scopuri politice. În această idee de proiect Data Science, vom folosi Python pentru a construi un model care poate determina cu exactitate dacă o știre este reală sau falsă. Vom crea TfidfVectorizer și vom folosi PassiveAggressiveClassifier pentru a clasifica știrile în „reale” și „false”. Vom folosi un set de date de 7796 × 4 și vom efectua toate operațiunile în Jupyter Lab.
Limbaj: Python
Set de date/Pachet: news.csv
3. Detectarea Bolii Parkinson (Detecting Parkinson’s Disease)
Avansați lucrând la ideea de proiect Data Science — .
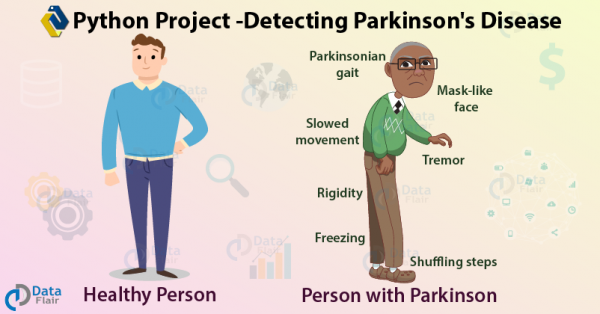
Am început să folosim Data Science pentru a îmbunătăți sănătatea și serviciile — dacă putem prezice o boală în stadii incipiente, vom avea multe avantaje. Așadar, în această idee de proiect Data Science, vom învăța să identificăm boala Parkinson folosind Python. Aceasta este o boală neurodegenerativă, progresivă a sistemului nervos central, care afectează mișcarea și provoacă tremor și rigiditate. Aceasta afectează neuronii care produc dopamină din creier, iar în fiecare an, afectează peste 1 milion de oameni în India.
Limbaj: Python
Set de date/Pachet: Setul de date UCI ML Parkinsons
Proiecte de Data Science de dificultate medie
4. Recunoașterea emoției din voce
Consultați implementarea completă a exemplului de proiect Data Science — .
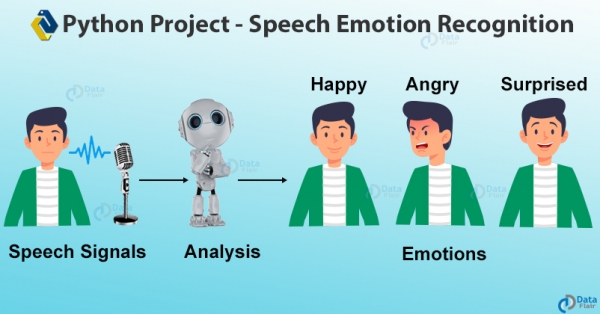
Acum să învățăm să folosim diferite biblioteci. Acest proiect Data Science utilizează librosa pentru recunoașterea vocii. SER este procesul de identificare a emoțiilor umane și a stărilor afective prin intermediul vocii. Deoarece folosim tonul și înălțimea vocală pentru a exprima emoții, SER este relevant. Dar, deoarece emoțiile sunt subiective, anotarea sunetului este o sarcină complexă. Vom folosi funcțiile mfcc, chroma și mel și vom utiliza setul de date RAVDESS pentru recunoașterea emoțiilor. Vom crea un clasificator MLPC pentru acest model.
Limbaj: Python
Set de date/Pachet: Setul de date RAVDESS
5. Detectarea genului și a vârstei
Impressionați angajatorii cu cel mai recent proiect Data Science — .
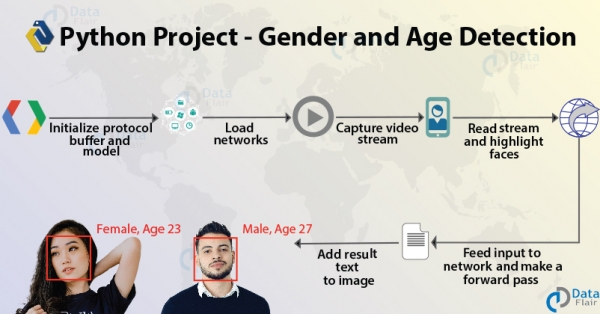
Acesta este un proiect interesant de Data Science cu Python. Folosind o singură imagine, veți învăța să preziceți genul și vârsta unei persoane. În acest proiect, vă vom prezenta viziunea computerizată și principiile sale. Vom construi și vom folosi modele antrenate de Tal Hassner și Gil Levi pentru setul de date Adience. Pe parcurs, vom folosi unele fișiere .pb, .pbtxt, .prototxt și .caffemodel.
Limbaj: Python
Set de date/Pachet: Adience
6. Analiza datelor Uber
Consultați implementarea completă a proiectului de Data Science cu codul sursă — .
Acesta este un proiect de vizualizare a datelor cu ggplot2, în care vom folosi R și bibliotecile sale pentru a analiza diferite parametrii. Vom folosi setul de date Uber Pickups din New York și vom crea vizualizări pentru diferite intervale de timp pe parcursul anului. Acesta ne arată cum timpul influențează cursele clienților.
Limbaj: R
Set de date/Pachet: Setul de date Uber Pickups în New York City
7. Detectarea somnolenței șoferului
Îmbunătățește-ți abilitățile lucrând la un Proiect De Vârf în Data Science — .
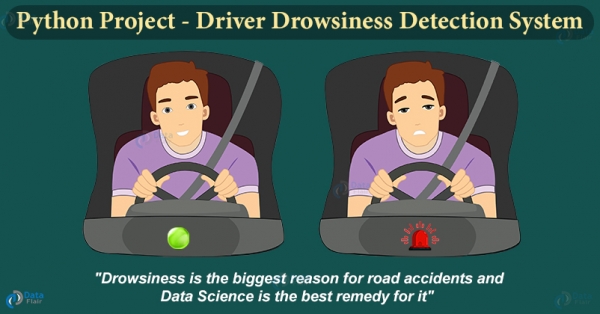
Conducerea în stare de somn este extrem de periculoasă, iar în fiecare an au loc aproximativ o mie de accidente din cauza faptului că șoferii adorm în timpul condusului. În acest proiect în Python, vom crea un sistem care poate detecta șoferii somnoroși și îi va alerta printr-un semnal sonor.
Acest proiect este realizat folosind Keras și OpenCV. Vom utiliza OpenCV pentru detectarea feței și a ochilor, iar cu ajutorul Keras vom clasifica starea ochiului (Deschis sau Închis) utilizând metode de rețea neuronală profunde.
8. Chatbot
Creează un chatbot cu Python și avansează în cariera ta — .
Chatbot-urile sunt o parte integrantă a afacerilor. Multe companii trebuie să ofere servicii clienților lor, iar pentru a le deservi este nevoie de multă forță de muncă, timp și efort. Chatbot-urile pot automatiza o mare parte a interacțiunii cu clienții, răspunzând la unele întrebări frecvente pe care le pun clienții. Există, în general, două tipuri de chatbot-uri: specifice domeniului și open-domain. Chatbot-urile specifice domeniului sunt folosite frecvent pentru a rezolva o problemă specifică. Astfel, trebuie să le configurezi pentru a funcționa eficient în domeniul tău. Chatbot-urile open-domain pot primi orice tip de întrebări, așa că pentru a le antrena este nevoie de o cantitate uriașă de date.
Set de date: Fișier JSON al intențiilor
Limbaj: Python
Proiecte avansate de Data Science
9. Generator de descrieri de imagini
Verifică implementarea completă a proiectului cu cod sursă — .
A descrie ceea ce este într-o imagine este o sarcină ușoară pentru oameni, dar pentru calculatoare, o imagine este doar un set de numere care reprezintă valoarea culorii fiecărui pixel. Aceasta este o sarcină dificilă pentru calculatoare. A înțelege ce se află în imagine și apoi a crea o descriere în limbaj natural (de exemplu, în engleză) este o altă sarcină dificilă. Acest proiect folosește metode de învățare profundă, în care implementăm o rețea neuronală convoluțională (CNN) cu o rețea neuronală recurentă (LSTM) pentru a crea un generator de descrieri de imagini.
Set de date: Flickr 8K
Limbaj: Python
Cadru: Keras
10. Detectarea fraudei cu carduri de credit
Faceți tot posibilul pentru a lucra la ideea proiectului Data Science — .
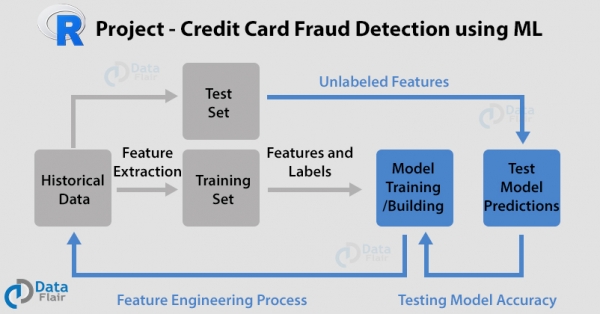
Până acum ați început să înțelegeți metodele și conceptele. Să trecem la câteva proiecte avansate în domeniul științei datelor. În acest proiect, vom utiliza limbajul R cu algoritmi precum , regresie logistică, rețele neuronale artificiale și clasificator de boostere gradient. Vom folosi un set de date cu operațiuni de carduri pentru a clasifica tranzacțiile cu carduri de credit ca fiind frauduloase sau autentice. Vom experimenta cu diferite modele și vom construi curbe de performanță.
Limbaj: R
Set de date/Pachet: Setul de date al tranzacțiilor cu carduri
11. Sistem de recomandări de filme
Explorați implementarea celui mai bun proiect Data Science cu Cod Sursă —
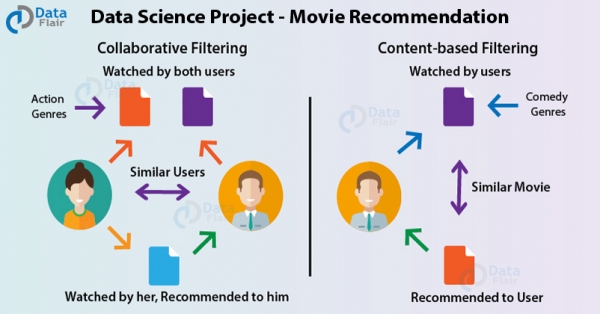
În acest proiect Data Science, vom folosi R pentru a face recomandări de filme prin învățarea automată. Sistemul de recomandări oferă sugestii utilizatorilor printr-un proces de filtrare bazat pe preferințele altor utilizatori și pe istoricul vizionărilor. Dacă lui A și lui B le place Home Alone, iar lui B îi place Mean Girls, atunci i se poate sugera lui A — cealaltă ar putea să-i placă și lui. Acest lucru permite clienților să interacționeze cu platforma.
Limbaj: R
Set de date/Pachet: Setul de date MovieLens
12. Segmentarea clienților
Impresionați angajatorii cu un proiect Data Science (inclusiv codul sursă) — .
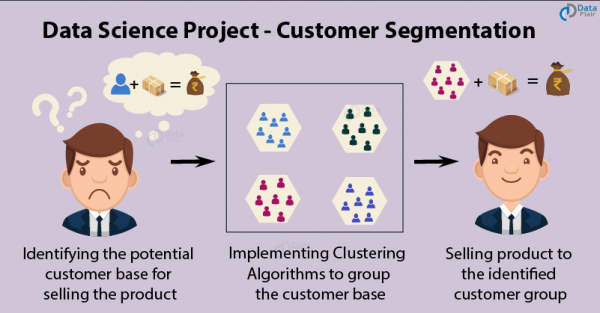
Segmentarea clienților este o aplicație populară . Folosind clusteringul, companiile identifică segmentele de clienți pentru a lucra cu potențiala bază de utilizatori. Ele împart clienții în grupuri în funcție de caracteristici comune, cum ar fi sexul, vârsta, interesele și obiceiurile de cheltuire, pentru a putea vinde eficient produsele fiecărei grupuri. Vom folosi , precum și vom vizualiza distribuția pe sexe și vârstă. Ulterior, vom analiza veniturile anuale și nivelul cheltuielilor acestora.
Limbaj: R
Set de date/Pachet: Setul de date Mall_Customers
13. Clasificarea cancerului mamar
Vizionați implementarea completă a proiectului Data Science în Python — .
Revenind la contribuția științei datelor în medicină, să învățăm cum să detectăm cancerul de sân folosind Python. Vom folosi setul de date IDC_regular pentru a identifica carcinomul invaziv ductal, cea mai frecventă formă de cancer de sân. Acesta se dezvoltă în canalele mamare, pătrunzând în țesutul fibros sau adipos din exteriorul canalului. În această idee de proiect științific de colectare de date, vom folosi și biblioteca Keras pentru clasificare.
Limbaj: Python
Set de date/Pachet: IDC_regular
14. Recunoașterea semnelor de circulație
Atingerea acurateței în tehnologia mașinilor autonome folosind un proiect Data Science pentru open-source.
Semnele de circulație și regulile de circulație sunt foarte importante pentru fiecare șofer, pentru a evita accidentele. Pentru a respecta regulile, mai întâi trebuie să înțelegem cum arată un semn de circulație. O persoană trebuie să învețe toate semnele de circulație înainte de a primi permisul de conducere pentru orice vehicul. Dar în prezent, numărul vehiculelor autonome crește, iar în viitorul apropiat, oamenii nu vor mai conduce singuri mașinile. În proiectul 'Recunoașterea semnelor de circulație', veți învăța cum un program poate recunoaște tipul semnelor de circulație, luând o imagine ca semnal de intrare. Setul de date de control pentru recunoașterea semnelor de circulație din Germania (GTSRB) este folosit pentru a construi o rețea neurală profundă pentru a recunoaște clasa din care face parte semnul de circulație. De asemenea, creăm o interfață grafică simplă pentru a interacționa cu aplicația.
Limbaj: Python
Set de date: GTSRB (Benchmark-ul german pentru recunoașterea semnelor de circulație)
Citește mai mult
Sursa: habr.com
