

Pe 9 ianuarie a avut loc lansarea Pandas 1.0.0rc. Versiunea anterioară a bibliotecii este 0.25.
Prima versiune majoră conține o mulțime de noutăți uimitoare, inclusiv îmbunătățirea sumării automate a DataFrame-urilor, mai multe formate de ieșire, tipuri noi de date și chiar un nou site pentru documentație.
Toate modificările pot fi vizualizate , în acest articol ne vom limita la o mică privire de ansamblu mai puțin tehnică a celor mai importante aspecte.
Biblioteca poate fi instalată, ca de obicei, folosind pip, dar având în vedere că la momentul scrierii acestui articol Pandas 1.0 este încă release candidate, va fi necesar să specificați explicit versiunea:
pip install --upgrade pandas==1.0.0rc0Aveți grijă: deoarece este o lansare majoră, actualizarea ar putea să rupă codul vechi!
Apropo, din această versiune suportul pentru Python 2 a fost complet eliminat (ceea ce poate fi un motiv bun — nt. trad.). Pandas 1.0 necesită minimum Python 3.6+, deci, dacă nu sunteți sigur, verificați ce versiune aveți instalată:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Este cel mai simplu să verificați versiunea Pandas astfel:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Îmbunătățirea sumării automate cu DataFrame.info
Noua mea caracteristică preferată a fost actualizarea metodei DataFrame.info. Funcția a devenit mult mai ușor de citit, ceea ce face procesul de explorare a datelor și mai simplu:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Exportarea tabelelor în format Markdown
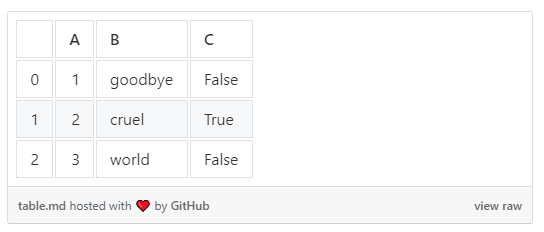
O caracteristica la fel de plăcută a fost posibilitatea de a exporta DataFrame-urile în tabele Markdown cu ajutorul DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Acest lucru simplifică mult publicarea tabelelor pe site-uri de tip Medium utilizând gisturi Github.
Tipuri noi pentru șiruri și valori logice
În lansarea Pandas 1.0 au fost adăugate și noi experimentele tipuri. API-ul lor ar putea încă să se schimbe, așa că folosiți-le cu prudență. Dar, în general, Pandas recomandă utilizarea noilor tipuri oriunde are sens.
Până acum, conversia trebuie efectuată explicit:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Observați cum coloana Dtype afişează noile tipuri — string și bool.
Cea mai utilă caracteristică a noului tip de string este posibilitatea de a selecta doar coloanele de tip string din data frame-uri. Aceasta poate simplifica semnificativ analiza datelor textuale:
df.select_dtypes("string")Anterior, coloanele de tip string nu puteau fi selectate fără a specifica explicit numele.
Mai multe informații despre noile tipuri pot fi găsite .
Vă mulțumim că ați citit! Lista completă a modificărilor, așa cum a fost menționat, poate fi consultată .
Sursa: habr.com
