

Vă propun să consultați transcrierea prezentării lui Alexei Lesovschi de la Data Egret "Fundamentele monitorizării PostgreSQL"
În această prezentare, Alexei Lesovschi va vorbi despre principalele aspecte ale statisticilor PostgreSQL, despre ce înseamnă acestea și de ce trebuie să fie prezente în monitorizare; despre ce grafice ar trebui să existe în monitorizare, cum să le adăugați și cum să le interpretați. Prezentarea va fi utilă administratorilor de baze de date, administratorilor de sistem și dezvoltatorilor interesați de depanarea PostgreSQL.
Mă numesc Alexei Lesovschi, reprezint compania Data Egret.
Câteva cuvinte despre mine. Am început cândva, demult, ca administrator de sistem.
Am administrat diverse Linux, m-am ocupat de diferite lucruri legate de Linux, adică virtualizare, monitorizare, am lucrat cu proxy-uri etc. Dar, la un moment dat, am început să mă ocup mai mult de baze de date, PostgreSQL. Mi-a plăcut foarte mult. Și, la un moment dat, am început să dedic cea mai mare parte a timpului meu de lucru PostgreSQL. Și astfel, treptat, am devenit DBA PostgreSQL.
Și pe parcursul întregii mele cariere, am fost mereu interesat de temele statisticii, monitorizării și captării telemetriei. Iar când eram administrator de sistem, m-am ocupat foarte mult de Zabbix. Și am scris un set mic de scripturi sub numele de . A fost destul de popular la vremea sa. Și acolo puteai monitoriza diverse lucruri importante, nu doar Linux, ci și diferite componente.
Acum mă ocup de PostgreSQL. Scriu acum altceva, care permite lucrul cu statisticile PostgreSQL. Se numește (articol pe Habr — ).
O scurtă introducere. Ce tipuri de situații întâmpină clienții noștri? Poate surveni o avarie legată de baza de date. Și când baza de date este restaurată, managerul de departament sau managerul de dezvoltare spune: „Dragilor, ar trebui să monitorizăm baza de date, pentru că s-a întâmplat ceva rău și trebuie să ne asigurăm că așa ceva nu se va mai întâmpla în viitor.” Și aici începe un proces interesant de alegere a sistemului de monitorizare sau de adaptare a sistemului de monitorizare existent, pentru a putea monitoriza baza de date – PostgreSQL, MySQL sau alte tipuri. Colegii încep să propună: „Am auzit că există o astfel de bază de date. Să o folosim.” Colegii încep să discute între ei. Și, în final, alegem o bază de date, dar monitorizarea PostgreSQL în aceasta este destul de slab reprezentată, iar tot timpul trebuie să facem ajustări. Să luăm diferite repozitorii de pe GitHub, să le clonăm, să adaptăm scripturile, să le configurăm. Și în final, asta se transformă într-o muncă manuală.
De aceea, în această prezentare, voi încerca să vă ofer câteva cunoștințe despre cum să alegeți monitorizarea nu doar pentru PostgreSQL, ci și pentru baze de date. Și să ofer informațiile care vă vor permite să îmbunătățiți monitorizarea, astfel încât să obțineți un beneficiu din ea, pentru a putea monitoriza baza de date în mod eficient, pentru a avertiza la timp despre posibilele situații de avarie care pot apărea.
Și ideile care vor fi prezentate în această expunere pot fi adaptate direct la orice bază de date, fie că este o SGBD sau noSQL. Așadar, nu se referă doar la PostgreSQL, ci vor exista multe rețete despre cum să se facă acest lucru în PostgreSQL. Vor fi exemple de interogări, exemple de entități care există în PostgreSQL pentru monitorizare. Și dacă baza dumneavoastră de date are elemente similare, care pot fi integrate în monitorizare, le puteți adapta, adăuga și va fi excelent.
 În prezentare, nu voi
vorbi despre cum să livrați și să stocați metrici. Nu voi menționa nimic despre procesarea ulterioară a datelor și despre furnizarea acestora utilizatorului. Și nu voi discuta despre alerte.
Pe parcursul povestirii, voi arăta diverse capturi de ecran ale monitorizărilor existente și voi putea să le critic. Totuși, voi încerca să nu numesc branduri pentru a nu crea publicitate sau anti-publicitate acestor produse. Prin urmare, toate coincidențele sunt întâmplătoare și rămân la latitudinea dumneavoastră.
Pentru început, să ne lămurim ce înseamnă monitoring. Monitoringul este un lucru foarte important de care trebuie să dispunem. Toată lumea înțelege asta. Totuși, în același timp, monitoringul nu se încadrează în categoria produselor de afaceri și nu influențează direct profitul companiei, de aceea se acordă întotdeauna timp pentru monitoring în mod indirect. Dacă avem timp, ne ocupăm de monitoring, dacă nu, este în regulă, îl punem în backlog și ne vom întoarce la aceste sarcini cândva.
Prin urmare, din practica noastră, atunci când venim la clienți, monitoringul este adesea insuficient dezvoltat și nu are elemente interesante care să ne ajute să facem o muncă mai bună cu baza de date. Așadar, monitoringul trebuie mereu îmbunătățit.
Baza de date este un element complex care trebuie să fie monitorizat, deoarece baza de date este un depozit de informație. Informația este foarte importantă pentru companie și nu poate fi pierdută sub nicio formă. În același timp, bazele de date sunt pachete software foarte complexe. Ele sunt formate dintr-un număr mare de componente. Multe dintre aceste componente necesită monitorizare.
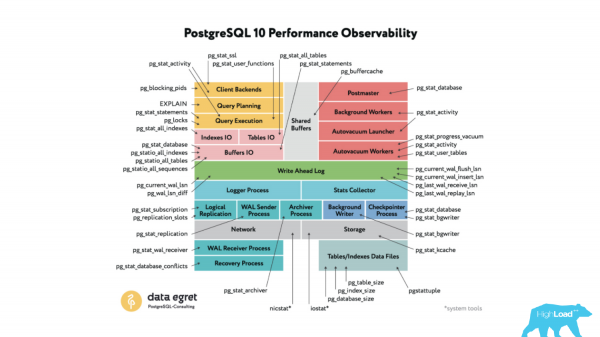 Dacă discutăm specific despre PostgreSQL, acesta poate fi reprezentat printr-un astfel de diagramă, care este formată dintr-un număr mare de componente. Aceste componente interacționează între ele. În același timp, în PostgreSQL există ceea ce se numește sub-sistemul Stats Collector, care permite colectarea statisticilor despre activitatea acestor sub-sisteme și oferă o interfață administratorului sau utilizatorului, pentru a putea vizualiza aceste statistici.
Aceste statistici sunt prezentate sub formă de seturi de funcții și views (vizualizări). Acestea pot fi numite și tabele. Adică, cu ajutorul clientului psql obișnuit, vă puteți conecta la baza de date, să faceți un select asupra acestor funcții și vizualizări și să obțineți date concrete despre activitatea sub-sistemelor PostgreSQL.
Puteți adăuga aceste date în sistemul dumneavoastră preferat de monitorizare, să desenați grafice, să adăugați funcții și să obțineți analize pe termen lung.
Dar în acest raport nu voi examina toate aceste funcții, deoarece ar putea dura o zi întreagă. Voi aborda doar două, trei sau chiar patru aspecte și voi explica cum contribuie acestea la îmbunătățirea monitorizării.
Și dacă vorbim despre monitorizarea bazei de date, ce trebuie să monitorizăm? În primul rând, trebuie să monitorizăm disponibilitatea, deoarece baza de date este un serviciu care oferă acces la date clienților, iar noi trebuie să monitorizăm disponibilitatea, dar oferă și anumite caracteristici calitative și cantitative.
De asemenea, trebuie să monitorizăm clienții care se conectează la baza noastră de date, deoarece aceștia pot fi atât clienți normali, cât și clienți dăunători, care pot afecta baza de date. Aceștia trebuie monitorizați și activitatea lor trebuie urmărită.
Atunci când clienții se conectează la baza de date, este evident că încep să lucreze cu datele noastre, prin urmare, trebuie să monitorizăm și modul în care clienții lucrează cu datele: cu ce tabele, iar într-o măsură mai mică cu ce indici. Adică trebuie să evaluăm încărcarea de muncă (workload) generată de clienții noștri.
Dar și încărcarea de muncă constă, desigur, din interogări. Aplicațiile se conectează la bază, accesează datele prin intermediul interogărilor, așa că este important să evaluăm ce interogări avem în baza de date, să monitorizăm adecvarea lor, să ne asigurăm că nu sunt scrise greșit, și că unele opțiuni trebuie rescrise pentru a funcționa mai repede și cu o performanță mai bună.
Și având în vedere că vorbim despre baza de date, trebuie să știm că aceasta implică întotdeauna procese de fundal. Procesele de fundal permit menținerea performanței bazei de date la un nivel bun, de aceea funcționarea lor necesită o anumită cantitate de resurse. În același timp, acestea se pot suprapune cu resursele interogărilor clienților, așa că o operare excesivă a proceselor de fundal poate influența direct performanța interogărilor clienților. Prin urmare, acestea trebuie de asemenea monitorizate și urmărite pentru a evita eventualele abateri în ceea ce privește procesele de fundal.
Și asta în ceea ce privește monitorizarea bazei de date rămâne în metrica sistemului. Însă, având în vedere că infrastructura noastră se mută în mare parte în cloud, metricile sistemului unui anumit gazdă sunt întotdeauna pe plan secund. Totuși, în bazele de date, ele sunt în continuare relevante, iar monitorizarea metricilor sistemului este cu siguranță necesară.
Cu metricile sistemului, lucrurile sunt în general acceptabile, toate sistemele de monitorizare moderne au deja suport pentru aceste metrici, dar în ansamblu, încă mai lipsesc unele componente și trebuie adăugate câteva lucruri. Voi discuta despre ele, vor fi câteva slide-uri dedicate acestora.
Primul punct al planului este disponibilitatea. Ce înseamnă disponibilitatea? Disponibilitatea, din perspectiva mea, este capacitatea bazei de a gestiona conexiuni, adică baza este activă, ea, ca serviciu, acceptă conexiuni din partea clienților. Și această disponibilitate poate fi evaluată cu ajutorul unor caracteristici. Aceste caracteristici sunt foarte convenabile de afișat pe dashboard-uri.
Toată lumea știe ce sunt dashboard-urile. Este acel moment când arunci o privire pe ecran, unde este centralizată informația necesară. Și poți deja să determini imediat - există o problemă în bază sau nu.
Prin urmare, disponibilitatea bazei de date și alte caracteristici cheie trebuie întotdeauna afișate pe dashboard-uri, astfel încât această informație să fie la îndemână, să fie mereu aproape de tine. Anumite detalii suplimentare, care ajută la investigarea incidentelor, la analiza situațiilor de urgență, trebuie deja afișate pe dashboard-uri secundare sau ascunse în linkuri de tip drilldown care conduc către sisteme externe de monitorizare.
Un exemplu al unui sistem de monitorizare bine cunoscut. Este un sistem de monitorizare foarte avansat. Colectează foarte multe date, dar din punctul meu de vedere, are o viziune ciudată asupra dashboard-urilor. Există un link „creează dashboard”. Dar când creezi un dashboard, creezi o listă, formată din două coloane, o listă de grafice. Și când trebuie să verifici ceva, începi să dai click cu mouse-ul, să derulezi, să cauți graficul dorit. Și acest lucru consumă timp, adică nu există dashboard-uri propriu-zise. Există doar liste de grafice.
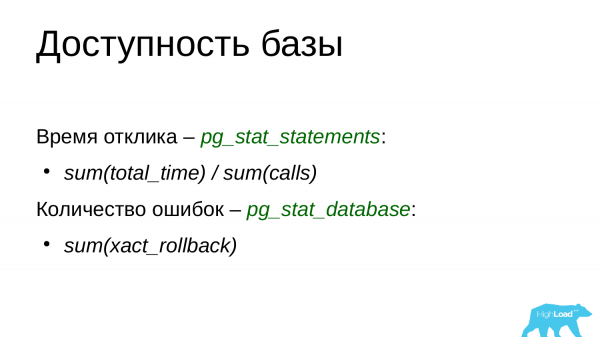
Ce trebuie adăugat pe aceste tablouri de bord? Poate începe cu un atribut precum timpul de răspuns. În PostgreSQL există o vedere numită pg_stat_statements. Implicit, aceasta este dezactivată, dar este una dintre vederea sistemică importantă care trebuie activată și utilizată întotdeauna. Ea stochează informații despre toate interogările care au fost executate în baza de date.
Prin urmare, ne putem baza pe faptul că putem lua timpul total de execuție al tuturor interogărilor și să-l împărțim la numărul interogărilor folosind câmpurile menționate mai sus. Dar aceasta este o temperatură medie pe spital. Ne putem baza pe alte câmpuri - timpul minim de execuție al interogărilor, timpul maxim și cel median. Putem construi chiar și percentilile, în PostgreSQL există funcții corespunzătoare pentru asta. Și putem obține niște cifre care caracterizează timpul de răspuns al bazei noastre pe baza interogărilor deja executate, adică nu executăm o interogare falsă ‘select 1’ și observăm timpul de răspuns, ci analizăm timpii răspunsurilor pentru interogările deja executate și le reprezentăm fie ca o cifră separată, fie construim un grafic pe baza acestora.
De asemenea, este important să monitorizăm numărul de erori generate de sistem în prezent. Și pentru asta putem folosi vederea pg_stat_database. Ne orientăm după câmpul xact_rollback. Acest câmp arată nu doar numărul rollback-urilor care au loc în bază, ci și ia în considerare numărul de erori. Să spunem, putem afișa această cifră în tabloul nostru de bord și să vedem câte erori avem în prezent. Dacă sunt multe erori, acesta este deja un motiv bun pentru a verifica jurnalele și a vedea ce fel de erori sunt și de ce apar, iar apoi să investighăm și să le rezolvăm.
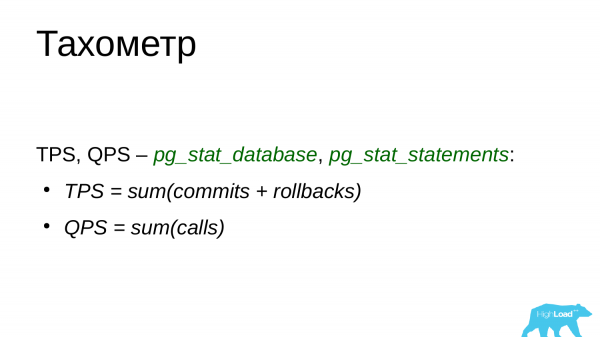
Putem adăuga un indicator, cum ar fi Tachometrul. Aceasta măsoară numărul de tranzacții pe secundă și numărul de interogări pe secundă. Să spunem că poți folosi aceste cifre ca performanța curentă a bazei tale de date și să observi dacă există vârfuri de interogări, vârfuri de tranzacții sau, din contră, baza este subîncărcată pentru că un anumit backend a căzut. Este important să monitorizezi mereu această cifră și să reții că pentru proiectul nostru o astfel de performanță este normală, iar valorile mai mari sau mai mici sunt probleme și neclarități, ceea ce înseamnă că trebuie să analizăm de ce sunt astfel de cifre.
Pentru a evalua numărul de tranzacții, putem să ne orientăm din nou la vizualizarea pg_stat_database. Putem să adunăm numărul de commituri și numărul de rollbackuri pentru a obține numărul de tranzacții pe secundă.
Toți înțeleg că într-o tranzacție pot fi incluse mai multe cereri? De aceea, TPS și QPS sunt ceva diferite.
Numărul de cereri pe secundă poate fi obținut din pg_stat_statements și se poate calcula pur și simplu suma tuturor cererilor efectuate. Este clar că comparăm valoarea curentă cu cea anterioară, scădem, obținem delta și astfel obținem numărul.
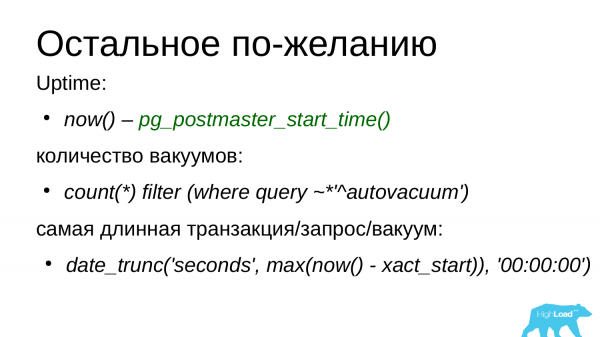
Se pot adăuga metrici suplimentare, dacă se dorește, care ajută, de asemenea, să evaluăm disponibilitatea bazei noastre și să monitorizăm – dacă nu au fost perioade de downtime.
Una dintre aceste metrici este uptime-ul. Însă uptime-ul în PostgreSQL este un lucru puțin complicat. Voi explica de ce. Când PostgreSQL a fost pornit, uptime-ul începe să fie măsurat. Dar dacă, la un moment dat, de exemplu, noaptea, se executa o sarcină, iar OOM-killer-ul a terminat forțat un proces fiu al PostgreSQL, atunci în acest caz PostgreSQL va închide conexiunile tuturor clienților, va reseta zona de memorie portionată și va începe recuperarea de la ultima punct de control. Și în timp ce această recuperare de la punctul de control durează, baza de date nu acceptă conexiuni, adică această situație poate fi evaluată ca downtime. Dar, în același timp, contorul uptime-ului nu se va reseta, deoarece ia în considerare timpul de pornire a postmaster-ului din cel mai timpuriu moment. De aceea, astfel de situații pot fi omise.
De asemenea, trebuie să monitorizăm numărul de lucrători pentru vacuum. Toată lumea știe ce este autovacuum în PostgreSQL? Este un subsistem interesant în PostgreSQL. Despre el au fost scrise multe articole, au fost prezentate multe comunicări. S-au purtat multe discuții despre vacuum, despre cum ar trebui să funcționeze acesta. Mulți îl consideră un rău inevitabil. Dar așa este. Este un fel de analog al colectorului de gunoi, care curăță versiunile depășite ale rândurilor, care nu sunt necesare niciuneia dintre tranzacții și eliberează spațiu în tabele, indici pentru noi rânduri.
De ce trebuie să îl monitorizăm? Pentru că vacuumul uneori face foarte mult rău. Acesta consumă o cantitate mare de resurse, iar cererile clienților încep să fie afectate.
Monitorizarea se face prin vizualizarea pg_stat_activity, despre care voi vorbi în următoarea secțiune. Această vizualizare arată activitatea curentă în baza de date. Prin intermediul acestei activități putem urmări numărul de operații de vacuum care sunt în curs de desfășurare în acest moment. Putem urmări procesele de vacumare și putem observa că, dacă depășim limita, este un motiv să ne uităm la setările PostgreSQL și să optimizăm modul în care funcționează vacuum-ul.
O altă caracteristică a PostgreSQL este că acesta este foarte afectat de tranzacțiile lungi. În special, de tranzacțiile care durează mult și nu fac nimic. Acestea sunt așa-numitele tranzacții idle-in-transaction. O astfel de tranzacție menține blocările, împiedicând funcționarea vacuum-ului. Ca urmare, tabelele se umflă, cresc în dimensiune. Și interogările care procesează aceste tabele încep să lucreze mai lent, deoarece trebuie să procure toate vechile versiuni de rânduri din memorie pe disc și înapoi. De aceea, este necesar să monitorizăm timpul, durata celor mai lungi tranzacții și cele mai lungi interogări de vacuum. Și dacă observăm procese care funcționează deja foarte mult, mai mult de 10-20-30 de minute pentru o sarcină OLTP, atunci trebuie să ne concentrăm asupra lor și să le încheiem forțat sau să optimizăm aplicația, astfel încât să nu fie apelate și să nu rămână suspendate atât de mult. Pentru o sarcină analitică, 10-20-30 de minute este normal, uneori pot fi chiar mai lungi.
Mai departe, avem varianta cu clienții conectați. După ce am format un tablou de bord, am expus pe el metrice cheie de disponibilitate, putem adăuga și informații suplimentare despre clienții conectați.
Informațiile despre clienții conectați sunt importante deoarece, din punctul de vedere al PostgreSQL, clienții pot fi diferiți. Există clienți buni și clienți răi.
Un exemplu simplu. Prin client înțeleg aplicația. Aplicația s-a conectat la baza de date și începe imediat să trimită cererile sale, baza de date le procesează și le execută, iar rezultatele sunt returnate clientului. Aceștia sunt clienți buni și corecți.
Există situații în care clientul s-a conectat, menține conexiunea, dar nu face nimic. El se află într-o stare de idle.
Dar există clienți răi. De exemplu, același client s-a conectat, a deschis o tranzacție, a făcut ceva în baza de date și apoi a plecat în cod, să spunem, pentru a apela o sursă externă sau pentru a efectua o procesare a datelor primite. Însă nu a închis tranzacția. Astfel, tranzacția rămâne deschisă în baza de date și blochează o linie. Aceasta este o situație proastă. Și dacă aplicația ar trebui să se prăbușească din cauza unei excepții (Exception), atunci tranzacția poate rămâne deschisă pentru o perioadă foarte lungă de timp. Acest lucru afectează direct performanța PostgreSQL. PostgreSQL va funcționa mai lent. De aceea, este important să identificăm și să încheiem forțat activitatea acestor clienți. Este necesar să optimizăm aplicația, astfel încât să nu existe astfel de situații.
Alți clienți răi sunt clienții care așteaptă. Însă ei devin răi din cauza circumstanțelor. De exemplu, o tranzacție simplă care stă în așteptare: poate deschide o tranzacție, blochează anumite linii, apoi undeva în cod se prăbușește, lăsând o tranzacție suspendată. Un alt client vine și solicită aceleași date, dar se confruntă cu o blocare, pentru că acea tranzacție suspendată deja deține blocări pe anumite linii necesare. Astfel, a doua tranzacție va rămâne suspendată în așteptarea finalizării primei tranzacții sau a închiderii sale forțate de către administrator. În acest fel, tranzacțiile în așteptare se pot acumula și pot depăși limita de conexiuni la baza de date. Și când limita este depășită, aplicația nu mai poate lucra cu baza. Aceasta este o situație de urgență pentru proiect. De aceea, este important să urmărim clienții răi și să reacționăm prompt.
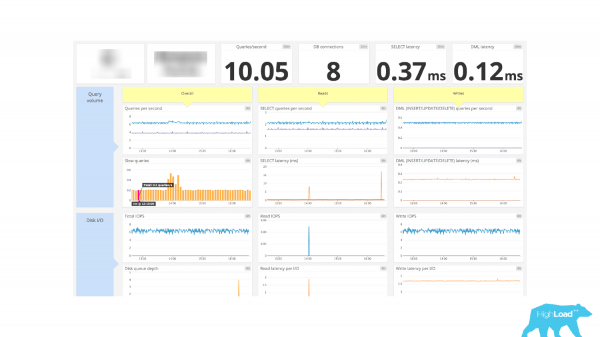
Un alt exemplu de monitorizare. Și aici avem un dashboard decent. Există informații despre conexiuni în partea de sus. Conexiuni DB – 8 la număr. Și atât. Nu avem informații despre care clienți sunt activi, care clienți sunt doar inactivi, fără să facă nimic. Nu există informații despre tranzacțiile suspendate și despre conexiunile așteptătoare, adică este o cifră care arată numărul de conexiuni și atât. Mai departe, ghidați-vă singuri.
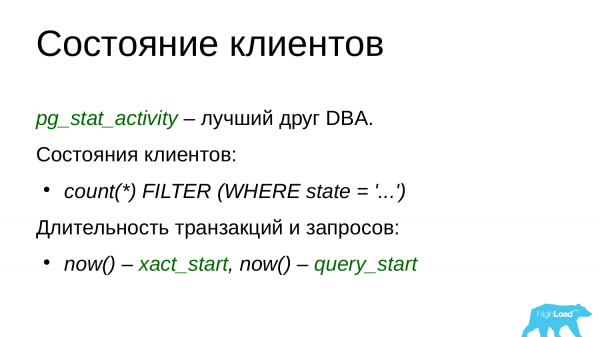
Prin urmare, pentru a adăuga aceste informații în monitorizare, trebuie să ne adresăm vederii sistemice pg_stat_activity. Dacă petreceți mult timp în PostgreSQL, aceasta este o vedere foarte utilă care ar trebui să devină prietenul dumneavoastră, deoarece arată activitatea curentă din PostgreSQL, adică ce se petrece în acesta. Fiecare proces are o linie separată care arată informațiile despre acel proces: de pe ce gazdă s-a realizat conexiunea, sub ce utilizator, cu ce nume, când a fost inițiată tranzacția, ce interogare este în curs de execuție, ce interogare a fost executată ultima dată. Și, prin urmare, starea clientului o putem evalua pe baza câmpului stat. Încă o dată, putem face o grupare pe acest câmp și putem obține acele statistici care există acum în baza de date și numărul de conexiuni care au acel stat în baza de date. Iar cifrele obținute le putem trimite în monitorizarea noastră și putem genera grafice pe baza lor.
De asemenea, este important să evaluăm durata tranzacției. Am menționat deja că este important să evaluăm durata vacuum-urilor, dar și tranzacțiile sunt evaluate la fel. Există câmpurile xact_start și query_start. Acestea, dacă vreți, arată momentul începerii tranzacției și momentul începerii interogării. Folosim funcția now(), care arată marcajul de timp curent și scădem timestamp-ul tranzacției și interogării. Și obținem durata tranzacției, durata interogării.
Dacă vedem tranzacții lungi, ar trebui să le finalizăm. Pentru sarcini OLTP, tranzacțiile lungi sunt cele care depășesc 1-2-3 minute.. Pentru sarcini OLAP, tranzacțiile lungi sunt normale, dar dacă acestea durează mai mult de două ore, acesta este un semn că undeva avem o problemă.
Când clienții se conectează la baza de date, aceștia încep să lucreze cu datele noastre. Ei fac referire la tabele, accesează indecșii pentru a obține date din tabel. Este important să evaluăm cum lucrează clienții cu aceste date.
Acest lucru este necesar pentru a evalua sarcina noastră de lucru și a înțelege aproximativ care dintre tabele sunt cele mai „fierbinți”. De exemplu, este util în situațiile în care vrem să plasăm tabelele „fierbinți” pe un stoc rapid SSD. În schimb, unele tabele de arhivă, pe care nu le folosim de mult timp, pot fi mutate pe un „cold” arhivă, pe discuri SATA, lăsându-le să rămână acolo; accesul la ele se va face doar când este necesar.
De asemenea, este util pentru detectarea anomaliilor după diverse lansări și desfășurări. Să presupunem că proiectul a lansat o nouă caracteristică. De exemplu, a fost adăugată o nouă funcționalitate pentru lucrul cu baza de date. Iar dacă construim grafice de utilizare a tabelelor, pe aceste grafice putem detecta cu ușurință aceste anomalii. De exemplu, vârfuri de update sau vârfuri de delete. Acest lucru va fi foarte vizibil.
De asemenea, se pot detecta anomaliile „deviate” ale statisticilor. Ce înseamnă asta? PostgreSQL are un planificator de interogări foarte puternic și bun. Iar dezvoltatorii dedică mult timp dezvoltării acestuia. Cum funcționează? Pentru a construi planuri bune, PostgreSQL colectează, la intervale de timp specifice, statistici despre distribuția datelor în tabele. Acestea includ cele mai frecvente valori: numărul de valori unice, informații despre NULL în tabel, foarte multe informații.
Pe baza acestor statistici, planificatorul construiește mai multe interogări, alege cea mai optimă și folosește acest plan de interogare pentru a executa efectiv interogarea și a returna datele.
Se întâmplă ca statisticile să „deviate”. Calitatea și cantitatea datelor s-au schimbat în tabel, dar statisticile nu au fost actualizate. Iar planurile formate pot deveni suboptimale. Dacă planurile noastre devin suboptime în urma monitorizării, pe tabele, vom putea vedea aceste anomalii. De exemplu, undeva calitativ s-au schimbat datele și, în loc de utilizarea unui index, s-a început utilizarea unei treceri secvențiale prin tabel; astfel, dacă interogarea trebuie să returneze doar 100 de rânduri (există o limită de 100), atunci pentru această interogare va fi efectuată o căutare completă. Și acest lucru are întotdeauna un impact negativ asupra performanței.
Și vom putea vedea acest lucru în monitorizare. Deja putem verifica această interogare, face un explain pentru ea, aduna statistica, construi un nou index suplimentar. Și putem reacționa la această problemă. Din acest motiv este important.
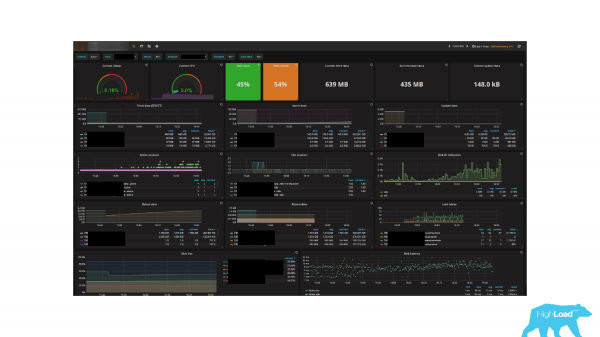
Un alt exemplu de monitorizare. Cred că mulți l-au recunoscut, deoarece este foarte popular. Cine îl folosește în proiectele sale ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Dar aici există un detaliu neplăcut.
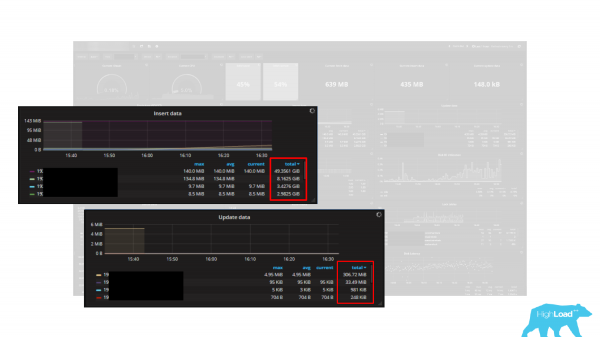
Există câteva grafice. Și ca unitate sunt indicate byte-urile, adică sunt 5 grafice. Acestea sunt Insert data, Update data, Delete data, Fetch data și Return data. Ca unitate de măsură sunt indicate byte-urile. Problema este că statistica din PostgreSQL returnează datele în tuple (în rânduri). Și, prin urmare, aceste grafice sunt o modalitate foarte bună de a subestima sarcina de lucru de mai multe ori, zeci de ori, deoarece tuple-urile nu sunt byte-uri, tuple-urile sunt rânduri, adică multe byte-uri și au întotdeauna lungime variabilă. Așadar, a calcula sarcina de lucru în byte-uri folosind tuple-uri este o sarcină nerealizabilă sau foarte complicată. De aceea, când folosești un dashboard sau monitorizarea încorporată, este întotdeauna important să înțelegi că acesta funcționează corect și îți returnează datele evaluate corect.
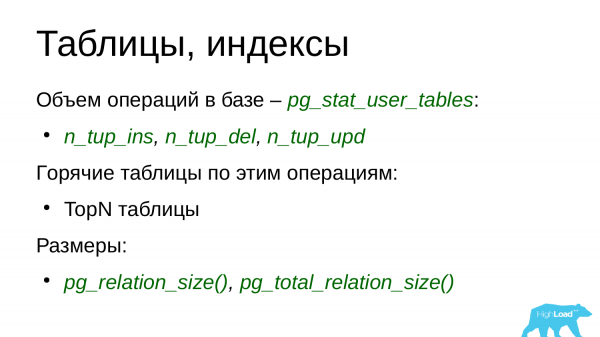
Cum se obține statistica pentru aceste tabele? Pentru aceasta, în PostgreSQL există un anumit grup de vizualizări. Iar vizualizarea principală este . User_tables înseamnă că tabelele sunt create în numele utilizatorului. Spre deosebire de vizualizările sistemice, care sunt folosite de PostgreSQL însuși. Și există un tabel sumar numit Alltables, care include atât vizualizările sistemice, cât și cele ale utilizatorilor. Poți să te bazezi pe oricare dintre ele, care îți place cel mai mult.
Pe baza câmpurilor menționate mai sus, se poate evalua numărul de inserturi, update-uri și ștergeri. Exemplul de dashboard pe care l-am folosit folosește exact aceste câmpuri pentru evaluarea caracteristicilor sarcinii de lucru. De aceea, putem să ne bazăm și pe ele. Dar trebuie să ținem cont că acestea sunt tuple-uri, nu byte-uri, așa că nu putem lua și face asta în byte-uri.
Pe baza acestor date putem construi așa-numitele tabele TopN. De exemplu, Top-5, Top-10. Și putem monitoriza acele tabele „fierbinți” care sunt utilizate mai mult decât altele. De exemplu, 5 tabele „fierbinți” pentru inserții. Și pe baza acestor tabele TopN evaluăm sarcina noastră de lucru și putem evalua vârfurile de sarcină de lucru după diverse lansări, actualizări și desfășurări.
De asemenea, este important să evaluăm dimensiunile tabelului, deoarece uneori dezvoltatorii lansează o nouă caracteristică și tabelele încep să crească în dimensiuni mari, deoarece decidem să adăugăm un volum suplimentar de date, dar nu am prevăzut cum va afecta acest lucru dimensiunea bazei de date. Astfel de cazuri ne surprind uneori.
Și acum o întrebare pentru voi. Ce întrebare vă vine în minte atunci când observați o încărcare pe serverul cu baza de date? Care este următoarea întrebare pe care o aveți?
Dar, de fapt, următoarea întrebare este. Ce interogări generează această încărcare? Adică, nu este interesant să vedem procesele care generează această încărcare. Este clar că dacă există un host cu baza de date, atunci acolo este lansată baza de date și e normal ca doar bazele de date să consume resurse. Dacă deschidem Top, vom vedea acolo o listă de procese în PostgreSQL care fac ceva. Din Top nu va fi clar ce fac.
Prin urmare, trebuie să identificăm acele interogări care generează cea mai mare încărcare, deoarece optimizarea interogărilor, de regulă, oferă mai mult profit decât optimizarea configurației PostgreSQL sau a sistemului de operare, sau chiar optimizarea hardware-ului. Pot să spun că este în jur de 80-85-90%. Și se face mult mai repede. Este mai rapid să corectăm o interogare decât să corectăm configurația, să planificăm o repornire, mai ales dacă baza nu poate fi repornită sau dacă trebuie să adăugăm hardware. Este mai simplu să rescriem o interogare sau să adăugăm un index pentru a obține deja un rezultat mai bun de la acea interogare.
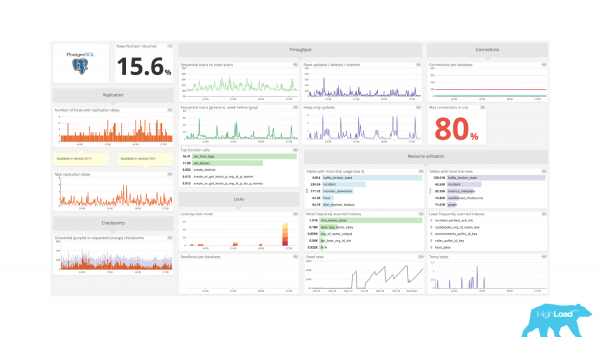
Prin urmare, trebuie să monitorizăm interogările și adecvarea lor. Să luăm un alt exemplu de monitorizare. Și aici pare să existe o monitorizare excelentă. Există informații despre replicare, informații despre lățimea de bandă, blocaje, utilizarea resurselor. Totul este perfect, dar nu există informații despre interogări. Nu este clar ce interogări sunt executate în baza noastră de date, cât durează executarea lor, câte astfel de interogări sunt. Avem nevoie ca monitorizarea să ne ofere întotdeauna aceste informații.
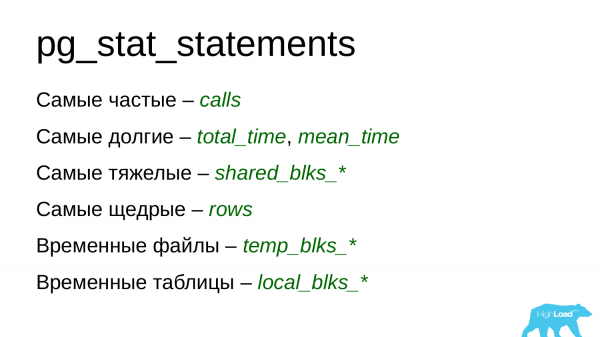
Și pentru a obține aceste informații, putem utiliza modulul pg_stat_statements. Pe baza acestuia, putem construi cele mai diferite grafice. De exemplu, putem obține informații despre cele mai frecvente interogări, adică despre cele care sunt executate cel mai des. Da, după deploy-uri este de asemenea foarte util să ne uităm la el și să înțelegem dacă există o creștere a interogărilor.
Putem monitoriza cele mai îndelungate interogări, adică acelea care durează cel mai mult. Ele lucrează pe procesor, consumă I/O. Putem evalua aceasta și pe baza câmpurilor total_time, mean_time, blk_write_time și blk_read_time.
Putem evalua și monitoriza cele mai grele interogări în ceea ce privește utilizarea resurselor, cele care citesc de pe disc, care lucrează cu memorie sau, din contră, generează o anumită sarcină de scriere.
Putem evalua cele mai generoase interogări. Acestea sunt cele care returnează un număr mare de rânduri. De exemplu, poate fi o interogare unde s-a uitat să se pună un limit. Și pur și simplu returnează tot conținutul tabelului sau al interogărilor din tabelele solicitate.
De asemenea, putem monitoriza interogările care folosesc fișiere temporare sau tabele temporare.
Și ne-au mai rămas procesele de fundal. Procesele de fundal sunt în primul rând checkpoint-urile sau, cum mai sunt numite, punctele de control, autovacuum-ul și replicarea.
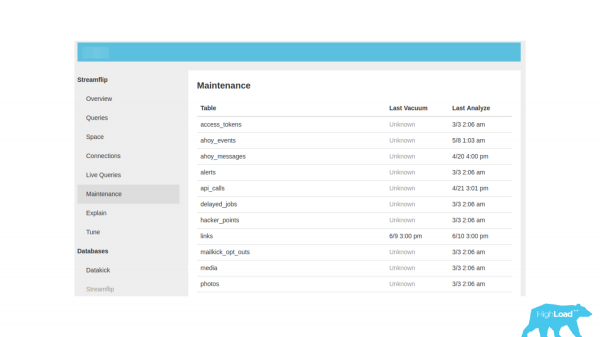
Un alt exemplu de monitorizare. Există tab-ul Maintenance în stânga, ne mutăm pe el și sperăm să vedem ceva util. Dar aici este doar timpul de funcționare al vacum-ului și colectării statisticilor, nimic mai mult. Aceasta este o informație foarte sărăcăcioasă, așa că trebuie să avem întotdeauna informații despre modul în care funcționează procesele de fundal în baza noastră de date și dacă nu există probleme din cauza activității lor.
Atunci când examinăm punctele de control, trebuie să ne amintim că punctele de control resetau paginile „murdare” din zona de memorie shard-ată pe disc, apoi creează un punct de control. Și acest punct de control poate fi folosit mai departe ca un fel de loc la recuperare, în cazul în care PostgreSQL s-a încheiat brusc.
Așadar, pentru a salva toate paginile „murdare” pe disc, este necesar să se efectueze un anumit volum de scriere. Și, de obicei, pe sistemele cu o memorie mare – acest volum este foarte mare. Iar dacă avem checkpoint-uri efectuate foarte des într-un interval scurt, atunci performanța discului va scădea semnificativ. Iar cererile clienților vor suferi din cauza lipsei de resurse. Ele vor lupta pentru resurse și le va lipsi performanța.
Astfel, prin pg_stat_bgwriter, putem monitoriza numărul de checkpoint-uri care au loc în funcție de câmpurile specificate. Și dacă avem, într-un anumit interval de timp (de 10-15-20 de minute, de jumătate de oră), foarte multe checkpoint-uri, de exemplu, 3-4-5, aceasta poate fi deja o problemă. Și trebuie să ne uităm în baza de date, să verificăm configurația, pentru a înțelege ce cauzează un astfel de număr mare de checkpoint-uri. Poate că se efectuează o scriere mare. Pe baza încărcării de lucru putem evalua deja, pentru că graficele de încărcare sunt deja adăugate. Putem ajusta deja parametrii pentru checkpoint-uri și să facem astfel încât acestea să nu afecteze semnificativ performanța cererilor.
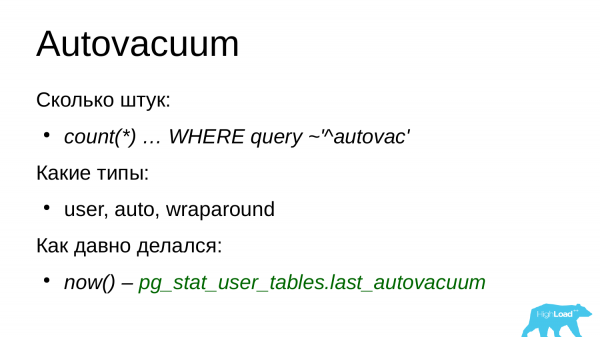
Revin din nou la autovacuum, pentru că aceasta este o problemă, așa cum am mai spus, care poate afecta semnificativ atât performanța discurilor, cât și a cererilor; de aceea este întotdeauna important să evaluăm numărul de autovacuum-uri.
Numărul de lucrători autovacuum în baza de date este limitat. În mod implicit, există trei, așadar, dacă avem tot timpul trei lucrători activi în bază, înseamnă că autovacuum-ul nu este configurat corespunzător, este necesar să creștem limitele, să revizuim setările autovacuum și să intervenim în configurație.
Este important să evaluăm care dintre lucrătorii de vacuum sunt activi. Fie că este vorba despre un vacuum lansat de un utilizator, un DBA care a venit și a lansat manual un anumit vacuum, ceea ce a generat o încărcare. A apărut o problemă. Fie că este vorba despre numărul vacuum-urilor care descompun contorul de tranzacții. Pentru unele versiuni PostgreSQL – aceste vacuum-uri sunt foarte solicitante. Și ele pot afecta semnificativ performanța, deoarece citesc întreaga tabelă în întregime, scanează toate blocurile din acea tabelă.
Și, desigur, durata vacuumului. Dacă avem vacuumuri lungi, care funcționează pentru o perioadă îndelungată, atunci este cazul să ne reorientăm atenția asupra configurației vacuumului și, poate, să ne revizuim setările. Deoarece poate apărea situația în care vacuumul lucrează pe o tabelă o perioadă lungă de timp (3-4 ore), dar în acel interval de timp, pe tabelă au acumulat din nou un volum mare de linii moarte. Și de îndată ce vacuumul se termină, trebuie din nou să facă vacuum pe această tabelă. Și ajungem la o situație de vacuum infinit. Într-un astfel de caz, vacuumul nu își îndeplinește funcția, iar tabelele încep treptat să se umfle în dimensiuni, deși volumul de date utile rămâne același. Așadar, în cazul vacuumurilor lungi, întotdeauna ne uităm la configurație și încercăm să o optimizăm, dar astfel încât să nu fie afectată performanța cererilor clienților.
În prezent, aproape nu există instalări PostgreSQL fără replicare în flux. Replicarea este procesul de transfer al datelor de la master la replică.
Replicarea în PostgreSQL se desfășoară prin jurnalul de tranzacții. Masterul generează jurnalul de tranzacții. Acest jurnal de tranzacții este transmis prin conexiune de rețea la replică, iar mai departe, pe replică, acesta se reproduce. Totul este simplu.
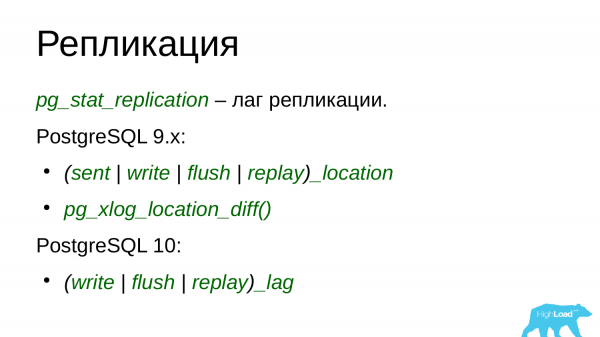
Prin urmare, pentru monitorizarea întârzierii replicării se folosește vizualizarea pg_stat_replication. Dar nu este chiar simplu. În versiunea 10, vizualizarea a suferit câteva modificări. În primul rând, o parte din câmpuri a fost redenumită. Și s-au adăugat câteva câmpuri. În versiunea 10 au apărut câmpuri care permit evaluarea întârzierii replicării în secunde. Este foarte convenabil. Până la versiunea 10, existase posibilitatea de a evalua întârzierea replicării în octeți. Această posibilitate a rămas și în versiunea 10, adică puteți alege ce vă este mai convenabil - să evaluați întârzierea în octeți sau în secunde. Multe persoane fac ambele.
Dar, totuși, pentru a evalua întârzierea replicării, trebuie să cunoaștem poziția jurnalului în tranzacție. Și aceste poziții ale jurnalului de tranzacții sunt tocmai în vizualizarea pg_stat_replication. Așadar, putem folosi funcția pg_xlog_location_diff() pentru a lua două puncte din jurnalul de tranzacții. Să calculăm între ele delta și să obținem întârziera replicării în octeți. Este foarte convenabil și simplu.
În versiunea 10, această funcție a fost redenumită în pg_wal_lsn_diff(). Practic, în toate funcțiile, vizualizările, utilitările unde a fost întâlnit cuvântul „xlog”, acesta a fost înlocuit cu valoarea „wal”. Acest lucru se aplică atât vizualizărilor, cât și funcțiilor. Este o astfel de inovație.
De asemenea, în versiunea 10 au fost adăugate rânduri care arată în mod specific latența. Este vorba despre write lag, flush lag, replay lag. Adică aceste aspecte trebuie monitorizate. Dacă observăm că există o latență a replicării, trebuie să investigăm de ce a apărut, de unde provine și să remediem problema.
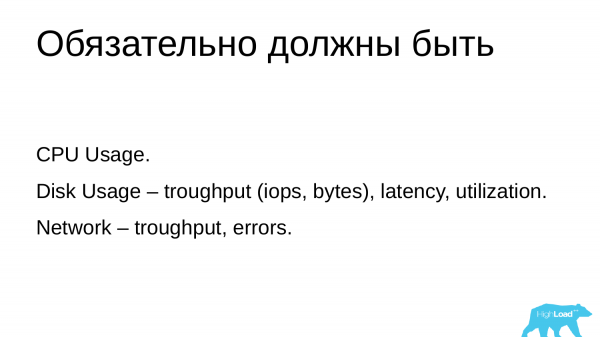
În ceea ce privește metricele sistemului, aproape totul este în ordine. Când se dezvoltă orice monitorizare, aceasta începe cu metricele sistemului. Este vorba despre utilizarea CPU-ului, memoriei, swap-ului, rețelei și discului. Cu toate acestea, multe dintre parametrii lipsesc implicit.
Dacă utilizarea procesorului este în regulă, atunci există probleme cu utilizarea discului. De obicei, dezvoltatorii de monitorizări adaugă informații despre lățimea de bandă. Aceasta poate fi în IOPS sau bytes. Dar uită de latență și utilizarea dispozitivelor de stocare. Acestea sunt parametrii mai importanți, care permit evaluarea gradului de încărcare a discurilor și gradul în care acestea întâmpină probleme. Dacă avem o latență mare, înseamnă că există probleme cu discurile. Dacă avem o utilizare mare, înseamnă că discurile nu fac față. Acestea sunt caracteristici de calitate mai înaltă decât lățimea de bandă.
Având în vedere că aceste statistici pot fi obținute și din sistemul de fișiere /proc, așa cum se face pentru utilizarea procesorului. Nu știu de ce aceste informații nu sunt incluse în monitorizări. Cu toate acestea, este important să ai aceste informații în monitorizarea ta.
La fel se aplică și pentru interfețele de rețea. Există informații despre lățimea de bandă a rețelei în pachete, în bytes, dar cu toate acestea nu există informații despre latență și nu există informații despre utilizare, deși acestea sunt informații utile.
Toate monitorizările au dezavantaje. Și orice monitorizare ai alege, ea va comporta întotdeauna anumite neconformități cu diverse criterii. Totuși, acestea se dezvoltă, se adaugă noi caracteristici, așa că alege ceva și îmbunătățește-l.
Și pentru a îmbunătăți, trebuie să ai întotdeauna o idee despre ce înseamnă statisticile furnizate și cum pot fi utilizate pentru a rezolva probleme.
Și câteva puncte cheie:
- Este important să monitorizăm permanent disponibilitatea, să avem tablouri de bord pentru a putea evalua rapid dacă baza este în regulă.
- Este esențial să avem o imagine de ansamblu asupra clienților care interacționează cu baza de date, pentru a putea identifica și elimina clienții neperformanți.
- Este important să evaluăm cum interacționează acești clienți cu datele. Trebuie să avem o idee despre încărcarea de lucru.
- Este important să evaluăm cum se formează această încărcare de lucru, prin ce interogări. Puteți analiza interogările, le puteți optimiza, refactoriza și să construiți indecși pentru ele. Aceasta este o activitate crucială.
- Procesele de fond pot afecta negativ interogările clienților, de aceea este important să monitorizăm pentru a ne asigura că nu consumă prea multe resurse.
- Metricile de sistem vă permit să planificați scalarea și creșterea capacității serverelor, așadar este important să le monitorizați și să le evaluați.
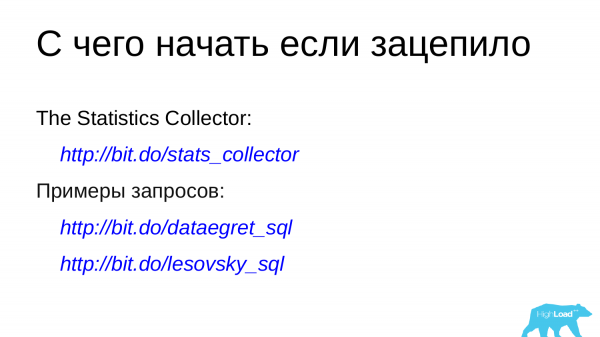
Dacă sunteți interesat de acest subiect, puteți accesa aceste linkuri.
— este documentația oficială a colectorilor de statistică. Acolo găsiți descrierea tuturor vederilor de statistică și a tuturor câmpurilor. Le puteți citi, înțelege și analiza. Iar pe baza lor puteți construi grafice proprii, să le adăugați în monitorizările dvs.
Exemple de interogări:
Aceasta este repositoul nostru corporatist și, de asemenea, al meu. Acesta conține exemple de interogări. Nu sunt interogări de tipul select * from ceva. Sunt deja interogări gata cu join-uri, aplicând funcții interesante care transformă datele brute în valori ușor de citit și de utilizat, adică byte-uri, timp. Puteți să le examinați, să analizați, să le adăugați în monitorizările dvs. și să construiți proprietăți pe baza lor.
Întrebări
Întrebare: Ați spus că nu veți promova branduri, dar sunt curios – ce tablouri de bord folosiți în proiectele dvs.?
Răspuns: Variat. Uneori venim la client și el are deja un sistem de monitorizări. Și noi îl consiliem cu privire la ce ar trebui să adauge în acesta. Problema cea mai mare este cu Zabbiх, pentru că nu oferă posibilitatea de a construi grafice TopN. Folosim , deoarece i-am consiliat pe acești băieți în ceea ce privește monitorizarea. Ei au realizat monitorizarea PostgreSQL pe baza specificației noastre. Lucrez la un proiect personal care corespunde datelor prin Prometheus și le ilustrează în . Am sarcina să creez un exportator în Prometheus și apoi să ilustreze totul în Grafana.
Întrebare: Există vreo alternativă la rapoartele AWR sau ... agregări? Îți este cunoscut ceva de genul acesta?
Răspuns: Da, știu ce este AWR, este o chestie grozavă. În prezent există diverse soluții care implementează aproximativ următoarea model. La un interval de timp, se scriu anumite baseline-uri în același PostgreSQL sau într-un stocare separată. Le poți căuta online, există. Unul dintre dezvoltatorii unei astfel de soluții activează pe forumul sql.ru în secțiunea PostgreSQL. Îl poți găsi acolo. Da, există astfel de soluții, le poți folosi. În plus, eu de asemenea, scriu o soluție care permite să facă același lucru.
P.S.1 Dacă folosești postgres_exporter, ce tablou de bord folosești? Există câteva. Acestea sunt deja învechite. Poate comunitatea ar putea crea un șablon actualizat?
P.S.2 Am eliminat pganalyze, deoarece este o ofertă SaaS proprietară care se concentrează pe monitorizarea performanței și sugestii automate de ajustare.
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Care monitorizare self-hosted pentru PostgreSQL (cu tablou de bord) consideri că este cea mai bună?
30,0%Zabbix + extensiile de la Aleksey Lesovski sau zabbix 4.4 sau libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze este un SaaS proprietar - nu pot să-l elimin1
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 utilizatori au votat. 26 de utilizatori s-au abținut.
Sursa: habr.com
