

Condiția standard pentru implementarea CI/CD în Kubernetes: aplicația trebuie să fie capabilă să nu primească noi solicitări de la clienți înainte de a fi oprită complet și, cel mai important, să finalizeze cu succes toate solicitările existente.
Respectarea acestei condiții permite atingerea unei perioade de nefuncționare zero în timpul desfășurării. Cu toate acestea, chiar și atunci când se utilizează combinații foarte populare (cum ar fi NGINX și PHP-FPM), se pot întâlni dificultăți care vor duce la o creștere a erorilor la fiecare desfășurare...
Teoria. Cum funcționează un pod
Detalii despre ciclul de viață al unui pod au fost deja publicate . În contextul subiectului discutat, ne interesează următoarea informație: în momentul în care podul trece în starea Terminating, nu mai sunt trimise noi solicitări (podul este eliminat din lista endpoint-urilor pentru serviciu). Astfel, pentru a evita perioadele de nefuncționare în timpul desfășurării, este suficient să rezolvăm problema opririi corecte a aplicației.
De asemenea, trebuie să reținem că perioada de grație este implicit setată la : după această perioadă, podul va fi terminat și aplicația trebuie să reușească să proceseze toate solicitările până la sfârșitul acestei perioade. Notă: deși orice solicitare care durează mai mult de 5-10 secunde este deja problematică, iar oprirea grațioasă nu o va mai putea salva...
Pentru a înțelege mai bine ce se întâmplă când un pod își finalizează activitatea, este suficient să studiem următoarea schemă:
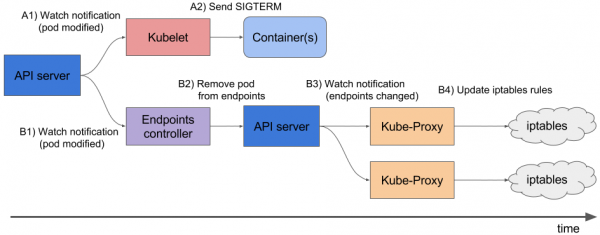
A1, B1 — Primirea modificărilor privind starea podului
A2 — Trimiterea SIGTERM
B2 — Eliminarea podului din endpoint-uri
B3 — Primirea modificărilor (lista endpoint-urilor s-a schimbat)
B4 — Actualizarea regulilor iptables
Rețineți: eliminarea endpoint-ului podului și trimiterea SIGTERM nu se realizează secvențial, ci în paralel. Iar din cauza faptului că Ingress nu primește imediat lista actualizată de endpoint-uri, vor fi trimise solicitări noi către pod de la clienți, ceea ce va cauza erori 500 în timpul terminării podului. (material mai detaliat despre această problemă este ). Această problemă trebuie abordată în următoarele moduri:
- Trimiterea în antetul răspunsului a Connection: close (dacă este vorba despre o aplicație HTTP).
- Dacă nu există posibilitatea de a efectua modificări în cod, articolul continuă cu o soluție care va permite procesarea solicitărilor până la finalul perioadei de grație.
Teoria. Cum finalizează NGINX și PHP-FPM procesele lor
NGINX
Să începem cu NGINX, deoarece acesta este destul de evident. Studiind teoria, aflăm că NGINX are un singur proces master și mai mulți „workeri” — acestea sunt procesele fiice care procesează cererile clienților. Este prevăzută o opțiune convenabilă: cu ajutorul comenzii nginx -s se pot încheia procesele fie în modul fast shutdown, fie în graceful shutdown. Este evident că ne interesează exact ultima variantă.
Apoi totul este simplu: trebuie să adăugăm în comanda care va trimite un semnal pentru graceful shutdown. Acest lucru se poate face în Deployment, în blocul containerului:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Acum, în momentul în care pod-ul se închide, în jurnalele containerului NGINX vom vedea următoarele:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
Și acest lucru va însemna exact ceea ce ne trebuie: NGINX așteaptă finalizarea cererilor, după care oprește procesul. Totuși, mai jos va fi discutată o problemă obișnuită, care face ca chiar și cu comanda nginx -s quit procesul să se încheie incorect.
În această etapă, am terminat cu NGINX: cel puțin din jurnale putem înțelege că totul funcționează așa cum trebuie.
Cum stau lucrurile cu PHP-FPM? Cum procesează acesta graceful shutdown? Haideți să ne lămurim.
PHP-FPM
În cazul lui PHP-FPM, informațiile sunt mai puține. Dacă ne orientăm după pentru PHP-FPM, acesta va relata că sunt acceptate următoarele semnale POSIX:
-
SIGINT,SIGTERM— fast shutdown; -
SIGQUIT— graceful shutdown (exact ceea ce ne trebuie).
Celelalte semnale nu sunt necesare în această sarcină, de aceea le vom omite. Pentru a încheia procesul corect, va trebui să scriem următorul preStop-hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
La prima vedere, acestea sunt toate cerințele pentru a efectua graceful shutdown în ambele containere. Totuși, sarcina este mai complicată decât pare. Urmează două cazuri în care graceful shutdown nu a funcționat, provocând o indisponibilitate temporară a proiectului în timpul implementării.
Practică. Posibile probleme cu graceful shutdown
NGINX
În primul rând, este util să țineți minte: pe lângă executarea comenzii nginx -s quit Există o altă etapă la care merită să fim atenți. Ne-am confruntat cu problema în care NGINX, în loc de semnalul SIGQUIT, trimitea totuși SIGTERM, ceea ce a dus la finalizarea incorectă a solicitărilor. Cazuri similare pot fi întâlnite, de exemplu, . Din păcate, nu am reușit să stabilim cauza exactă a acestui comportament: a existat suspiciunea că sunt implicate versiunile NGINX, dar aceasta nu s-a confirmat. Simptomele s-au manifestat prin faptul că în jurnalul containerului NGINX apăreau mesaje «open socket #10 left in connection 5», după care podul se oprea.
Putem observa această problemă, de exemplu, în răspunsurile primite pe Ingress-ul nostru:
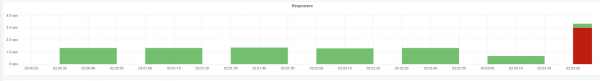
Indicatorii codurilor de stare în momentul desfășurării
În acest caz, primim exact codul de eroare 503 de la Ingress: nu poate accesa containerul NGINX, deoarece acesta nu mai este disponibil. Dacă ne uităm în jurnalele containerului cu NGINX, acestea conțin următoarele:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
După modificarea semnalului de oprire, containerul începe să se oprească corect: acest lucru este confirmat de faptul că nu mai observăm eroarea 503.
Dacă te-ai confruntat cu o problemă similară, are sens să investighezi ce semnal de oprire este utilizat în container și cum arată hook-ul preStop. Este destul de posibil ca cauza să fie chiar aici.
PHP-FPM… și nu numai
Problema cu PHP-FPM se descrie simplu: nu așteaptă finalizarea proceselor sale fiice, le termină, ceea ce generează erori 502 în timpul desfășurării și altor operațiuni. Pe bugs.php.net există mai multe raportări de erori din 2005 (de exemplu, și ), în care este descrisă această problemă. Iar în jurnale, probabil, nu vei observa nimic: PHP-FPM va anunța finalizarea procesului său fără vreo eroare sau notificare externă.
Merită menționat că problema în sine poate depinde în mai mare sau mai mică măsură de aplicație și poate să nu se manifeste, de exemplu, în monitorizare. Totuși, dacă te confrunți cu ea, prima soluție care îți vine în minte este un workaround simplu: adăugarea unui hook preStop cu sleep(30). Acesta va permite finalizarea tuturor solicitărilor care erau anterioare (iar noi nu primim altele noi, deoarece podul este deja este în stare Terminating), iar după 30 de secunde, podul se va încheia prin semnalul SIGTERM.
Deci, rezultă că lifecycle pentru container va arăta astfel:
    lifecycle:
      preStop:
        exec:
          command:
          - \/bin\/sleep
          - "30"
Cu toate acestea, din cauza specificării celor 30 de secunde, sleep am significativ mai mult vom crește timpul de deploy, deoarece fiecare pod va fi terminat minim 30 de secunde, ceea ce este insuficient. Ce se poate face cu asta?
Să ne adresăm părții responsabile pentru executarea efectivă a aplicației. În cazul nostru, aceasta este PHP-FPM, care în mod implicit nu urmărește execuția proceselor sale copil: procesul maestru este terminat imediat. Comportamentul acesta poate fi modificat cu ajutorul directivei process_control_timeout, care indică limitele temporale pentru a aștepta semnalele de la maestru de către procesele copil. Dacă se setează o valoare de 20 de secunde, aceasta va acoperi majoritatea cererilor efectuate în container, iar după finalizarea acestora, procesul maestru va fi oprit.
Având aceste informații, să ne întoarcem la problema noastră anterioară. Așa cum s-a menționat anterior, Kubernetes nu este o platformă monolitică: interacțiunea dintre diferitele sale componente necesită un anumit timp. Acest lucru este deosebit de relevant atunci când analizăm funcționarea Ingress-urilor și a altor componente adiacente, deoarece din cauza acestei întârzieri, este ușor să obținem un vârf de erori 500 în momentul depozitării. De exemplu, o eroare poate apărea în etapa de trimitere a cererii către upstream, dar
de fapt, "întârzierea temporală" a interacțiunii între componente este destul de scurtă— sub o secundă. în ansamblu Prin urmare, process_control_timeout cu directiva menționată anterior, lifecycle:
putem folosi următoarea construcție pentru lifecycle: preStop: exec: command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"] sleep În acest mod, compensăm întârzierea cu comanda process_control_timeout, iar lifecycle și nu majorăm semnificativ timpul de deploy: căci este o diferență notabilă între 30 de secunde și una?.. Practic, "munca principală" este preluată de
În general, este folosită doar ca o "măsură de siguranță" în caz de lag.comportamentul descris și soluția corespunzătoare nu se aplică doar PHP-FPM.
O situație similară poate apărea în diverse moduri atunci când se folosesc alte limbaje de programare/framework-uri. Dacă nu se poate corecta graceful shutdown prin alte metode— de exemplu, rescriind codul astfel încât aplicația să gestioneze corect semnalele de terminare— se poate aplica metoda descrisă. Deși nu este cea mai elegantă, funcționează.
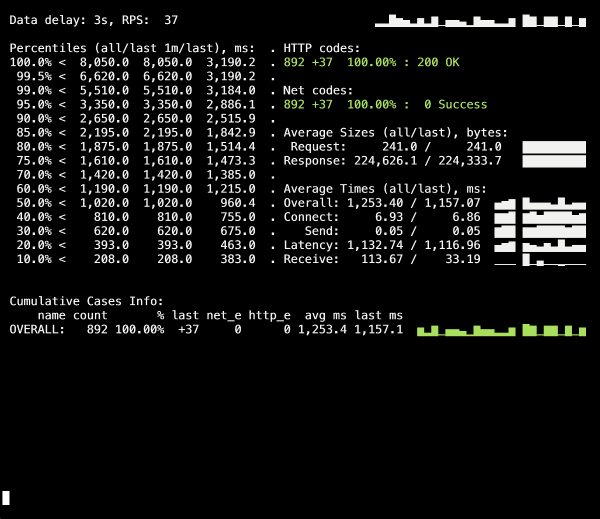
Testarea de încărcare este una dintre metodele de verificare a modului în care funcționează un container, deoarece această procedură se apropie de condițiile reale de utilizare, când utilizatorii accesează site-ul. Pentru a testa recomandările menționate mai sus, se poate folosi : acesta acoperă excelent toate nevoile noastre. Următoarele sunt sfaturi și recomandări pentru desfășurarea testării, cu un exemplu clar — datorită graficelor Grafana și ale Yandex.Tank — din experiența noastră.
Cel mai important aici este să verificați schimbările pas cu pas. După adăugarea unei noi corecții, lansați testarea și observați dacă rezultatele s-au schimbat în comparație cu runda anterioară. În caz contrar, va fi dificil să identificați soluțiile ineficiente, iar pe termen lung s-ar putea chiar să răniți (de exemplu, să creșteți timpul de deploy).
Un alt aspect — urmăriți jurnalele containerului în timpul terminării acestuia. Se înregistrează acolo informații despre închideri grațioase? Există erori în jurnale la accesarea altor resurse (de exemplu, către containerul adjacent PHP-FPM)? Erorile aplicației în sine (cum ar fi în cazul descris mai sus cu NGINX)? Sper că informațiile introducerii din acest articol ajută să înțelegeți mai bine ce se întâmplă cu containerul în timpul terminării sale.
Deci, prima rundă de testare a avut loc fără lifecycle și fără directive suplimentare pentru serverul de aplicații (process_control_timeout în PHP-FPM). Scopul acestui test a fost de a identifica aproximativ numărul de erori (și dacă există cu adevărat). De asemenea, din informații suplimentare, ar trebui să știți că timpul mediu de deploy pentru fiecare pod a fost de aproximativ 5-10 secunde până la starea de completă pregătire. Rezultatele sunt următoarele:
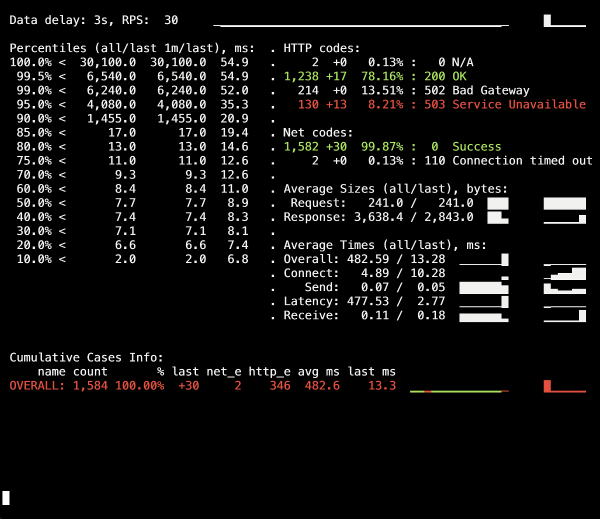
Pe panoul de informații Yandex.Tank se observă un vârf de erori 502, care a avut loc în momentul deploy-ului și a durat în medie până la 5 secunde. Se presupune că aceste solicitații existente erau întrerupte către vechiul pod în momentul terminării acestuia. După aceea, au apărut erori 503, care au fost rezultatul containerului NGINX oprit, care a întrerupt de asemenea conexiunile din cauza backend-ului (din cauza căruia Ingress-ul nu a putut să se conecteze).
Să vedem cum process_control_timeout în PHP-FPM ne va ajuta să așteptăm finalizarea proceselor copil, adică să corectăm aceste erori. Re-deploy-ul deja cu utilizarea acestei directive:
În timpul desfășurării, nu mai există erori 500! Desfășurarea decurge cu succes, iar oprirea grațioasă funcționează.
Totuși, merită să ne amintim momentul cu containerele Ingress, un procent mic de erori pe care le putem obține din cauza întârzierilor temporare. Pentru a le evita, trebuie să adăugăm o construcție cu sleep și să repetăm desfășurarea. Totuși, în cazul nostru specific, nu au fost vizibile modificări (nu mai sunt erori).
Concluzie
Pentru a finaliza corect procesul, așteptăm următoarele comportamente de la aplicație:
- Să aștepte câteva secunde, după care să nu mai accepte noi conexiuni.
- Să aștepte finalizarea tuturor cererilor și să închidă toate conexiunile keepalive, care nu execută cererile.
- Să își finalizeze procesul.
Totuși, nu toate aplicațiile știu să funcționeze astfel. Una dintre soluțiile problemei în realitatea Kubernetes este:
- adică adăugarea unui hook pre-stop, care va aștepta câteva secunde;
- analizarea fișierului de configurare al backend-ului nostru pentru parametrii corespunzători.
Exemplul cu NGINX permite să înțelegem că chiar și aplicația care ar trebui inițial să răspundă corect la semnalele de finalizare poate să nu o facă, de aceea este critic să verificăm existența erorilor 500 în timpul desfășurării aplicației. De asemenea, permite să privim problema dintr-o perspectivă mai largă și să nu ne concentrăm pe un singur pod sau container, ci să privim întreaga infrastructură în ansamblu.
Ca instrument de testare, se poate folosi Yandex.Tank împreună cu orice sistem de monitorizare (în cazul nostru, pentru test, am folosit date din Grafana cu backend-ul Prometheus). Problemele cu oprirea grațioasă sunt bine vizibile la încărcări mari, pe care le poate genera benchmark-ul, iar monitorizarea ajută la detalierea situației în timpul sau după test.
Răspunzând feedback-ului referitor la articol: se poate menționa că problemele și soluțiile acestora sunt descrise în mod special pentru NGINX Ingress. Pentru alte cazuri există alte soluții, pe care, poate, le vom analiza în materialele următoare ale ciclului.
P.S.
Altceva din ciclul K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
