

Acum ceva timp, ne-am confruntat cu întrebarea alegerii unui instrument ETL pentru lucrul cu Big Data. Soluția anterioară, Informatica BDM, nu ne-a satisfăcut din cauza funcționalității sale limitate. Folosirea ei s-a redus la un cadru pentru lansarea comenzilor spark-submit. Pe piață nu erau multe alternative capabile să lucreze cu volumul de date cu care ne confruntăm zilnic. În cele din urmă, am ales Ab Initio. În timpul demonstrațiilor pilot, produsul a arătat o viteză de procesare a datelor foarte mare. Informațiile despre Ab Initio în limba română sunt aproape inexistente, așa că am decis să împărtășim experiența noastră pe Habr.
Ab Initio dispune de numeroase transformări clasice și neobișnuite, codul acestora putând fi extins folosind propriul limbaj PDL. Pentru micile afaceri, un instrument atât de puternic va fi probabil excesiv, iar majoritatea funcționalităților sale ar putea fi costisitoare și nefolosite. Dar dacă dimensiunile afacerii tale se apropie de cele ale Sberbank, atunci Ab Initio îți poate fi de interes.
Acesta ajută afacerile să acumuleze global cunoștințe și să dezvolte un ecosistem, oferindu-le dezvoltatorilor ocazia de a-și îmbunătăți abilitățile în ETL, de a beneficia de cunoștințe în shell, oferind posibilitatea de a învăța limbajul PDL, oferind o imagine vizuală a proceselor de încărcare și facilitând dezvoltarea datorită abundenței componentelor funcționale.
În acest post, voi vorbi despre posibilitățile Ab Initio și voi prezenta caracteristici comparative ale performanței sale în lucrul cu Hive și GreenPlum.
- Descrierea cadrului MDW și lucrările de ajustare a acestuia pentru GreenPlum
- Caracteristici comparative ale performanței Ab Initio în lucrul cu Hive și GreenPlum
- Utilizarea Ab Initio cu GreenPlum în modul Near Real Time
Funcționalitatea acestui produs este foarte vastă și necesită timp considerabil pentru a fi învățată. Cu toate acestea, cu abilitățile de lucru adecvate și configurații corecte ale performanței, rezultatele procesării datelor sunt destul de impresionante. Folosirea Ab Initio poate oferi dezvoltatorului o experiență interesantă. Este o nouă viziune asupra dezvoltării ETL, un hibrid între un mediu vizual și dezvoltarea încărcărilor într-un limbaj similar cu scripturile.
Afacerea își dezvoltă ecosistemele, iar acest instrument se dovedește mai util ca niciodată. Cu ajutorul Ab Initio, se pot acumula cunoștințe despre afacerea curentă și folosi aceste cunoștințe pentru a extinde afacerile vechi și a deschide altele noi. Printre alternativele Ab Initio se numără mediile de dezvoltare vizuală Informatica BDM și mediile non-vizuale – Apache Spark.
Descrierea Ab Initio
Ab Initio, ca și alte instrumente ETL, reprezintă un set de produse.
Ab Initio GDE (Graphical Development Environment) este mediu pentru dezvoltatori, în care aceștia configurează transformările de date și le conectează prin fluxuri de date sub formă de săgeți. Astfel, acest set de transformări este denumit grafic:
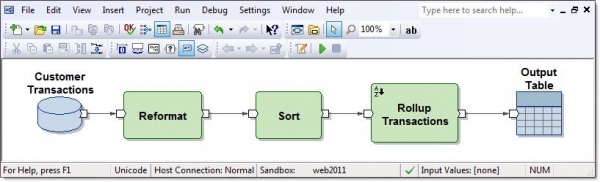
Conexiunile de intrare și ieșire ale componentelor funcționale sunt porturi și conțin câmpuri calculate în interiorul transformărilor. Mai multe grafice conectate prin fluxuri de săgeți în ordinea execuției lor se numesc plan.
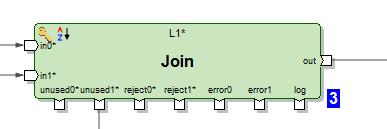
Există câteva sute de componente funcționale, ceea ce este foarte mult. Multe dintre ele sunt specializate. Capacitățile transformărilor clasice în Ab Initio sunt mai extinse decât în alte instrumente ETL. De exemplu, Join are mai multe ieșiri. Pe lângă rezultatul conectării seturilor de date, se pot obține și înregistrările seturilor de date de intrare pentru cheile care nu au putut fi conectate. De asemenea, se pot obține rejects, errors și jurnalul de lucru al transformării, care poate fi citit în același grafic ca un fișier text și procesat prin alte transformări:
De asemenea, se poate materializa receptorul de date sub formă de tabel și, în același grafic, se pot citi datele din acesta.
Există transformări originale. De exemplu, transformarea Scan are funcționalitate similară cu funcțiile analitice. Există transformări cu denumiri sugestive: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB etc. Graficele pot folosi parametrii de execuție, inclusiv este posibilă transmisia parametrilor din sistemul de operare sau către sistemul de operare. Fișierele cu seturile de parametrii transmise graficului se numesc parameter sets (psets).
Așa cum este firesc, Ab Initio GDE are propriul său depozit, numit EME (Enterprise Meta Environment). Dezvoltatorii au posibilitatea de a lucra cu versiuni locale ale codului și de a face check in al dezvoltărilor lor în depozitul central.
Există posibilitatea, în timpul sau după execuția graficului, să faci clic pe orice conexiune care leagă transformările fluxului și să vizualizezi datele care au trecut între aceste transformări:
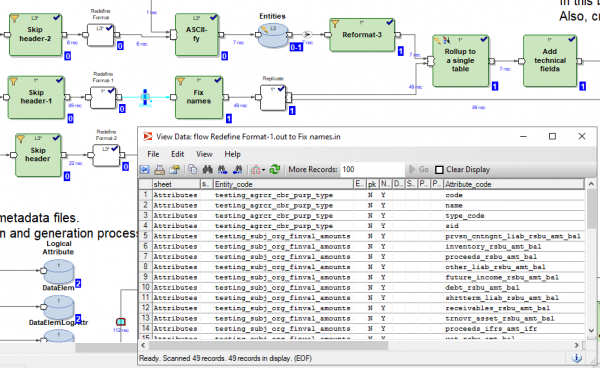
De asemenea, există posibilitatea de a face clic pe orice flux și a vizualiza detaliile de urmărire – câte paralele au funcționat în transformare, câte linii și câte bite au fost încărcate în fiecare din paralele respective:
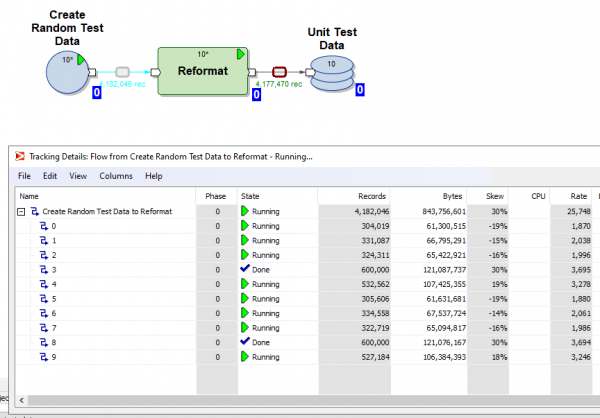
Este posibil să împărți execuția graficului în faze și să marchezi ce transformări trebuie să fie efectuate mai întâi (în faza zero), următoarele în faza întâi, următoarele în faza a doua și așa mai departe.
Fiecare transformare permite alegerea unui așa-numit layout (unde va fi executată): fără paralele sau în fluxuri paralele, numărul cărora poate fi specificat. De asemenea, fișierele temporare create de Ab Initio în timpul execuției transformărilor pot fi plasate fie în sistemul de fișiere server, fie în HDFS.
În fiecare transformare, pe baza șablonului implicit, poți crea propriul script în limbajul PDL, care se aseamănă oarecum cu shell-ul.
Folosind limbajul PDL, poți extinde funcționalitatea transformărilor și, în special, poți genera dinamic (în timpul execuției) fragmente de cod arbitrare în funcție de parametrii de execuție.
De asemenea, în Ab Initio integrarea cu sistemul de operare prin shell este bine dezvoltată. Concret, în Sberbank se folosește linux ksh. Se pot schimba variabile cu shell-ul și le poți folosi ca parametrii pentru grafuri. Este posibil să apelezi execuția graficelor Ab Initio din shell și să administrezi Ab Initio.
Pe lângă Ab Initio GDE, livrarea include multe alte produse. Există propriul Co>Operation System care se pretinde a fi un sistem de operare. Există Control>Center, unde poți programa și monitoriza fluxurile de încărcare. Există produse pentru dezvoltare la un nivel mai primitiv decât permite Ab Initio GDE.
Descrierea cadrului MDW și lucrările de ajustare a acestuia pentru GreenPlum
Împreună cu produsele sale, furnizorul oferă produsul MDW (Metadata Driven Warehouse), care este un configurator de grafuri, destinat să ajute în sarcinile tipice de umplere a depozitelor de date sau data vaults.
Acesta conține parseri de metadate personalizați (specifice pentru proiect) și generatoare de cod gata făcute 'din cutie'.
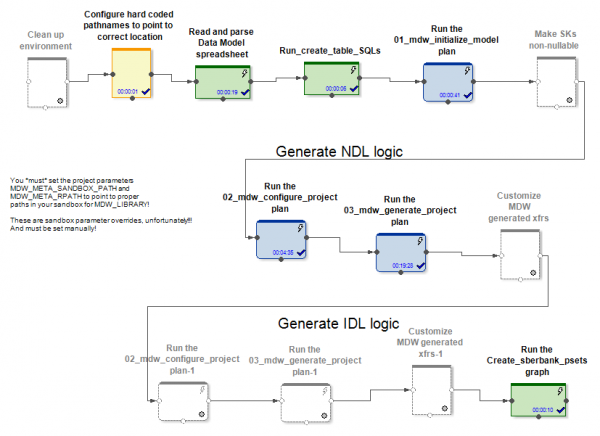
La intrare, MDW primește un model de date, un fișier de configurație pentru setările de conexiune cu baza de date (Oracle, Teradata sau Hive) și alte setări suplimentare. Partea specifică proiectului, de exemplu, desfășoară modelul în baza de date. Partea standard a produsului generează grafice și fișiere de configurare pentru acestea la încărcarea datelor în tabelele modelului. Astfel, graficile (și psets) sunt create pentru mai multe moduri de lucru inițial și incremental pentru actualizarea entităților.
În cazurile Hive și RDBMS, se generează grafice diferite pentru actualizarea inițială și incrementală a datelor.
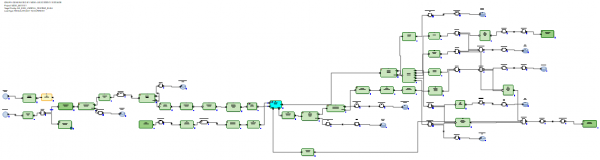
În cazul Hive, datele primite ale delta sunt unite prin Ab Initio Join cu datele existente în tabel înainte de actualizare. Încărcătoarele de date în MDW (atât în Hive, cât și în RDBMS) nu doar că introduc datele noi din delta, dar și închid perioadele de valabilitate a datelor, în funcție de cheile primare asociate cu delta primită. În plus, este necesar să se rescrie partea de date care nu s-a modificat. Asta trebuie făcut, deoarece în Hive nu există operații de ștergere sau actualizare.
În cazul RDBMS, graficele de actualizare incrementală a datelor arată mai optim, deoarece RDBMS au capacități reale de actualizare.
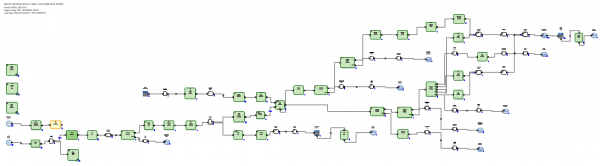
Delta primită este încărcată într-un tabel intermediar în baza de date. Ulterior, delta este conectată cu datele care existau în tabel înainte de actualizare. Aceasta se realizează prin intermediul SQL, utilizând o interogare SQL generată. Apoi, cu ajutorul comenzilor SQL delete+insert, datele noi din delta sunt inserate în tabelul țintă și sunt închise perioadele de valabilitate a datelor, în funcție de cheile primare asociate cu delta primită.
Nu este necesar să rescriem datele neschimbate.
Astfel, ajungem la concluzia că în cazul Hive, MDW trebuie să rescrie întreaga tabelă, deoarece Hive nu are funcția de actualizare. Și nu există nimic mai bun decât rescrierea completă a datelor în timpul actualizării. În schimb, în cazul RDBMS, creatorii produsului au considerat că este necesar să încredințeze conectarea și actualizarea tabelelor utilizării SQL.
Pentru proiectul din Sberbank, am creat o nouă implementare reutilizabilă a loader-ului de baze de date pentru GreenPlum. Aceasta a fost realizată pe baza versiunii generate de MDW pentru Teradata. Teradata, și nu Oracle, s-a dovedit a fi mai potrivită, deoarece este de asemenea un sistem MPP. Modalitățile de operare, precum și sintaxa Teradata și GreenPlum s-au dovedit a fi asemănătoare.
Exemplu de diferențe critice pentru MDW între diferite RDBMS sunt următoarele. În GreenPlum, spre deosebire de Teradata, la crearea tabelelor trebuie să scrii clauza
distributed byÎn Teradata scrii
delete <table> all, iar în GreenPlum scrii
şterge din <table>În Oracle, în scopuri de optimizare se scrie
delete from t where rowid in (), iar în Teradata și GreenPlum se scrie
delete from t where exists (select * from delta where delta.pk=t.pk)De asemenea, să menționăm că pentru a funcționa Ab Initio cu GreenPlum a fost necesar să instalăm clientul GreenPlum pe toate nodurile clusterului Ab Initio. Acest lucru se datorează faptului că ne-am conectat la GreenPlum simultan de pe toate nodurile clusterului nostru. Iar pentru ca citirea din GreenPlum să fie paralelă și fiecare fir paralel Ab Initio să citească porțiunea sa de date din GreenPlum, a fost necesar să includem în secțiunea „where” a interogărilor SQL o construcție înțeleasă de Ab Initio
where ABLOCAL()și să definim valoarea acestei construcții, specificând în parametrul de transformare care citește din baza de date
ablocal_expr="string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))", care se compilează într-un ceva de genul
mod(sk,10)=3, adică este necesar să specificăm explicit GreenPlum filtrul pentru fiecare partiție. Pentru alte baze de date (Teradata, Oracle), Ab Initio poate realiza această paralelizare automat.
Caracteristici comparative ale performanței Ab Initio în lucrul cu Hive și GreenPlum
În Sberbank a fost efectuat un experiment comparativ al performanței graficelor generate de MDW în raport cu Hive și GreenPlum. În cadrul experimentului, în cazul Hive au fost 5 noduri în același cluster cu Ab Initio, iar în cazul GreenPlum au fost 4 noduri într-un cluster separat. Astfel, Hive a avut un anumit avantaj „hardware” față de GreenPlum.
Au fost analizate două perechi de grafice care îndeplinesc aceeași sarcină de actualizare a datelor în Hive și GreenPlum. În acest context s-au rulat graficele generate de configuratorul MDW:
- încărcare inițială + încărcare incrementală a datelor generate aleatoriu în tabelul Hive
- încărcare inițială + încărcare incrementală a datelor generate aleatoriu în un tabel similar GreenPlum
În ambele cazuri (Hive și GreenPlum), au fost rulate încărcări în 10 fluxuri paralele pe același cluster Ab Initio. Datele intermediare pentru calculele Ab Initio au fost stocate în HDFS (în termenii Ab Initio a fost folosit layout MFS folosind HDFS). O linie de date generate aleatoriu ocupa în ambele cazuri câte 200 de biți.
Rezultatul a fost următorul:
Hive:
Încărcare inițială în Hive
Linii inserate
6 000 000
60 000 000
600 000 000
Durata încărcării inițiale
în secunde
41
203
1 601
Încărcare incrementală în Hive
Numărul de linii, existente în
tabelul țintă la începutul experimentului
6 000 000
60 000 000
600 000 000
Numărul de linii delta, aplicate în
tabelul țintă pe parcursul experimentului
6 000 000
6 000 000
6 000 000
Durata încărcării incrementale
în secunde
88
299
2 541
GreenPlum:
Încărcare inițială în GreenPlum
Linii inserate
6 000 000
60 000 000
600 000 000
Durata încărcării inițiale
în secunde
72
360
3 631
Încărcare incrementală în GreenPlum
Numărul de linii, existente în
tabelul țintă la începutul experimentului
6 000 000
60 000 000
600 000 000
Numărul de linii delta, aplicate în
tabelul țintă pe parcursul experimentului
6 000 000
6 000 000
6 000 000
Durata încărcării incrementale
în secunde
159
199
321
Observăm că viteza încărcării inițiale atât în Hive, cât și în GreenPlum depinde liniar de volumul de date și, din cauze legate de hardware superior, aceasta este puțin mai rapidă pentru Hive decât pentru GreenPlum.
Încărcarea incrementală în Hive depinde de asemenea liniar de volumul datelor din tabelul țintă care au fost încărcate anterior și se desfășoară destul de lent odată cu creșterea volumului. Acest lucru este cauzat de necesitatea de a rescrie complet tabelul țintă. Asta înseamnă că aplicarea unor modificări mici la tabele imense nu este o variantă foarte bună de utilizare în Hive.
Încărcarea incrementală în GreenPlum depinde slab de volumul datelor deja existente în tabelul țintă și se desfășoară destul de rapid. Acest lucru s-a realizat datorită SQL Joins și arhitecturii GreenPlum, care permite operația delete.
Astfel, GreenPlum introduce delta prin metoda delete+insert, în timp ce în Hive nu există operații delete sau update, așa că întregul set de date la actualizarea incrementală a fost obligat să fie rescris complet. Cea mai reprezentativă este comparația celulelor marcate cu bold, deoarece aceasta corespunde celei mai frecvente variante de exploatare a încărcărilor consumatoare de resurse. Vedem că GreenPlum a învins Hive în acest test cu 8 ori.
Utilizarea Ab Initio cu GreenPlum în modul Near Real Time
În acest experiment vom verifica capacitatea Ab Initio de a actualiza tabelul GreenPlum cu porțiuni de date generate aleatoriu într-un mod apropiat de real-time. Vom lua în considerare tabelul GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, cu care se va lucra.
Vom folosi trei grafuri Ab Initio pentru a lucra cu acesta:
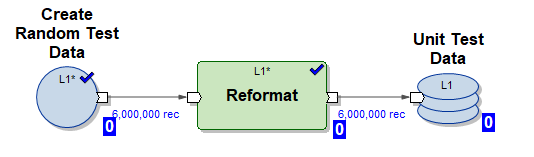
1) Graf Create_test_data.mp – generează fișiere de date în HDFS cu 6.000.000 de rânduri folosind 10 fire paralele. Datele sunt generate aleatoriu, structura lor este organizată pentru inserarea în tabelul nostru
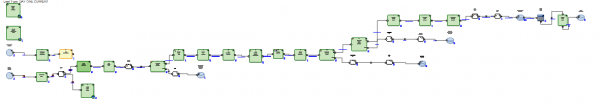
2) Graf mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – grafic MDW generat pentru inserția inițială a datelor în tabelul nostru folosind 10 fire paralele (se folosesc date de test generate de graficul (1))
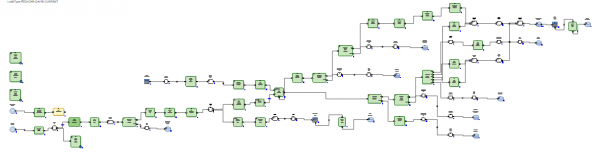
3) Graf mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – grafic MDW generat pentru actualizarea incrementală a tabelului nostru folosind 10 fire paralele cu o porție de date proaspete (delta) generate de graficul (1)
Vom executa scenariul de mai jos în modul NRT:
- generează 6.000.000 de rânduri de test
- efectuează încărcarea inițială, inserând 6.000.000 de rânduri de test în tabelul gol
- repetă de 5 ori încărcarea incrementală
- generează 6.000.000 de rânduri de test
- efectuează inserția incrementală a 6.000.000 de rânduri de test în tabel (datele vechi primesc un timp de expirare valid_to_ts și se inserează date mai recente cu aceeași cheie primară)
Acest scenariu emulează modul de funcționare real al unui sistem de afaceri – o porție considerabilă de date noi apare în timp real și este imediat încorporată în GreenPlum.
Acum să vedem log-ul lucrului din scenariu:
Start Create_test_data.input.pset at 2020-06-04 11:49:11
Finish Create_test_data.input.pset at 2020-06-04 11:49:37
Start mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:49:37
Finish mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:50:42
Start Create_test_data.input.pset at 2020-06-04 11:50:42
Finish Create_test_data.input.pset at 2020-06-04 11:51:06
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:51:06
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:53:41
Start Create_test_data.input.pset at 2020-06-04 11:53:41
Finish Create_test_data.input.pset at 2020-06-04 11:54:04
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:54:04
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:56:51
Start Create_test_data.input.pset at 2020-06-04 11:56:51
Finish Create_test_data.input.pset at 2020-06-04 11:57:14
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:57:14
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:59:55
Start Create_test_data.input.pset at 2020-06-04 11:59:55
Finish Create_test_data.input.pset at 2020-06-04 12:00:23
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:00:23
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:23
Start Create_test_data.input.pset at 2020-06-04 12:03:23
Finish Create_test_data.input.pset at 2020-06-04 12:03:49
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:49
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:06:46
Rezultatul este următorul:
Grafic
Start time
Timp de finalizare
Lungime
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Se observă că 6 000 000 de înregistrări sunt procesate în 3 minute, ceea ce este destul de rapid.
Datele din tabela țintă au fost distribuite astfel:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 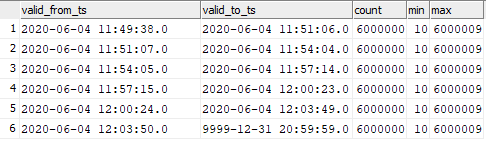
Se poate observa corespondența datelor introduse cu momentele de lansare ale graficelor.
Asta înseamnă că putem rula în Ab Initio încărcarea incrementală a datelor în GreenPlum cu o frecvență foarte mare și putem observa o viteză ridicată de inserare a acestor date în GreenPlum. Desigur, nu va fi posibil să se execute la fiecare secundă, deoarece Ab Initio, asemenea oricărei soluții ETL, necesită timp „pentru a porni”.
Concluzie
În prezent, Ab Initio este utilizat de Sberbank pentru construirea unei versiuni unificate a stratului semantic de date (ESS). Acest proiect implică crearea unei versiuni unice a stării diferitelor entități de afaceri bancare. Informațiile provin din diverse surse, replicile acestora fiind pregătite pe Hadoop. În funcție de nevoile afacerii, se pregătește un model de date și se descriu transformările datelor. Ab Initio încarcă informațiile în ESS, iar datele încărcate nu sunt doar de interes pentru afacere, ci servesc și ca sursă pentru construcția vitrinelor de date. Funcționalitatea produsului permite utilizarea ca receptor a diverselor sisteme (Hive, Greenplum, Teradata, Oracle), ceea ce oferă posibilitatea de a pregăti datele pentru afacere în diferite formate necesare fără eforturi mari.
Capacitățile Ab Initio sunt largi, de exemplu, cadrul MDW inclus permite construirea istoricului tehnic și de afaceri al datelor „din cutie”. Pentru dezvoltatori, Ab Initio oferă posibilitatea de a „nu reinventa roata”, ci de a folosi numeroasele componente funcționale existente, care sunt, practic, biblioteci necesare în munca cu datele.
Autorul — expert în comunitatea profesională Sberbank SberProfi DWH/BiData. Comunitatea profesională SberProfi DWH/BiData este responsabilă pentru dezvoltarea competențelor în domenii precum ecosistemul Hadoop, Teradata, Oracle DB, GreenPlum și instrumentele BI Qlik, SAP BO, Tableau, etc.
Sursa: habr.com
