

DataHub cu sursă deschisă: platforma de căutare și descoperire a metadatelor de la LinkedIn
Căutarea rapidă a datelor necesare este esențială pentru orice companie care se bazează pe o cantitate mare de date pentru a lua decizii bazate pe acestea. Aceasta influențează nu doar productivitatea utilizatorilor de date (inclusiv analiști, dezvoltatori de învățare automată, specialiști în procesarea datelor și ingineri de date), ci are și un impact direct asupra produselor finale care depind de un pipeline de învățare automată (ML) de calitate. În plus, tendința de a adopta sau crea platforme de învățare automată ridică inevitabil întrebarea: care este metoda voastră de descoperire internă a caracteristicilor, modelelor, metricilor, seturilor de date etc.
În acest articol, vă vom povesti despre modul în care am publicat o sursă de date sub o licență deschisă în platforma noastră de căutare și descoperire a metadatelor, începând cu primele zile ale proiectului . LinkedIn susține o versiune proprie a DataHub, diferită de versiunea open-source. Vom începe prin a explica de ce avem nevoie de două medii de dezvoltare separate, după care vom discuta primele abordări pentru utilizarea WhereHows open-source și vom face o comparație între versiunea noastră internă (de producție) a DataHub și versiunea de . Vom împărtăși, de asemenea, detalii despre noua noastră soluție automatizată pentru trimiterea și primirea actualizărilor open-source, pentru a sincroniza cele două repozitorii. În final, vom oferi instrucțiuni despre cum să începeți utilizarea DataHub open-source și vom discuta pe scurt despre arhitectura sa.
WhereHows este acum DataHub!
Echipa de metadate LinkedIn a prezentat anterior (succesorul WhereHows), platforma de căutare și descoperire a metadatelor LinkedIn și a împărtășit planurile de a o deschide. La scurt timp după această anunțare, am lansat versiunea alfa a DataHub și am împărtășit-o cu comunitatea. De atunci, am contribuit constant la repozitoriu și am colaborat cu utilizatorii interesați pentru a adăuga cele mai solicitate funcții și a rezolva problemele. Acum, suntem încântați să anunțăm lansarea oficială .
Abordări open-source
WhereHows, portalul original LinkedIn pentru căutarea datelor și a originii lor, a fost deschis ca un proiect intern; echipa de metadate l-a deschis . De atunci, echipa a susținut întotdeauna două baze de cod diferite - una pentru sursa deschisă și alta pentru utilizarea internă a LinkedIn, deoarece nu toate funcțiile produsului dezvoltate pentru utilizările LinkedIn au fost în mod general aplicabile unei audiențe mai largi. În plus, WhereHows are anumite dependențe interne (infrastructură, biblioteci etc.), a căror sursă de cod nu este deschisă. În anii care au trecut, WhereHows a trecut prin numeroase iterații și cicluri de dezvoltare, ceea ce a făcut sincronia celor două baze de cod o mare provocare. Echipa de metadate a încercat de-a lungul anilor diferite abordări pentru a sincroniza dezvoltarea internă cu cea de sursă deschisă.
Prima încercare: „Începe cu sursa deschisă”
Inițial, am urmat un model de dezvoltare „începe cu sursa deschisă”, unde dezvoltarea principală are loc în depozitul cu sursă deschisă, iar modificările sunt făcute pentru desfășurarea internă. Problema cu această abordare este că codul este întotdeauna trimis pe GitHub înainte de a fi complet verificat intern. Până la aplicarea modificărilor din depozitul cu sursă deschisă și până la desfășurarea internă nouă, nu vom descoperi problemele de producție. În cazul unui desfășurări proaste, a fost de asemenea foarte dificil de identificat vinovatul, deoarece modificările erau făcute pe loturi.
În plus, acest model a redus productivitatea echipei în dezvoltarea de noi funcții care necesitau iterații rapide, deoarece impunea ca toate modificările să fie mai întâi plasate în depozitul cu sursă deschisă, iar apoi transferate în depozitul intern. Pentru a reduce timpul de procesare, o corectare sau modificare necesară putea fi făcută mai întâi în depozitul intern, dar aceasta a devenit o problemă uriașă atunci când a venit vorba de reunirea acestor modificări înapoi în depozitul cu sursă deschisă, deoarece cele două depozite s-au dezacordat.
Această model este mult mai ușor de realizat pentru platforme comune, biblioteci sau proiecte infrastructurale, decât pentru aplicații web complete destinate utilizatorilor. În plus, acest model este ideal pentru proiecte care încep cu cod sursă deschis încă din prima zi, dar WhereHows a fost creat ca o aplicație web complet internă. A fost cu adevărat greu să ne abținem complet de la toate dependențele interne, așa că a trebuit să păstrăm un fork intern, dar păstrarea acestui fork și dezvoltarea în principal cu cod sursă deschis nu a funcționat foarte bine.
A doua încercare: „Intern mai întâi”
** Ca a doua încercare, am trecut la modelul de dezvoltare „intern mai întâi”, în care dezvoltarea principală are loc în cadrul companiei, iar modificările sunt aduse la codul sursă deschis pe o bază regulată. Deși acest model se potrivește cel mai bine pentru cazul nostru de utilizare, are propriile probleme. Trimiterea directă a tuturor diferențelor în depozitul de cod sursă deschis, apoi încercarea de a rezolva conflictele de fuziune mai târziu - este o opțiune, dar consumă mult timp. De obicei, dezvoltatorii evită să facă acest lucru la fiecare verificare de cod. Ca rezultat, aceasta va fi realizată mult mai rar, în loturi, și astfel îngreunează rezolvarea ulterioară a conflictelor de fuziune.
A treia oară, a reușit!
Cele două încercări nereușite menționate mai sus au dus la faptul că depozitul WhereHows pe GitHub a rămas învechit pentru o perioadă îndelungată. Echipa a continuat să îmbunătățească funcțiile și arhitectura produsului, astfel încât versiunea internă a WhereHows pentru LinkedIn devenea tot mai avansată decât versiunea cu cod sursă deschis. A avut chiar un nou nume - DataHub. Pe baza încercărilor nereușite anterioare, echipa a decis să dezvolte o soluție pe termen lung, scalabilă.
Pentru orice nou proiect cu cod sursă deschis, echipa de dezvoltare a codului sursă deschis de la LinkedIn consultă și sprijină un model de dezvoltare în care modulele proiectului sunt complet dezvoltate cu cod sursă deschis. Artefactele cu suport pentru versiuni sunt desfășurate într-un depozit public, iar apoi returnate în artefactul intern LinkedIn prin Urmarea acestui model de dezvoltare nu este doar benefică pentru cei care utilizează cod deschis, ci duce și la crearea unei arhitecturi mai modulare, extensibile și conectabile.
Cu toate acestea, pentru a atinge acest statut pentru o aplicație internă matură, cum ar fi DataHub, va fi necesar un timp considerabil. Aceasta exclude de asemenea posibilitatea unei implementări complet funcționale a codului deschis până când toate dependențele interne sunt complet abstractizate. Prin urmare, am dezvoltat instrumente care ne ajută să contribuim la codul deschis mai rapid și cu mult mai puțină durere. Această soluție este benefică atât pentru echipa de metadate (dezvoltatorul DataHub), cât și pentru comunitatea codului deschis. Următoarele secțiuni vor discuta această nouă abordare.
Automatizarea publicării cu cod deschis
Ultima abordare a grupului de metadate pentru DataHub cu cod deschis constă în dezvoltarea unui instrument care sincronizează automat baza de cod internă cu repository-ul de cod deschis. Funcțiile de nivel înalt ale acestui instrument includ:
- Sincronizarea codului LinkedIn din / în codul deschis, similar cu .
- Generarea titlului de licență, similar cu .
- Crearea automată a jurnalelor de angajamente cu cod deschis din jurnalul intern de angajamente.
- Prevenirea modificărilor interne care afectează compilarea cu cod deschis prin .
Următoarele subsecțiuni vor explora în detaliu funcțiile menționate anterior, care prezintă provocări interesante.
Sincronizarea codului sursă
Spre deosebire de versiunea DataHub cu cod deschis, care reprezintă un singur repository GitHub, versiunea DataHub pentru LinkedIn este o combinație a mai multor repository-uri (denumite în cadrul companiei ). Interfața DataHub, biblioteca de modele de metadate, serviciul de stocare a metadatelor și sarcinile de streaming se află în diferite repository-uri în LinkedIn. Cu toate acestea, pentru a facilita utilizarea codului deschis, avem un singur repository pentru versiunea DataHub cu cod deschis.
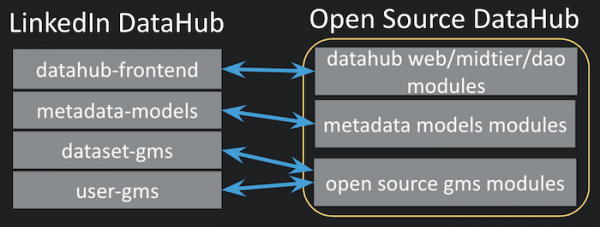
Fig. 1: Sincronizarea între repository-uri LinkedIn DataHub și repository-ul unic DataHub cu sursă deschisă
Pentru a susține procesele de lucru automate de construire, trimitere și extragere, noul nostru instrument creează automat un mapare la nivel de fișier, corespunzătoare fiecărui fișier sursă. Cu toate acestea, instrumentul necesită o configurare inițială, iar utilizatorii trebuie să furnizeze o mapare de nivel înalt a modulelor, așa cum este prezentat mai jos.
{
  "datahub-dao": [
    "${datahub-frontend}\/datahub-dao"
  ],
  "gms\/impl": [
    "${dataset-gms}\/impl",
    "${user-gms}\/impl"
  ],
  "metadata-dao": [
    "${metadata-models}\/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}\/metadata-builders"
  ]
}
Maparea la nivel de modul este un JSON simplu, ale cărui chei sunt modulele țintă din repository-ul open-source, iar valorile sunt o listă a modulelor sursă din repository-urile LinkedIn. Orice modul țintă din repository-ul open-source poate fi alimentat de un număr nelimitat de module sursă. Pentru a indica numele interne ale repository-urilor în modulele sursă, se utilizează în stil Bash. Folosind fișierul de mapare la nivel de modul, instrumentele creează un fișier de mapare la nivel de fișiere, scannând toate fișierele din directoarele asociate.
{
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}\/metadata-builders\/build.gradle": null,
}
Maparea la nivel de fișier este creată automat de instrumente; cu toate acestea, aceasta poate fi, de asemenea, actualizată manual de utilizator. Această mapare este 1:1 între fișierul sursă LinkedIn și fișierul din repository-ul open-source. Există câteva reguli asociate cu acest proces de creare automată a mapării fișierelor:
- În cazul mai multor module sursă pentru un modul țintă în open-source, pot apărea conflicte, de exemplu, același , care există în mai mult de un modul sursă. Ca strategie de rezolvare a conflictelor, instrumentele noastre folosesc implicit opțiunea „ultimul câștigă”.
- „null” înseamnă că fișierul sursă nu face parte din repository-ul open-source.
- După fiecare trimitere în codul sursă deschis sau extragerea acestuia, această corespondență se actualizează automat și se creează o captură de ecran. Acest lucru este necesar pentru a determina adăugările și eliminările din codul sursă după ultima acțiune.
Crearea jurnalelor de commit
Jurnalele de commit pentru commit-urile din codul sursă deschis sunt, de asemenea, generate automat prin combinarea jurnalelor de commit ale repositoarelor interne. Mai jos se află un exemplu de jurnal de commit pentru a ilustra structura jurnalului de commit generat de instrumentul nostru. Commit-ul indică clar ce versiuni ale repositoarelor sursă sunt incluse în acest commit și oferă un rezumat al jurnalului de commit. Verificați acest exemplu real de jurnal de commit generat de instrumentul nostru.
metadata-models 29.0.0 -> 30.0.0
    Modelul foo a fost adăugat
    Problema bar a fost rezolvată

dataset-gms 2.3.0 -> 2.3.4
    API-ul rest.li a fost adăugat pentru a servi modelul foo

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testarea dependențelor
LinkedIn dispune de , care ajută la garantarea faptului că modificările interne ale multi-produsului nu vor afecta construcția produselor dependente. Repositoul DataHub cu cod sursă deschis nu este un multi-produs, iar el nu poate fi o dependență directă a vreunui multi-produs, dar prin intermediul unei envoltori multi-produs care extrage codul sursă al DataHub-ului cu cod sursă deschis, putem folosi în continuare acest sistem de testare a dependențelor. Astfel, orice modificare (care va fi deschisă ulterior) a oricărui multi-produs care alimentează repositoul DataHub cu cod sursă deschis declanșează un eveniment de construcție în envoltura multi-produs. Prin urmare, orice modificare care nu permite construirea envolturii multi-produs nu trece testele înainte de commit-ul sursei multi-produsului și este returnată.
Acesta este un mecanism util care ajută la prevenirea oricărui commit intern care afectează construcția cu cod sursă deschis și îl detectează în timpul creării commit-ului. Fără acest mecanism, ar fi destul de dificil să se determine care commit intern a dus la eșecul construcției repositooului cu cod sursă deschis, deoarece introducem modificări interne în repositoul DataHub cu cod sursă deschis.
Diferențele dintre DataHub cu sursă deschisă și versiunea noastră de producție
Până acum, am discutat soluția noastră pentru sincronizarea celor două versiuni ale repositoarelor DataHub, dar nu am definit încă motivele pentru care avem nevoie de două fluxuri de dezvoltare diferite. În această secțiune, vom enumera diferențele dintre versiunea publică a DataHub și versiunea de producție pe serverele LinkedIn, precum și vom explica motivele acestor diferențe.
Una dintre sursele de discrepanță provine din faptul că versiunea noastră de producție are dependențe de cod cu sursă închisă, cum ar fi Offspring de la LinkedIn (infrastructura internă de gestionare a dependențelor LinkedIn). Offspring este folosit pe scară largă în baza de cod internă, deoarece este metoda preferată de gestionare a configurației dinamice. Dar nu este cu sursă deschisă; de aceea, a trebuit să căutăm alternative cu sursă deschisă pentru DataHub cu sursă deschisă.
Există și alte motive. Pe măsură ce dezvoltăm extensii pentru modelul de metadate pentru nevoile LinkedIn, aceste extensii sunt de obicei foarte specifice pentru LinkedIn și pot să nu se aplice direct altor medii. De exemplu, avem etichete foarte specifice pentru identificatorii participanților și alte tipuri de metadate de potrivire. Așadar, în prezent, am exclus aceste extensii din modelul de metadate al DataHub cu sursă deschisă. Pe măsură ce interacționăm cu comunitatea și înțelegem nevoile lor, vom lucra la versiuni comune ale acestor extensii cu sursă deschisă, acolo unde este necesar.
Ușurința de utilizare și adaptarea mai ușoară pentru comunitatea de sursă deschisă au inspirat de asemenea unele diferențe între cele două versiuni ale DataHub. Diferențele în infrastructura de procesare a fluxurilor sunt un bun exemplu în acest sens. Deși versiunea noastră internă folosește o infrastructură de procesare a fluxurilor gestionată, am decis să utilizăm procesarea fluxurilor încorporată (autonomă) pentru versiunea cu sursă deschisă, deoarece aceasta permite evitarea creării unei alte dependențe de infrastructură.
O altă exemplificare a diferenței este existența unui singur GMS (Sistem Generalizat de Metadate) în implementarea cu sursă deschisă, și nu a mai multor GMS-uri. GMA (Arhitectura Generalizată a Metadatelor) este numele arhitecturii interne pentru DataHub, iar GMS reprezintă stocarea metadatelor în contextul GMA. GMA este o arhitectură foarte flexibilă care permite distribuirea fiecărei construcții de date (de exemplu, seturi de date, utilizatori etc.) într-un depozit de metadate propriu sau stocarea mai multor construcții de date într-un singur depozit de metadate, atât timp cât registrul care conține maparea structurii de date în GMS este actualizat. Pentru a simplifica utilizarea, am ales un singur exemplu de GMS care stochează toate diferitele construcții de date în DataHub cu sursă deschisă.
Lista completă a diferențelor între cele două implementări este prezentată în tabelul de mai jos.
Caracteristicile produsului
LinkedIn DataHub
Open Source DataHub
Construcții de date suportate
1) Seturi de date 2) Utilizatori 3) Metrici 4) Funcții ML 5) Grafice 6) Panouri de control
1) Seturi de date 2) Utilizatori
Surse de metadate suportate pentru seturi de date
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Procesare prin flux
Gestionat
Încorporat (independent)
Injecție de dependență și configurare dinamică
LinkedIn Offspring
Instrumente de construcție
Ligradle (wrapper-ul intern Gradle de la LinkedIn)
CI/CD
CRT (CI/CD intern de la LinkedIn)
și
Magazine de metadate
GMS-uri distribuite multiple: 1) GMS pentru seturi de date 2) GMS pentru utilizatori 3) GMS pentru metrici 4) GMS pentru caracteristici 5) GMS pentru grafice/panouri de control
GMS unic pentru: 1) Seturi de date 2) Utilizatori
Microservicii în containere Docker
simplifică desfășurarea și distribuția aplicațiilor prin . Fiecare parte a serviciului în DataHub cu sursă deschisă, inclusiv componentele de infrastructură, cum ar fi Kafka, , și , are imaginea sa Docker proprie. Pentru orchestrarea containerelor Docker am folosit .
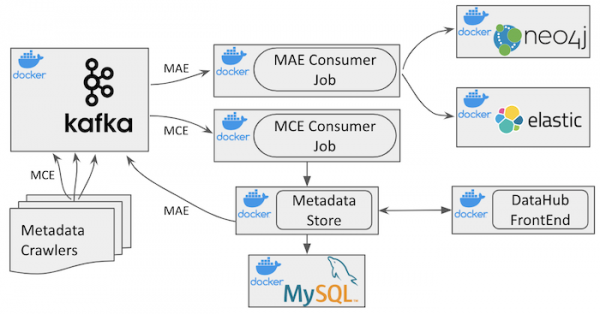
Figura 2: Arhitectura DataHub *cu sursă deschisă*
Puteți observa arhitectura la nivel înalt a DataHub în imaginea de mai sus. Pe lângă componentele de infrastructură, are patru containere Docker diferite:
datahub-gms: serviciul de stocare a metadatelor
datahub-frontend: aplicația , care oferă interfața DataHub.
datahub-mce-consumer: aplicația , care utilizează fluxul de evenimente de modificare a metadatelor (MCE) și actualizează stocarea metadatelor.
datahub-mae-consumer: aplicația , care utilizează fluxul de evenimente de audit al metadatelor (MAE) și creează o bază de date pentru indexul de căutare și grafic.
Documentația pentru repositoriul cu sursă deschisă și conțin informații mai detaliate despre funcțiile diverselor servicii.
CI / CD în DataHub cu sursă deschisă
Repository-ul DataHub cu sursă deschisă folosește pentru integrare continuă și pentru desfășurare continuă. Ambele au o bună integrare cu GitHub și sunt ușor de configurat. Pentru cea mai mare parte a infrastructurii cu sursă deschisă, dezvoltată de comunitate sau de companii private (de exemplu, ), sunt create imagini Docker, care sunt desfășurate în Docker Hub pentru a facilita utilizarea de către comunitate. Orice imagine Docker găsită în Docker Hub poate fi utilizată cu ușurință printr-o simplă comandă .
La fiecare commit în repository-ul cu sursă deschisă DataHub, toate imaginile Docker sunt create și desfășurate automat în Docker Hub cu eticheta „latest”. Dacă în Docker Hub este configurat un anumit , toate etichetele din repository-ul cu sursă deschisă sunt, de asemenea, eliberate cu denumirile corespunzătoare ale etichetelor în Docker Hub.
Utilizarea DataHub
este foarte simplă și constă în trei pași simpli:
- Clonați repository-ul cu sursă deschisă și rulați toate containerele Docker folosind docker-compose cu scriptul docker-compose furnizat pentru o lansare rapidă.
- Descărcați exemplele de date furnizate în repository folosind instrumentul de linie de comandă, care este de asemenea furnizat.
- Vizualizați DataHub în browserul dumneavoastră.
Un chat Gitter În prezent, fiecare infrastructură sau microserviciu pentru DataHub cu sursă deschisă este construit ca un container Docker, iar întregul sistem este orchestrat cu ajutorul
Planuri de viitor
. Având în vedere popularitatea și răspândirea acestuia, ne-am dori, de asemenea, să oferim o soluție bazată pe Kubernetes în viitorul apropiat. De asemenea, plănuim să oferim o soluție gata de utilizare pentru desfășurarea DataHub într-un serviciu cloud public, cum ar fi
. Având în vedere recentele anunțuri despre migrarea LinkedIn pe Azure, aceasta se va alinia cu prioritățile interne ale grupului de metadate. , sau . Учитывая недавнее объявление о миграции LinkedIn на Azure, это будет соответствовать внутренним приоритетам группы метаданных.
Și, nu în ultimul rând, mulțumim tuturor primilor utilizatori DataHub din comunitatea open-source, care au evaluat versiunile alfa ale DataHub și ne-au ajutat să identificăm problemele și să îmbunătățim documentația.
Sursa: habr.com
