

Primul lucru pe care trebuie să-l faci atunci când începi să lucrezi cu un nou set de date este să-l înțelegi. Pentru a face acest lucru, de exemplu, trebuie să afli domeniile valorilor acceptate de variabile, tipurile acestora, precum și să afli câte valori lipsă există.
Biblioteca pandas ne oferă numeroase instrumente utile pentru a efectua o analiză exploratorie a datelor (Exploratory Data Analysis, EDA). Însă, înainte de a le folosi, de obicei este necesar să începi cu funcții mai generale, cum ar fi df.describe(). Totuși, trebuie menționat că posibilitățile oferite de aceste funcții sunt limitate, iar etapele inițiale de lucru cu orice set de date în cadrul EDA sunt, foarte adesea, foarte asemănătoare între ele.
Autorul materialului pe care îl publicăm astăzi spune că nu este un fan al realizării acțiunilor repetitive. Ca urmare, el a găsit, în căutarea unor mijloace rapide și eficiente pentru a efectua analiza exploratorie a datelor, biblioteca . Rezultatele muncii sale nu sunt exprimate sub formă de rezultate individuale, ci sub formă de un raport HTML destul de detaliat, care conține cea mai mare parte a informațiilor despre datele analizate, de care ar putea fi nevoie înainte de a începe lucrul mai profund cu ele.
Aici vor fi discutate caracteristicile utilizării bibliotecii pandas-profiling pe un exemplu din setul de date Titanic.
Analiza exploratorie a datelor cu ajutorul pandas
Am decis să experimentez cu pandas-profiling pe setul de date Titanic datorită faptului că acesta conține date de diferite tipuri și că include valori lipsă. Consider că biblioteca pandas-profiling este deosebit de interesantă în cazurile în care datele nu sunt încă curățate și necesită procesare ulterioară, care depinde de caracteristicile lor. Pentru a efectua o astfel de procesare cu succes, trebuie să știi de unde să începi și la ce să acorzi atenție. Aici ne vor fi utile posibilitățile pandas-profiling.
Pentru început, să importăm datele și să folosim pandas pentru a obține statisticile descriptive:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
După rularea acestui fragment de cod, se va obține ceea ce este prezentat în următoarea ilustrație.
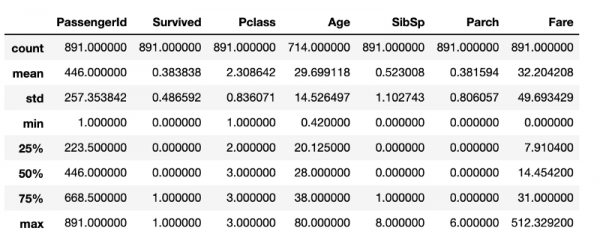
Statistici descriptive obținute cu ajutorul instrumentelor standard pandas
Deși aici există o mulțime de informații utile, nu sunt toate lucrurile interesante despre datele analizate. De exemplu, se poate presupune că în cadrul setului de date, în structură DataFrame, există 891 de rânduri. Dacă trebuie verificat, va fi necesară o altă linie de cod care să definească dimensiunea setului de date. Deși aceste calcule nu sunt foarte consumatoare de resurse, repetarea lor constantă va duce la pierderi de timp, care probabil ar fi mai bine cheltuite pentru curățarea datelor.
Analiza exploratorie a datelor folosind pandas-profiling
Acum vom face același lucru folosind pandas-profiling:
pandas_profiling.ProfileReport(df)Executarea liniei de cod de mai sus va permite generarea unui raport cu indicatorii analizei exploratorii a datelor. Codul prezentat mai sus va conduce la ieșirea informațiilor găsite despre date, însă se poate face astfel încât rezultatul să fie un fișier HTML, care, de exemplu, poate fi arătat cuiva.
Prima parte a raportului va conține secțiunea Overview (Prezentare generală), care oferă informații de bază despre date (numărul de observații, numărul de variabile și așa mai departe). De asemenea, va conține o listă de avertizări, informând analistul despre aspectele la care ar trebui să acorde o atenție deosebită. Aceste avertizări pot servi ca sugestii cu privire la ceea ce ar trebui să ne concentrăm în procesul de curățare a datelor.
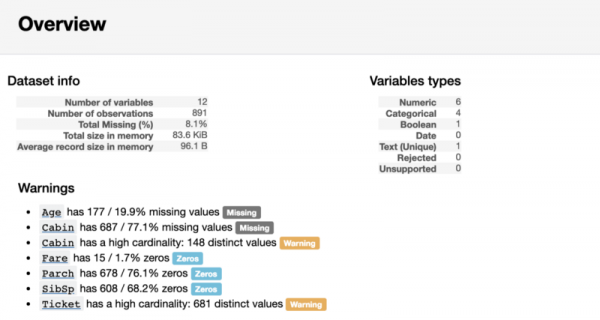
Secțiunea raportului Overview
Analiza exploratorie a variabilelor
După secțiunea Overview, în raport se pot găsi informații utile despre fiecare variabilă. Acestea includ, printre altele, diagrame mici care descriu distribuția fiecărei variabile.
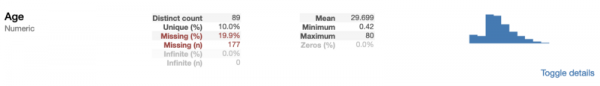
Informații despre variabila numerică Age
După cum se poate observa din exemplul anterior, pandas-profiling ne oferă câțiva indicatori utili, cum ar fi procentul și numărul de valori lipsă, precum și indicatorii de statistică descriptivă pe care i-am văzut deja. Deoarece Age este o variabilă numerică, vizualizarea distribuției sale sub formă de histogramă ne permite să concluzionăm că avem o distribuție asimetrică spre dreapta.
Atunci când analizăm o variabilă categorical, indicatorii furnizați diferă puțin de cei găsiți pentru o variabilă numerică.
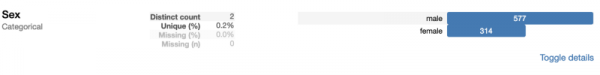
Informații despre variabila categorical Sex
Mai precis, în loc să calculeze media, minimul și maximul, biblioteca pandas-profiling a identificat numărul de clase. Asta deoarece Sex — o variabilă binară, valorile sale fiind reprezentate de două clase.
Dacă, la fel ca și mine, îți place să explorezi codul, s-ar putea să te intereseze cum anume biblioteca pandas-profiling calculează aceste statistici. Aflarea acestora, având în vedere că codul bibliotecii este deschis și disponibil pe GitHub, nu este chiar atât de dificilă. Deoarece nu sunt un mare fan al utilizării „cutiilor negre” în proiectele mele, am aruncat o privire asupra codului sursă al bibliotecii. De exemplu, iată cum arată mecanismul de procesare a variabilelor numerice, reprezentat de funcția :
def describe_numeric_1d(series, **kwargs):
    """Compute summary statistics of a numerical (`TYPE_NUM`) variable (a Series).
    Also create histograms (mini an full) of its distribution.
    Parameters
    ----------
    series : Series
        The variable to describe.
    Returns
    -------
    Series
        The description of the variable as a Series with index being stats keys.
    """
    # Format a number as a percentage. For example 0.25 will be turned to 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # To avoid to compute it several times
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # The dropna() is a workaround for https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histograms
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Deși acest fragment de cod poate părea destul de lung și complicat, în realitate, este foarte simplu de înțeles. Este vorba despre faptul că în codul sursă al bibliotecii există o funcție care determină tipurile de variabile. Dacă biblioteca întâlnește o variabilă numerică, funcția menționată anterior va găsi statisticile pe care le-am analizat. În această funcție se folosesc operații standard pandas pentru a lucra cu obiecte de tip Series, asemănătoare cu series.mean(). Rezultatele calculului sunt stocate într-un dicționar stats. Histogramele sunt generate folosind o versiune adaptată a funcției matplotlib.pyplot.histAdaptarea este destinată să permită funcției să funcționeze cu diferite tipuri de seturi de date.
Indicatori de corelare și eșantion de date studiate
După rezultatele analizei variabilelor din pandas-profiling, secțiunea Corelații va genera matricele de corelație Pearson și Spearman.
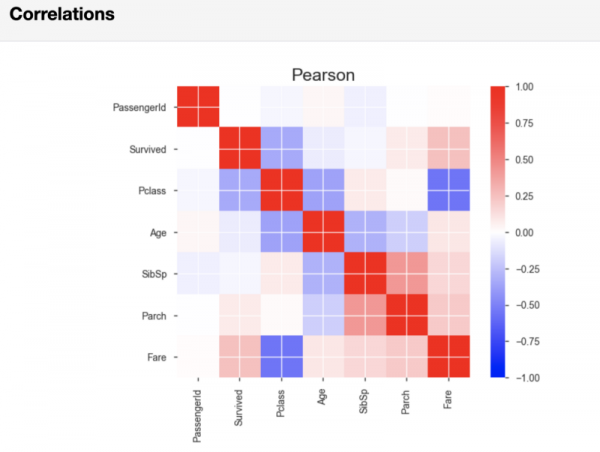
Matricea de corelație Pearson
Dacă este necesar, se pot stabili în acea linie de cod care lansează generarea raportului pragurile de valori aplicate la calculul corelației. Procedând astfel, puteți specifica care putere a corelației este considerată semnificativă pentru analiza dumneavoastră.
Și în final, în raportul pandas-profiling, în secțiunea Eșantion, se afișează, ca exemplu, un fragment de date luat din începutul setului de date. Această abordare poate duce la surprize neplăcute, deoarece primele câteva observații pot reprezenta un eșantion care nu reflectă specificitățile întregului set de date.
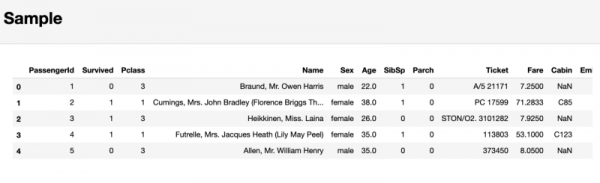
Secțiunea care conține eșantionul de date studiate
Prin urmare, nu recomand să acordați atenție acestei ultime secțiuni. În schimb, mai bine utilizați comanda df.sample(5), care va selecta aleatoriu 5 observații din setul de date.
Concluzii
Rezumând cele de mai sus, se poate observa că biblioteca pandas-profiling le oferă analiștilor câteva funcționalități utile, care sunt de mare ajutor în cazurile în care este necesar să obțineți rapid o imagine de ansamblu aproximativă a datelor sau să transmiteți cuiva un raport despre analiza exploratorie a datelor. În același timp, lucrul real cu datele, care ține cont de specificitățile lor, se face, așa cum s-ar proceda și fără pandas-profiling, manual.
Dacă doriți să vedeți cum arată întreaga analiză exploratorie a datelor într-un Jupyter notebook — consultați proiectul meu, creat cu nbviewer. Iar în repository-ul GitHub puteți găsi codul corespunzător.
Stimați cititori! De unde începeți analiza noilor seturi de date?
Sursa: habr.com
