

Algoritmi RAID so bili javnosti predstavljeni že leta 1987. Še danes ostajajo najbolj iskana tehnologija za zaščito in pospešitev dostopa do podatkov na področju shranjevanja informacij. A doba informacijske tehnologije, ki je presegla 30-letni mejnik, prej ni zrelost, ampak že starost. Razlog je napredek, ki neizogibno prinaša nove priložnosti. V času, ko praktično ni bilo drugih pogonov razen trdih diskov, so algoritmi RAID omogočali najučinkovitejšo uporabo razpoložljivih virov za shranjevanje. S pojavom SSD pa se je situacija močno spremenila. Zdaj je RAID pri delu s pogoni SSD že "zanka" za njihovo delovanje. Zato je za sprostitev celotnega potenciala hitrostnih lastnosti SSD-jev preprosto potreben popolnoma drugačen pristop k delu z njimi.
Poleg očitnih razlik med HDD in SSD v načelih delovanja imajo te vrste medijev še eno pomembno značilnost: kateri koli trdi disk lahko prepiše vse podatke z razdrobljenostjo enega bloka (zdaj je najpogosteje 4 KB). Za SSD je postopek prepisovanja veliko bolj zapleten postopek:
- Spremenjeni podatki se kopirajo na novo lokacijo. Hkrati je razdrobljenost enak blok, vendar je sestavljen iz več strani in ima velikost 256 KB - 4 MB. Tisti. pri spreminjanju istih 4KB je med drugim potrebno kopirati vse sosednje strani, ki tvorijo en blok.
- "Stari" bloki so označeni kot neuporabljeni, tako da jih je mogoče prepisati z zbiralnikom smeti.
Zaporedno pisanje/prepisovanje na SSD
V primeru zaporednega pisanja / prepisovanja ta lastnost delovanja SSD-ja ne igra velike vloge glede njegove zmogljivosti, ker. bloki so drug ob drugem, v ozadju pa svoje delo dobro opravlja pobiralec smeti. Toda v resničnem življenju, še bolj pa v segmentu Enterprise za SSD, se najpogosteje uporablja naključni dostop do podatkov. In ti podatki so zapisani na poljubna mesta na pogonih.
Več podatkov kot je zapisanih na SSD, težje deluje zbiralnik smeti, saj se fragmentacija močno poveča. Posledično pride trenutek, ko postopek čiščenja pogona preneha biti "ozadje": zmogljivost SSD-ja se znatno zmanjša, ker. opazen del zavzema Smetar.
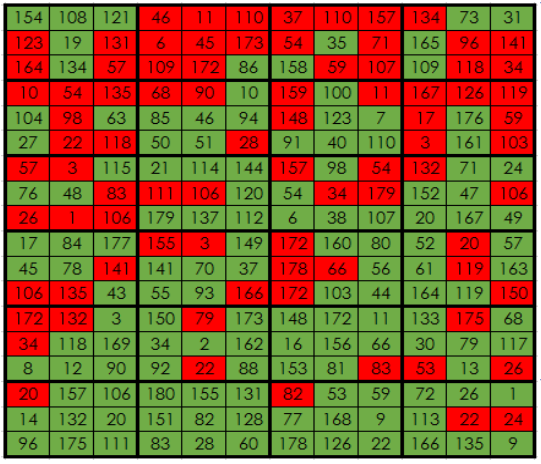
Dejanska lokacija podatkov na SSD v vsakodnevni uporabi
Za ponazoritev učinka dela "zbiralnika smeti" glede na način pisanja na pogon lahko izvedete najpreprostejše teste: zaporedno in naključno pisanje v 4KB blokih na 100GB pogon. (Vir - podjetje )
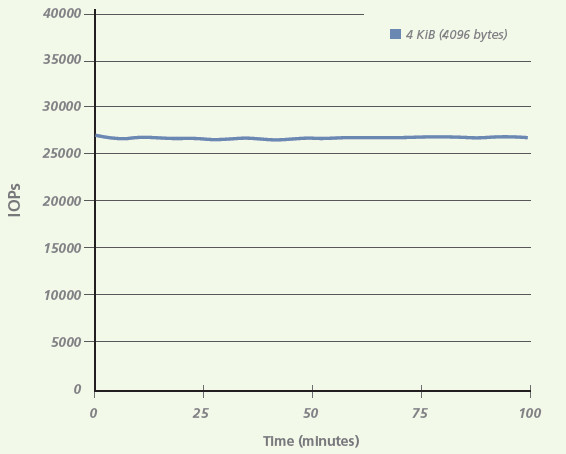
Zmogljivost zaporednega pisanja
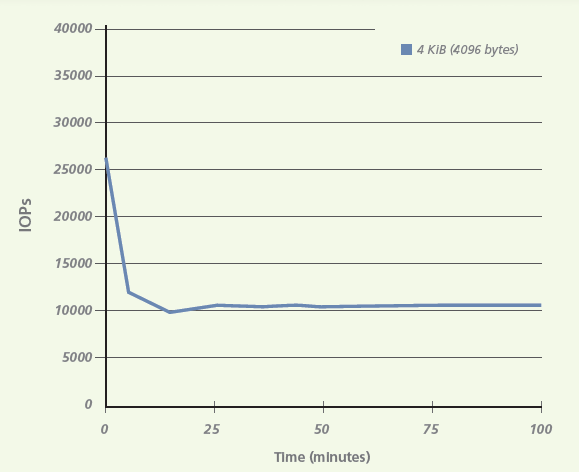
Zmogljivost naključnega pisanja
Kot je razvidno iz testov, lahko padec zmogljivosti doseže več kot dvakrat. In to je samo en pogon. V primeru uporabe SSD kot dela skupine RAID se zaradi dela s pariteto število operacij prepisovanja močno poveča.
Na splošno, zahvaljujoč tem značilnostim delovanja SSD, zanje obstaja tak parameter, kot je faktor ojačanja pisanja. To je razmerje med količino podatkov, zapisanih na pogon, in količino podatkov, ki jih dejansko pošlje gostitelj. Za najbolj priljubljen RAID5 je to razmerje ~3.5.
Posledica tega je, da sistemi s klasičnim RAID-om v bistvu uporabljajo SSD-je le ~10 % njihove dejanske hitrosti in se slabo prilagajajo zmogljivosti, ko se število pogonov poveča na več kot ducat.
Upoštevajte tudi, da pretirano zapisovanje ne samo zmanjša zmogljivost SSD-ja, ampak tudi zmanjša njegov daleč od neskončnega vira, s čimer se skrajša življenjska doba pogona.
, ki je jedro vseh izdelkov AccelStor, je zasnovan kot alternativa klasičnim RAID algoritmom pri delu s SSD diski. Inovativnost tehnologije zaznamujejo tako različni patenti in nagrade (tudi na Flash Memory Summit 2016) kot tudi rezultati neodvisnih testov (na primer SPC1).
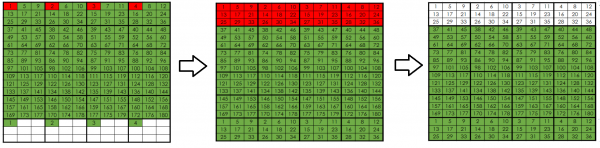
srce sestoji iz pretvorbe vseh dohodnih zahtev za pisanje, predvsem naključnega tipa, v nabor blokov, ki je z vidika pogona čim bolj podoben načinu zaporednega pisanja. Posledično pisanje na SSD diske poteka v zanje najbolj udobnem načinu, končna zmogljivost pa presega vsak sistem s klasičnim RAID-om.
Vsi SSD-ji v sistemih AccelStor so razdeljeni v dve simetrični skupini FlexiRemap®. Velikost skupine je odvisna od modela in je 5-11 pogonov. Za toleranco napak znotraj skupine se pariteta uporablja podobno kot RAID5. Obe skupini se uporabljata skupaj za oblikovanje skupnega prostora za shranjevanje. Zato bo posledična toleranca napak podobna matriki RAID50, sestavljeni iz dveh skupin: sistem lahko prenese okvaro do dveh SSD-jev, vendar ne več kot enega v vsaki skupini FlexiRemap®.
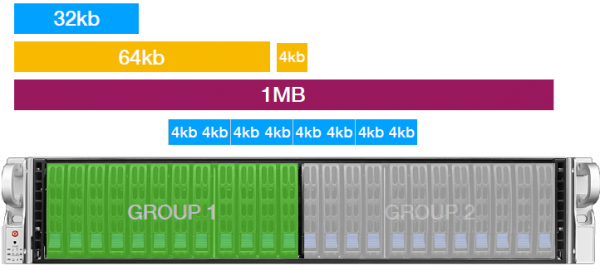
Vse dohodne zahteve za pisanje so razdeljene na 4KB bloke, ki se zapišejo v krožnem načinu v obe skupini FlexiRemap®. Hkrati sistem nenehno vodi evidenco povpraševanja po posnetih blokih, pri čemer poskuša podobne bloke zapisati čim bližje drug drugemu, ko se spreminjajo. Izkazalo se je, da je virtualni analog trganja, če se izrazi v smislu sistemov za shranjevanje. V tem primeru je delo "zbiralca smeti" močno olajšano: navsezadnje bodo neuporabljeni bloki vedno v bližini.
Opozoriti je treba, da je za razliko od izdelkov konkurence ne uporabljajo funkcionalnosti predpomnjenja dohodnih zahtev v RAM krmilnika. Vsi dohodni podatkovni bloki se takoj zapišejo na SSD. Gostitelj prejme potrditev uspešnega pisanja šele po fizični postavitvi podatkov na pogone. Samo tabele dodeljevanja blokov na SSD so shranjene v RAM, da pospešijo dostop in določijo, kam zapisati naslednji blok podatkov. Seveda so zaradi zanesljivosti kopije teh tabel na samem mediju. Posledično sistemi AccelStor ne potrebujejo nobene zaščite predpomnilnika baterije/kondenzatorja (vendar je možna komunikacija z UPS-om – za "mehko" zaustavitev v primeru težav z napajanjem).
Zahvaljujoč temu pristopu k organiziranju snemanja lahko zbiralnik smeti resnično deluje v ozadju, ne da bi bistveno vplival na hitrost pogonov, kar na koncu omogoča, da se znotraj sistema izkoristi do 90 % zmogljivosti SSD. To je ravno visoka zmogljivost IOPS v sistemih AccelStor v primerjavi z All Flash, ki temeljijo na algoritmih RAID.
Druga pomembna značilnost tehnologije FlexiRemap® je občutno zmanjšanje odvečnih zapisov na SSD. Tako je ojačanje pisanja za sisteme AccelStor le 1.3, kar prevedeno v običajni jezik pomeni podaljšanje življenjske dobe diskov v primerjavi z RAID5 za več kot 2.5-krat!
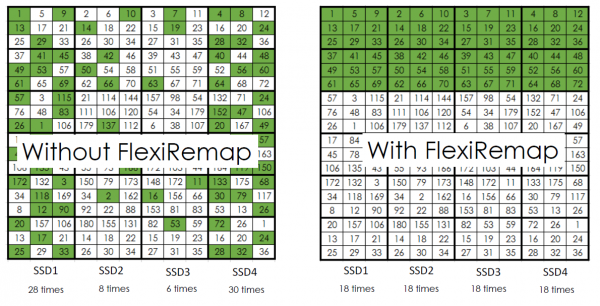
Zaradi stalnega sistemskega nadzora politike nameščanja podatkov na SSD se vsi diski obrabijo enako. Ta pristop omogoča predvidevanje njihove življenjske dobe in vnaprejšnje signaliziranje skrbniku o izčrpanosti snemalnega vira.
Jasno je, da SSD diski lahko odpovejo. V tem primeru se bo sistem takoj začel obnavljati na enega od vročih rezervnih diskov. V tem primeru skupina FlexiRemap®, ki je v degradiranem stanju, preide v način samo za branje, vse zahteve za pisanje pa so usmerjene v drugo skupino. Takšen zaščitni mehanizem je na voljo za pospešitev postopka obnove in zmanjšanje verjetnosti okvare drugega pogona znotraj iste skupine. Nobena skrivnost ni, da med obnovo vsi diski v skupini doživljajo povečano obremenitev zaradi motenj v operacijah branja, pisanja in obnavljanja na vročem rezervnem pomnilniku. To poveča verjetnost okvare drugega pogona. In več kot je pisalnih operacij, dlje bo trajala obnova.
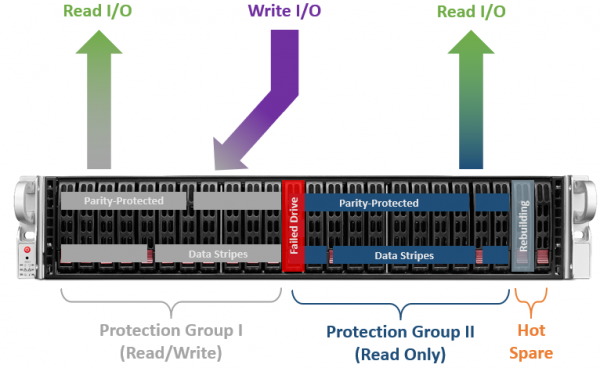
Ko je postopek ponovne izdelave končan in se skupina FlexiRemap® vrne v normalno stanje, bo med obema skupinama prišlo do rahlega poševnega vira pisanja. Da bi jo izenačili, bodo naslednje operacije pisanja pogosteje padle na obnovljeno skupino (seveda tako, da končna zmogljivost sistema ne trpi veliko).
Zmogljivosti sistemov All Flash, ki temeljijo na algoritmih RAID, ni mogoče povečati nad določene vrednosti (~280K IOPS@4K naključno pisanje), tudi če uporabljate zapletene sisteme predpomnjenja. Tehnologija FlexiRemap®, zahvaljujoč popolnoma drugačnemu pristopu k organiziranju prostora za shranjevanje, ne le zlahka premaga to oviro, ampak hkrati tudi večkrat podaljša življenjsko dobo SSD. Torej sistemi imajo pomembne prednosti med nizi All Flash na številnih frontah (IOPS/$, GB/$, TCO, ROI), zaradi česar so idealni kandidati za ključne položaje v podatkovnih centrih strank za reševanje nalog, ki zahtevajo veliko virov.
Vir: www.habr.com
