

V Badoo nenehno spremljamo nove tehnologije in ocenjujemo, ali jih je smiselno uporabiti v našem sistemu. Želimo deliti eno takšno raziskavo s skupnostjo. Posvečena je programu Loki – sistemu za zbiranje logov.
Loki je rešitev za shranjevanje in ogled logov, ta sveženj pa ponuja tudi fleksibilen sistem za njihovo analizo in pošiljanje podatkov v Prometheus. Maja je izšla nova različica, ki jo aktivno promovirajo ustvarjalci. Zanimalo nas je, kaj zna Loki, katere možnosti ponuja in v kolikšni meri lahko deluje kot alternativa ELK – svežnju, ki ga trenutno uporabljamo.
Kaj je Loki
Grafana Loki je niz komponent za popoln sistem dela z logi. V nasprotju z drugimi podobnimi sistemi Loki temelji na ideji indeksiranja samo metapodatkov logov – oznak (podobno kot v Prometheusu), medtem ko se sami logi stisnejo v ločene bloke.
,
Preden preidemo na opis, kaj lahko pričnemo delati s programom Loki, želim pojasniti, kaj pomeni "ideja indeksirati samo metapodatke". Primerjajmo pristop programa Loki in pristop k indeksiranju v tradicionalnih rešitvah, kot je Elasticsearch, ob primeru vrstice iz loga nginx:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Tradicionalni sistemi analizirajo celo vrstico, vključno s polji z mnogimi edinstvenimi vrednostmi user_id in item_id, in vse shranijo v velike indekse. Prednost takšnega pristopa je v tem, da lahko izvajamo kompleksne poizvedbe hitro, saj so skoraj vsi podatki v indeksu. Vendar pa to pomeni, da indeks postane velik, kar prinaša zahteve glede pomnilnika. Na koncu je poln indeks logov primerljiv po velikosti s samimi logi. Da bi bilo iskanje hitro, mora biti indeks naložen v pomnilnik. In bolj kot je logov, hitreje se indeks povečuje in več pomnilnika porabi.
Loki's approach requires that only the necessary data be extracted from the string, with a small number of values involved. This way, we achieve a small index and can search the data by filtering it through time and indexed fields, then scanning the remainder using regular expressions or substring searches. The process may not seem the fastest, but Loki divides the request into several parts and executes them in parallel, handling large amounts of data in a short time. The number of shards and parallel requests within them is configurable; thus, the amount of data that can be processed per unit of time linearly depends on the resources provided.
This compromise between a large fast index and a small index with parallel full traversal allows Loki to control system costs. It can be flexibly adjusted and scaled according to needs.
The Loki stack consists of three components: Promtail, Loki, Grafana. Promtail collects logs, processes them, and sends them to Loki. Loki stores them. Grafana can query data from Loki and display it. In general, Loki can be used not only for storing logs and searching through them. The whole stack provides great capabilities for processing and analyzing incoming data, using the Prometheus way.
You can find the installation process description .
Log Search
Logs can be searched through the special Grafana interface — Explorer. The query language used is LogQL, which is very similar to PromQL used in Prometheus. Essentially, it can be considered a distributed grep.
The search interface looks like this:
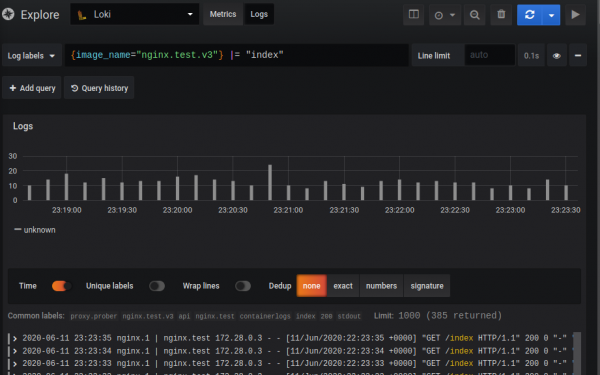
The query itself consists of two parts: selector and filter. The selector is a search based on indexed metadata (labels) assigned to logs, while the filter is the search string or regex that filters records defined by the selector. In the example provided: The contents in curly braces are the selector, everything after them is the filter.
{image_name="nginx.promtail.test"} |= "index"Due to the principle of how Loki works, queries cannot be made without a selector, but labels can be made as general as desired.
The selector consists of key-value pairs in curly braces. Selectors can be combined, and different search conditions can be specified using operators =, != or regular expressions:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Will find logs with the label instance, having values kafka-2, kafka-3, and exclude dev
Filter is a text or regex that will filter all data obtained by the selector.
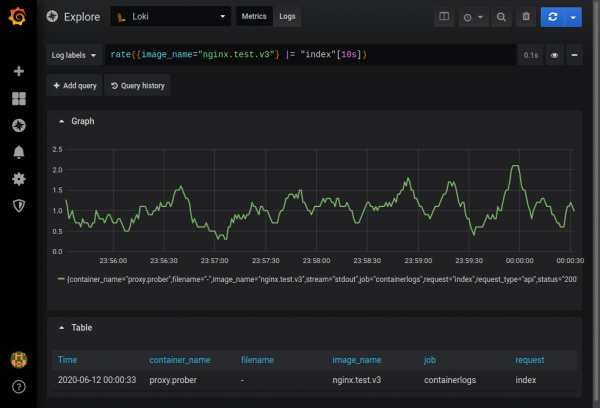
There is a possibility to get ad-hoc graphs from the received data in metrics mode. For example, you can find the frequency of occurrences in the nginx logs that contain the string index:
A complete description of the capabilities can be found in the documentation .
Log parsing
There are several ways to collect logs:
- Using Promtail, the standard component of the logging stack.
- Directly from the docker container using
- Use Fluentd or Fluent Bit, which can send data to Loki. Unlike Promtail, they have ready-made parsers for almost any type of log and can also handle multiline logs.
Typically, Promtail is used for parsing. It does three things:
- Finds data sources.
- Attaches labels to them.
- Sends data to Loki.
Currently, Promtail can read logs from local files and from the systemd journal. It must be installed on each machine from which logs are collected.
There is integration with Kubernetes: Promtail automatically learns the status of the cluster through the Kubernetes REST API and collects logs from the node, service, or pod, immediately labeling them based on metadata from Kubernetes (pod name, file name, etc.).
Labels can also be attached based on log data using a Pipeline. The Promtail pipeline can consist of four types of stages. More details can be found in , here I will note some nuances.
- Parsing stages. This is the RegEx and JSON stage. At this stage, we extract data from logs into what is called an extracted map. We can extract from JSON simply by copying the necessary fields into the extracted map, or through regular expressions (RegEx), where named groups are 'mapped' in the extracted map. The extracted map is a key-value storage, where the key is the field name, and the value is its corresponding log value.
- Transform stages. This stage has two options: transform, where we set transformation rules, and source — the data source for transformation from the extracted map. If there is no such field in the extracted map, it will be created. Thus, labels can be created that are not based on the extracted map. At this stage, we can manipulate the data in the extracted map using a sufficiently powerful . Poleg tega je treba upoštevati, da se extracted map naloži v celoti med procesom parsanja, kar omogoča, da na primer preverimo vrednost v njej: "{{if .tag}tag value exists{end}}". Predloga podpira pogoje, zanke in nekatere funkcije za obdelavo nizov, kot sta Replace in Trim.
- Faze akcij. V tej fazi lahko naredimo nekaj z izvlečenimi podatki:
- Ustvarite oznako iz extracted data, ki bo indeksirana v Loki.
- Spremenite ali nastavite čas dogodka v dnevniku.
- Spremenite podatke (besedilo dnevnika), ki bodo poslani v Loki.
- Ustvarite metrike.
- Faze filtriranja. Faza match, kjer lahko bodisi pošljemo v /dev/null zapise, ki jih ne potrebujemo, bodisi jih usmerimo v nadaljnjo obdelavo.
Pokažem na primeru obdelave običajnih nginx dnevnikov, kako lahko parsamo dnevnike s pomočjo Promtail.
Za test bomo vzeli modificirano sliko nginx jwilder/nginx-proxy:alpine kot nginx-proxy in majhen demon, ki se zna sam sebe spraševati po HTTP. Demonu je dodeljenih več končnih točk, na katere lahko daje odgovore različnih velikosti, z različnimi HTTP statusi in z različno zamudo.
Dnevnike bomo zbirali iz docker kontejnerjev, ki jih lahko najdete na poti /var/lib/docker/containers//-json.log
V docker-compose.yml nastavimo Promtail in navedemo pot do konfiguracije:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Dodamo v promtail.yml pot do dnevnikov (v konfiguraciji je možnost "docker", ki stori enako v eni vrstici, vendar to ne bi bilo tako pregledno):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # samo za linux
Ko omogočimo to konfiguracijo, bodo v Loki prihajali dnevniki iz vseh kontejnerjev. Da bi se temu izognili, spremenimo nastavitve testnega nginx v docker-compose.yml — dodamo logging polje tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Popravimo promtail.yml in nastavimo Pipeline. Na vhod prihajajo dnevniki naslednje oblike:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Faza pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Izvlečemo iz prihajajočega JSON polja stream, attrs, attrs.tag (če obstajajo) in jih damo v extracted map.
 - regex:
     izraz: ^(?P([^|]+))|(?P([^|]+))$
     vir: "tag"
Če nam je uspelo vstaviti polje tag v extracted map, potem z regexom izvlečemo imena slike in kontejnerja.
 - oznake:
     image_name:
     container_name:
Dodelimo oznake. Če bodo v izluženih podatkih odkriti ključi image_name in container_name, bodo njihove vrednosti dodeljene ustreznim oznakam.
 - ujemanje:
     izbira: '{job="docker",container_name="",image_name=""}'
     dejanje: drop
Zavržemo vse dnevnike, v katerih niso odkrili nameščenih oznak image_name in container_name.
  - ujemanje:
     izbira: '{image_name="nginx.promtail.test"}'
     faze:
       - json:
           izrazi:
             vrstica: log
Za vse dnevnike, kjer je image_name enak nginx.promtail.test, izvlečemo iz izvornega dnevnika polje log in ga damo v extracted map pod ključem vrstica.
  - regex:
         # potlači barve forego
         izraz: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         vir: logrow
Očistimo vhodno vrstico z uporabo regularnih izrazov in izvlečemo nginx virtual host in vrstico nginx dnevnika.
     - regex:
         vir: nginxlog
         izraz: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Parsiramo nginx dnevnik z uporabo regularnih izrazov.
    - regex:
           vir: request_url
           izraz: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           vir: request_url
           izraz: ^/photo/(?P[^/?.]+).*$
       - regex:
           vir: request_url
           izraz: ^/api/(?P[^/?.]+).*$
Analiziramo request_url. S pomočjo regexa določimo namen zahteve: za statične datoteke, za fotografije, za API in v extracted map nastavimo ustrezen ključ.
       - predloga:
           vir: request_type
           predloga: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
S pomočjo pogojnih operatorjev v predlogi preverimo nastavljena polja v extracted map in nastavimo ustrezne vrednosti za field request_type: photo, static, API. Dodelimo other, če ni bilo mogočo. Zdaj request_type vsebuje tip zahteve.
       - oznake:
           api_request:
           virtual_host:
           request_type:
           status:
Nastavimo oznake api_request, virtual_host, request_type in status (HTTP status) na podlagi tistega, kar je bilo možno vstaviti v extracted map.
       - izhod:
           vir: nginx_log_row
Spremenimo izhod. Zdaj v Loki odhaja očiščen nginx dnevnik iz extracted map.
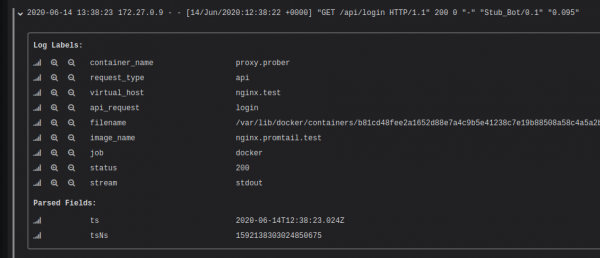
Po zagonu priloženega konfiguracije lahko vidimo, da je vsakem zapisu dodeljen označbe na podlagi podatkov iz dnevnika.
Treba imati u vidu da izvlačenje oznaka sa velikim brojem vrednosti (cardinality) može značajno usporiti rad Loki. Dakle, ne bi trebalo stavljati u indeks, na primer, user_id. Više o tome pročitajte u članku “”. Ali to ne znači da ne možete tražiti po user_id bez indeksa. Treba koristiti filtere prilikom pretraživanja („grepati“ po podacima), a indeks ovde služi kao identifikator toka.
Vizualizacija logova
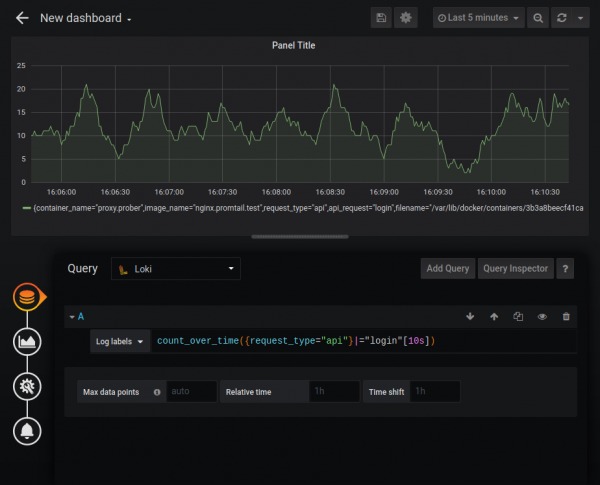
Loki može da služi kao izvor podataka za grafike u Grafani, koristeći LogQL. Podržane su sledeće funkcije:
- rate — broj unosa u sekundi;
- count over time — broj unosa u zadanom opsegu.
Takođe postoje agregatne funkcije Sum, Avg i druge. Možete praviti prilično složene grafike, na primer, grafikon broja HTTP grešaka:
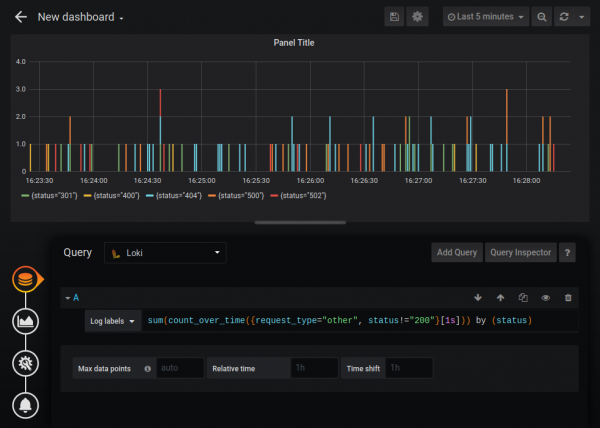
Standardni izvor podataka Loki je pomalo ograničen u funkcionalnosti u poređenju sa izvorom podataka Prometheus (na primer, ne može se promeniti legenda), ali Loki se može povezati kao izvor sa tipom Prometheus. Nisam siguran da li je to dokumentovano ponašanje, ali prema odgovoru programera “”, na primer, to je sasvim zakonito, i Loki je potpuno kompatibilan sa PromQL.
Dodajemo Loki kao izvor podataka sa tipom Prometheus i dopisujemo URL /loki:

I možemo praviti grafike, kao da radimo sa metrikama iz Prometheus:
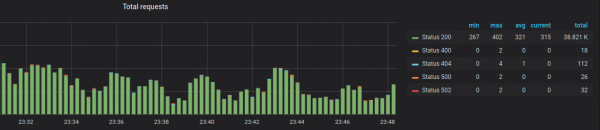
Mislim da je razlika u funkcionalnosti privremena i da će programeri to ispraviti u budućnosti.
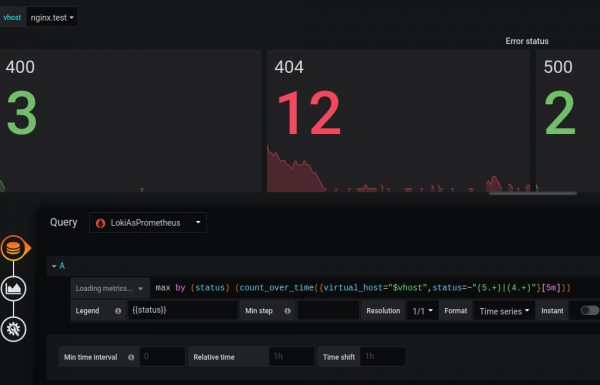
Metrike
U Lokiju je dostupna mogućnost izvlačenja numeričkih metrika iz logova i slanje njih u Prometheus. Na primer, u logu nginx se nalaze broj bajtova u odgovoru, kao i, uz određenu modifikaciju standardnog formata loga, vreme u sekundama koje je bilo potrebno za odgovor. Ove podatke možemo izvući i poslati u Prometheus.
Dodajemo još jednu sekciju u promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "vreme odgovora ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "suma bajtova odgovora"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "broj bajtova odgovora"
           source: bytes_out
           config:
             action: inc
Možnost omogoča določanje in posodabljanje metrik na podlagi podatkov iz extracted map. Te metrike se ne pošiljajo v Loki — pojavijo se na Promtail /metrics endpointu. Prometheus mora biti konfiguriran tako, da prejme podatke, pridobljene v tej fazi. V danem primeru za request_type="api" zbiramo metriko-histogram. S tem tipom metrik je priročno pridobiti percentile. Za statične podatke in slike zbiramo vsoto bajtov in število vrstic, v katerih smo prejeli bajte, da izračunamo povprečje.
Več podrobnosti o metrikah preberite .
Odprimo vrata na Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
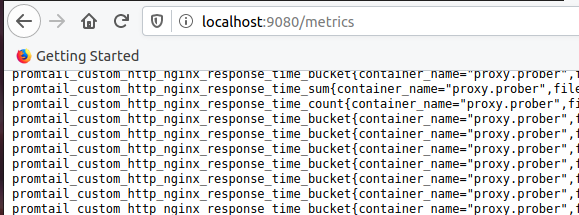
Preverimo, da so se metrike s predpono promtail_custom pojavile:
Nastavimo Prometheus. Dodamo job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
In narišemo graf:
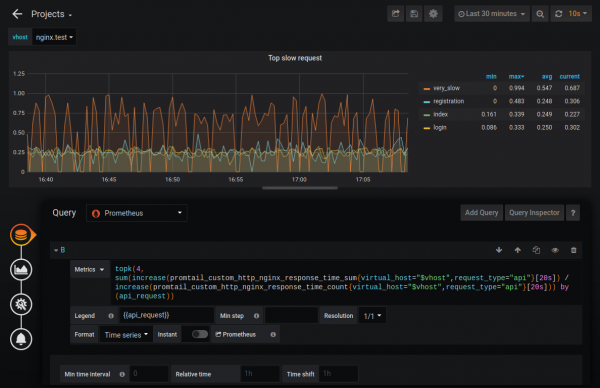
Tako lahko ugotovimo, na primer, štiri najpočasnejše poizvedbe. Na te metrike lahko prav tako nastavimo nadzor.
Skaliranje
Loki je lahko v enojnem načinu (single binary mode) ali v shardiranem (horizontally-scalable mode). V drugem primeru lahko shranjuje podatke v oblak, pri čemer so chunks in indeks shranjeni ločeno. V različici 1.5 je bila uvedena možnost shranjevanja na enem mestu, vendar je trenutno ne priporočamo za uporabo v produkciji.
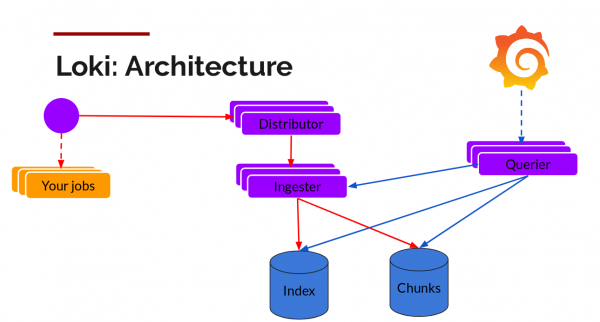
Chunks je mogoče shranjevati v shranjevanju, združljivim s S3, za shranjevanje indeksov — uporabite horizontalno skalabilne baze podatkov: Cassandra, BigTable ali DynamoDB. Druge komponente Loki — Distributors (za zapisovanje) in Querier (za poizvedbe) — so stateless in se prav tako horizontalno skalirajo.
Na konferenci DevOpsDays Vancouver 2019 je eden od udeležencev Callum Styan povedal, da je njegov projekt z Lokijem imel petabajte logov z indeksom, ki je manjši od 1% skupne velikosti: “”.
Primerjava Loki in ELK
Velikost indeksa
Za testiranje pridobljene velikosti indeksa sem vzel loge s kontejnerja nginx, za katerega je bil nastavljen Pipeline, ki je naveden zgoraj. Datoteka z logi je vsebovala 406 624 vrstic z skupnim obsegom 109 MB. Logi so se generirali skozi uro, približno po 100 zapisov na sekundo.
Primer dveh vrstic iz loga:
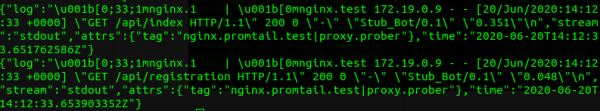
Pri indeksaciji ELK je to dalo velikost indeksa 30,3 MB:
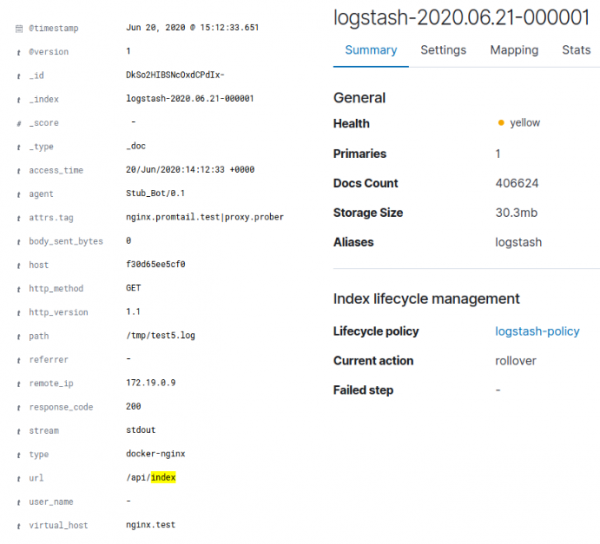
V primeru Loki je to dalo približno 128 Kb indeksa in približno 3,8 Mb podatkov v delih. Omeniti je treba, da je bil zapis umetno generiran in ni bil bogat z raznolikostjo podatkov. Preprost gzip na izvorni Docker JSON-zapis z podatki je dal kompresijo 95,4%, in ker je bilo v Loki poslan le očiščen nginx-zapis, je razumno, da je bila kompresija do 4 Mb. Skupno število unikatnih vrednosti za oznake Loki je bilo 35, kar pojasnjuje majhno velikost indeksa. Tudi za ELK je bil zapis očiščen. Tako je Loki originalne podatke stisnil za 96%, ELK pa za 70%.
Poraba pomnilnika
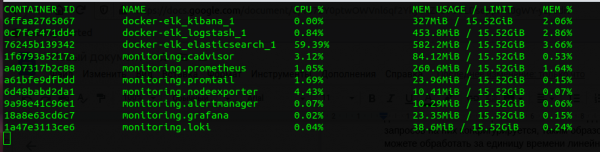
Če primerjamo celoten sklad Prometheus in ELK, Loki porabi večkrat manj. Jasno je, da storitev v Go porabi manj kot storitev v Javi, in primerjava velikosti JVM Heap Elasticsearch s dodeljenim pomnilnikom za Loki ni pravilna, vendar je vseeno treba omeniti, da Loki uporablja precej manj pomnilnika. Njegova prednost pri CPU ni tako očitna, a je prisotna.
Hitrost
Loki hitreje »požira« zapise. Hitrost je odvisna od mnogih dejavnikov — kakšni so zapisi, kako kompleksno jih obdelujemo, omrežje, disk itd. — a je nedvomno višja kot pri ELK (v mojem testu približno dvakrat). To je razloženo z dejstvom, da Loki v indeks daje precej manj podatkov in zato porabi manj časa za indeksiranje. Pri hitrosti iskanja je situacija obratna: Loki občutno upočasni pri podatkih, večjih od nekaj gigabajtov, medtem ko pri ELK hitrost iskanja ni odvisna od velikosti podatkov.
Log Search
Loki bistveno zaostaja za ELK po možnosti iskanja po zapisih. Grep z regularnimi izrazi je močno orodje, vendar ne more tekmovati z oblikovano bazo podatkov. Pomanjkanje range-poizvedb, agregacija le po oznakah, nezmožnost iskanja brez oznak — vse to nas omejuje pri iskanju zanimivih informacij v Loki. To ne pomeni, da z Loki ne moremo najti ničesar, ampak določa način dela z zapisi, ko najprej najdemo težavo na grafih Prometheus in nato po teh oznakah iščemo, kaj se je zgodilo v zapisih.
Vmesnik
Prvič, to je lepo (oprosti, nisem se mogel zadržati). Grafana ima lep viden vmesnik, vendar je Kibana veliko bolj funkcionalna.
Prednosti in slabosti Loki
Med pozitivnih strani lahko izpostavimo, da se Loki integrira s Prometheusom, kar pomeni, da metrike in opozarjanje dobimo neposredno. Udobno je za zbiranje in shranjevanje logov iz Kubernetes Pods, saj ima podedovano od Prometheusa odkrivanje storitev in samodejno dodaja oznake.
Negativne strani vključujejo slabo dokumentacijo. Nekatere stvari, na primer posebnosti in možnosti Promtail, sem ugotovil šele med raziskovanjem kode, saj je odprtokodna. Še ena pomanjkljivost so omejene možnosti parserja. Na primer, Loki ne zna obravnavati večvrstičnih logov. Med pomanjkljivostmi lahko omenimo tudi to, da je Loki razmeroma mlada tehnologija (različica 1.0 je bila izdana novembra 2019).
Zaključek
Loki je 100% zanimiva tehnologija, ki ustreza majhnim in srednje velikim projektom, saj omogoča reševanje številnih nalog agregiranja logov, iskanja po logih, monitoringa in analiziranja logov.
Loki ne uporabljamo v Badoo, saj imamo ELK-stek, ki nas zadovoljivo podpira in ki smo ga skozi leta obogatili z različnimi prilagojenimi rešitvami. Za nas je ključna težava iskanje po logih. S skoraj 100 GB logov na dan nam je pomembno, da lahko hitro najdemo vse in še malce več. Za grafične prikaze in monitoring uporabljamo drugačenja, ki so prilagojena našim potrebam in so medsebojno integrirana. Strek Loki ima znatne prednosti, vendar nam ne bo ponudil več, kot ga že imamo, in njegove prednosti zagotovo ne bodo pokrile stroškov migracije.
In čeprav je po raziskovanju postalo jasno, da Loki ne moremo uporabljati, upamo, da vam bo ta objava pomagala pri izbiri.
Repozitorij s kodo, uporabljeno v članku, se nahaja .
Izvor: habr.com
