

Najpre, kada započinjemo rad s novim skupom podataka, potrebno je da ga razumemo. Da bismo to postigli, potrebno je, na primer, otkriti opsege vrednosti koje varijable mogu imati, njihove tipove, kao i saznati o broju propuštenih vrednosti.
Pandas biblioteka nam pruža mnogo korisnih alata za izvođenje istraživačke analize podataka (Exploratory Data Analysis, EDA). No, pre nego što ih iskoristimo, obično treba da počnemo sa funkcijama opšteg tipa, kao što je df.describe(). Ipak, treba napomenuti da su mogućnosti koje pružaju slične funkcije ograničene, a rani koraci u radu sa bilo kojim skupovima podataka prilikom izvođenja EDA često se veoma slično ponavljaju.
Autor materijala koji danas objavljujemo tvrdi da nije ljubitelj ponavljanja istih radnji. Kao rezultat toga, u potrazi za sredstvima koja omogućavaju brzo i efikasno izvođenje istraživačke analize podataka, pronašao je biblioteku . Rezultati njenog rada se ne izražavaju kao pojedinačni pokazatelji, već u obliku prilično detaljnog HTML izveštaja koji sadrži većinu informacija o analiziranim podacima koje bi mogle biti potrebne pre nego što se pristupi bližem radu s njima.
Ovdje će se razmotriti karakteristike korišćenja biblioteke pandas-profiling na primeru skupa podataka Titanic.
Istraživačka analiza podataka korišćenjem pandas
Odlučio sam da eksperimentiram sa pandas-profiling na skupu podataka Titanic zbog prisustva podataka različitih tipova i zbog postojanja propuštenih vrednosti. Smatram da je biblioteka pandas-profiling posebno zanimljiva u slučajevima kada podaci još nisu očišćeni i zahtevaju dalju obradu koja zavisi od njihovih karakteristika. Da bismo uspeli u ovakvoj obradi, potrebno je znati odakle početi i na šta obratiti pažnju. Tu nam pomažu mogućnosti pandas-profiling.
Prvo ćemo uvesti podatke i koristiti pandas za dobijanje pokazatelja deskriptivne statistike:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Nakon izvršenja ovog fragmenta koda dobićemo ono što je prikazano na sledećem grafikonu.
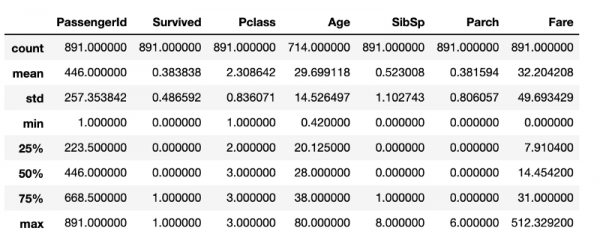
Pokazatelji deskriptivne statistike dobijeni pomoću standardnih sredstava pandas
Čeprav tukaj najdete veliko koristnih informacij, tukaj ni vsega, kar bi vas lahko zanimalo glede raziskovanih podatkov. Na primer, lahko domnevamo, da je v podatkovnem okviru, v strukturi DataFrame, 891 vrstica. Če želite to preveriti, bo potrebna še ena vrstica kode, ki določa velikost okvira. Čeprav te izračune ni posebej težko izvajati, bo njihovo nenehno ponavljanje zagotovo pripeljalo do izgube časa, ki bi ga bilo verjetno bolje porabiti za čiščenje podatkov.
Raziskovalna analiza podatkov z orodji pandas-profiling
Sedaj bomo isto storili z uporabo pandas-profiling:
pandas_profiling.ProfileReport(df)Izvedba zgoraj navedene vrstice kode bo omogočila ustvarjanje poročila s kazalniki raziskovalne analize podatkov. Koda, prikazana zgoraj, bo dala izhod najdenih informacij o podatkih, vendar lahko naredimo tudi tako, da je rezultat HTML-dokument, ki ga je mogoče na primer pokazati nekomu.
Prvi del poročila bo vseboval razdelek Pregled, ki nudi osnovne informacije o podatkih (število opazovanj, število spremenljivk itd.). Poleg tega bo vseboval seznam opozoril, ki obvešča analitika, na kaj naj posveti posebno pozornost. Ta opozorila lahko služijo kot namigi, na kaj se osredotočiti pri čiščenju podatkov.
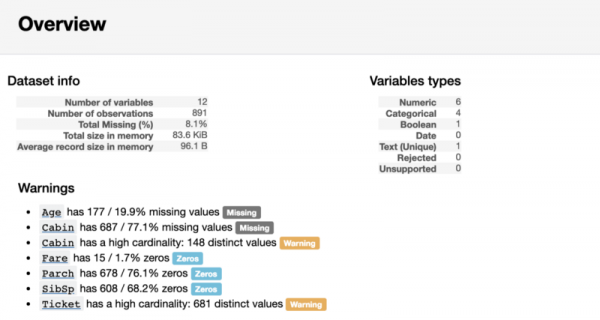
Razdelek poročila Pregled
Raziskovalna analiza spremenljivk
Za razdelkom Pregled v poročilu lahko najdete koristne informacije o vsaki spremenljivki. Te vključujejo, med drugim, majhne diagrame, ki opisujejo porazdelitev vsake spremenljivke.
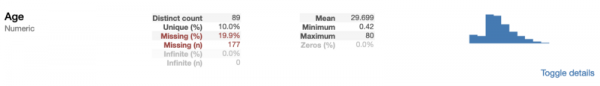
Informacije o številčni spremenljivki Starost
Kot lahko vidimo iz prejšnjega primera, pandas-profiling navaja nekaj uporabnih kazalnikov, kot so odstotek in število manjkajočih vrednosti ter kazalniki opisne statistike, ki smo jih že videli. Torej, Starost je številčna spremenljivka, vizualizacija njene porazdelitve v obliki histograma pa nam omogoča sklepanje, da gre za desno nagibno porazdelitev.
Pri pregledu kategorijske spremenljivke so izpisani kazalniki nekoliko drugačni od tistih, ki so bili ugotovljeni za številčno spremenljivko.
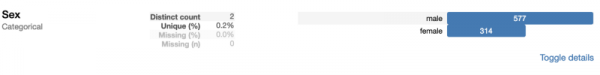
Informacije o kategorijski spremenljivki Spol
Namreč, namesto iskanja povprečja, minimuma in maksimuma, knjižnica pandas-profiling najde število razredov. Tako da Spol — binarna spremenljivka, njene vrednosti so predstavljene z dvema razredoma.
Če ste, tako kot jaz, navdušeni nad raziskovanjem kode, vas morda zanima, kako knjižnica pandas-profiling izračuna te kazalnike. Ugotoviti to, ob upoštevanju, da je koda knjižnice odprta in dostopna na GitHubu, ni tako težko. Ker nisem velik oboževalec uporabe 'črnih škatel' v mojih projektih, sem si ogledal izvorno kodo knjižnice. Na primer, takole izgleda mehanizem obravnave številskih spremenljivk, predstavljen s funkcijo :
def describe_numeric_1d(series, **kwargs):
    """Izračuna povzetne statistike za številčno ('TYPE_NUM') spremenljivko (Series).
    Prav tako ustvari histograme (mini in polne) njene porazdelitve.
    Parametri
    ----------
    series : Series
        Spremenljivka, ki jo opišemo.
    Vrne
    -------
    Series
        Opis spremenljivke kot Series z indeksom, ki je ključe statistike.
    """
    # Oblikovanje števila kot odstotka. Na primer 0,25 bo spremenjen v 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # Da se izognemo večkratnemu izračunavanju
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # dropna() je rešitev za https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogrami
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Čeprav se ta del kode morda zdi precej velik in zapleten, je v resnici njegovo razumevanje zelo enostavno. Gre za to, da v izvorni kodi knjižnice obstaja funkcija, ki določa tipe spremenljivk. Če se izkaže, da je knjižnica naletela na številčno spremenljivko, zgoraj omenjena funkcija najde kazalnike, ki smo jih obravnavali. V tej funkciji se uporabljajo standardne operacije pandas za delo z objekti tipa Series, podobno kot series.mean(). Rezultati izračunov se hranijo v slovarju stats. Histogrami se oblikujejo z uporabo prilagojene različice funkcije matplotlib.pyplot.hist. Prilagoditev je usmerjena v to, da funkcija deluje z različnimi vrstami naborov podatkov.
Kazalniki korelacije in vzorec raziskovanih podatkov
Po analizi spremenljivk z pandas-profiling, v razdelku Korelacije, se prikažejo Pearsonove in Spearmanove korelacijske matrike.
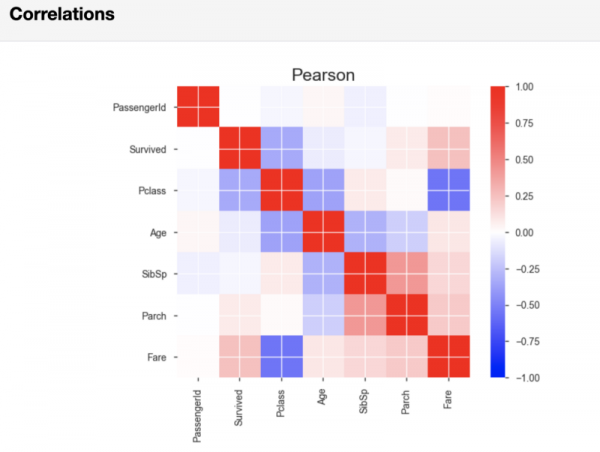
Pearsonova korelacijska matrica
Če je potrebno, lahko v tisti vrstici kode, ki sproži generiranje poročila, določite pragovne vrednosti, ki se uporabljajo pri izračunu korelacije. S tem lahko opredelite, kakšna moč korelacije je pomembna za vašo analizo.
In nazadnje, v poročilu pandas-profiling, v razdelku Vzorec, se prikaže del podatkov iz začetka naboru podatkov kot primer. Tak pristop lahko privede do neprijetnih presenečenj, saj prvih nekaj opazovanj morda predstavlja vzorec, ki ne odraža značilnosti celotnega nabora podatkov.
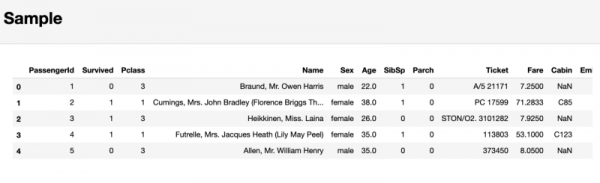
Razdelek, ki vsebuje vzorec raziskovanih podatkov
Zato ne priporočam pozornosti na ta zadnji razdelek. Raje uporabite ukaz df.sample(5), ki naključno izbere 5 opazovanj iz nabora podatkov.
Zaključki
Skratka, knjižnica pandas-profiling analitikom ponuja številne koristne funkcionalnosti, ki so koristne, ko je treba hitro pridobiti splošen pregled nad podatki ali posredovati poročilo o eksploratorni analizi podatkov. Prava obdelava podatkov, ki upošteva njihove značilnosti, se izvede, tako kot brez pandas-profiling, ročno.
Če želite videti, kako izgleda celotna eksploratorna analiza podatkov v enem Jupyter notepadu — si oglejte moj projekt, ustvarjen s pomočjo nbviewer. In v GitHub repozitoriju najdete ustrezno kodo.
Spoštovani bralci! Kako začnete analizo novih naborov podatkov?
Izvor: habr.com
