

KDB+, bidhaa ya kampuni inajulikana sana katika miduara nyembamba, hifadhidata ya haraka sana, safu wima iliyoundwa kwa ajili ya kuhifadhi mfululizo wa saa na hesabu za uchanganuzi kulingana nazo. Hapo awali, ilikuwa (na ni) maarufu sana katika tasnia ya kifedha - benki zote 10 za juu za uwekezaji na fedha nyingi zinazojulikana za ua, kubadilishana na mashirika mengine hutumia. Hivi karibuni, KX iliamua kupanua msingi wa wateja wake na sasa kutoa ufumbuzi katika maeneo mengine ambapo kuna kiasi kikubwa cha data, iliyoandaliwa na wakati au vinginevyo - telecom, bioinformatics, viwanda, nk. Pia wakawa mshirika wa timu ya Mashindano ya Aston Martin Red Bull katika Mfumo wa 1, ambapo wanasaidia kukusanya na kuchakata data kutoka kwa vitambuzi vya gari na kuchanganua majaribio ya njia ya upepo. Katika makala haya, nataka kukuambia ni vipengele vipi vya KDB+ vinavyoifanya ifanye kazi vizuri zaidi, kwa nini makampuni yana nia ya kutumia pesa nyingi juu yake, na hatimaye, kwa nini sio hifadhidata.
Katika makala haya nitajaribu kukuambia kwa ujumla KDB+ ni nini, ina uwezo na vikwazo gani, na faida zake ni nini kwa makampuni ambayo yanataka kuchakata kiasi kikubwa cha data. Sitaingia katika maelezo ya utekelezaji wa KDB+ au maelezo ya lugha yake ya kupanga programu ya Q. Mada hizi zote mbili ni pana sana na zinastahili makala tofauti. Taarifa nyingi kuhusu mada hizi zinaweza kupatikana katika code.kx.com, ikijumuisha kitabu kuhusu Q - Q For Mortals (ona kiungo hapa chini).
Baadhi ya masharti
- Hifadhidata ya kumbukumbu. Hifadhidata inayohifadhi data kwenye RAM kwa ufikiaji wa haraka. Faida za hifadhidata hiyo ni wazi, lakini hasara ni uwezekano wa kupoteza data na haja ya kuwa na kumbukumbu nyingi kwenye seva.
- Hifadhidata ya safuwima. Hifadhidata ambapo data huhifadhiwa safu kwa safu badala ya kurekodi kwa rekodi. Faida kuu ya hifadhidata kama hiyo ni kwamba data kutoka safu moja huhifadhiwa pamoja kwenye diski na kwenye kumbukumbu, ambayo huharakisha ufikiaji wake. Hakuna haja ya kupakia safuwima ambazo hazitumiwi katika hoja. Hasara kuu ni kwamba ni vigumu kurekebisha na kufuta rekodi.
- Mfululizo wa wakati. Data iliyo na tarehe au safu wima ya saa. Kwa kawaida, kuagiza muda ni muhimu kwa data hiyo, ili uweze kuamua kwa urahisi ni rekodi gani inayotangulia au kufuata ya sasa, au kutumia kazi ambazo matokeo yake hutegemea utaratibu wa rekodi. Hifadhidata za zamani zimejengwa kwa kanuni tofauti kabisa - inayowakilisha mkusanyiko wa rekodi kama seti, ambapo mpangilio wa rekodi, kimsingi, haujafafanuliwa.
- Vekta. Katika muktadha wa KDB+, hii ni orodha ya vipengele vya aina moja ya atomiki, kwa mfano, nambari. Kwa maneno mengine, safu ya vipengele. Safu, tofauti na orodha, zinaweza kuhifadhiwa kwa ufupi na kusindika kwa kutumia maagizo ya kichakataji cha vekta.
historia
KX ilianzishwa mnamo 1993 na Arthur Whitney, ambaye hapo awali alifanya kazi katika Benki ya Morgan Stanley kwenye lugha ya A+, mrithi wa APL - lugha asilia na wakati mmoja maarufu katika ulimwengu wa kifedha. Bila shaka, katika KX, Arthur aliendelea katika roho hiyo hiyo na kuunda lugha ya vector-kazi K, iliyoongozwa na mawazo ya minimalism kali. Programu za K zinaonekana kama mchanganyiko wa alama za uakifishaji na herufi maalum, maana ya ishara na vitendaji hutegemea muktadha, na kila operesheni hubeba maana zaidi kuliko ilivyo katika lugha za kawaida za programu. Kutokana na hili, programu ya K inachukua nafasi ndogo—mistari michache inaweza kuchukua nafasi ya kurasa za maandishi katika lugha ya kitenzi kama Java—na ni utekelezaji uliokolezwa zaidi wa algoriti.
Kazi katika K ambayo hutumia jenereta nyingi za LL1 kulingana na sarufi fulani:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/:1_r),"]";""]]}
Arthur alijumuisha falsafa hii ya ufanisi wa hali ya juu na uchezaji mdogo wa mwili katika KDB+, ambayo ilionekana mnamo 2003 (nadhani ni wazi sasa herufi K katika jina inatoka wapi) na si chochote zaidi ya mkalimani wa toleo la nne la K. Lugha. Toleo linalofaa zaidi kwa mtumiaji limeongezwa juu ya K K inayoitwa Q. Q pia iliongeza usaidizi kwa lahaja mahususi ya SQL - QSQL, na mkalimani - msaada wa majedwali kama aina ya data ya mfumo, zana za kufanya kazi na majedwali. kwenye kumbukumbu na kwenye diski, nk.
Kwa hivyo kutoka kwa mtazamo wa mtumiaji, KDB+ ni mkalimani wa lugha ya Q na usaidizi wa majedwali na misemo ya mtindo wa SQL kama LINQ kutoka C #. Hii ndiyo tofauti muhimu zaidi kati ya KDB+ na hifadhidata zingine na faida yake kuu ya ushindani, ambayo mara nyingi hupuuzwa. Hii si hifadhidata + lugha saidizi iliyozimwa, lakini ni lugha kamili ya programu yenye nguvu + usaidizi uliojengewa ndani wa vitendakazi vya hifadhidata. Tofauti hii itachukua jukumu muhimu katika kuorodhesha manufaa yote ya KDB+. Kwa mfano…
Ukubwa
Kwa viwango vya kisasa, KDB+ ina ukubwa wa hadubini tu. Kwa kweli ni faili ndogo ya megabaiti inayoweza kutekelezwa na faili moja ndogo ya maandishi iliyo na vitendaji vya mfumo. Kwa kweli - chini ya megabyte moja, na kwa programu hii makampuni hulipa makumi ya maelfu ya dola kwa mwaka kwa processor moja kwenye seva.
- Ukubwa huu huruhusu KDB+ kujisikia vizuri kwenye maunzi yoyote - kutoka kompyuta ndogo ya Pi hadi seva zilizo na kumbukumbu ya terabaiti. Hii haiathiri utendakazi kwa njia yoyote; zaidi ya hayo, Q huanza papo hapo, ambayo inaruhusu itumike, miongoni mwa mambo mengine, kama lugha ya uandishi.
- Kwa ukubwa huu, mkalimani wa Q inafaa kabisa kwenye cache ya processor, ambayo huharakisha utekelezaji wa programu.
- Kwa saizi hii ya faili inayoweza kutekelezwa, mchakato wa Q unachukua nafasi kidogo kwenye kumbukumbu; unaweza kuendesha mamia yao. Zaidi ya hayo, ikiwa ni lazima, Q inaweza kufanya kazi na makumi au mamia ya kumbukumbu ya gigabaiti ndani ya mchakato mmoja.
Tofauti
Q ni nzuri kwa anuwai ya programu. Mchakato Q unaweza kufanya kazi kama hifadhidata ya kihistoria na kutoa ufikiaji wa haraka kwa terabytes za habari. Kwa mfano, tuna hifadhidata nyingi za kihistoria, ambapo baadhi ya siku moja isiyobanwa huchukua zaidi ya gigabaiti 100. Hata hivyo, chini ya vizuizi vinavyofaa, swali kwa hifadhidata litakamilika kwa makumi hadi mamia ya milliseconds. Kwa ujumla, tuna muda wa kuisha kwa maombi ya watumiaji - sekunde 30 - na hufanya kazi mara chache sana.
Q inaweza kuwa hifadhidata ya kumbukumbu kwa urahisi. Data mpya huongezwa kwa majedwali ya kumbukumbu kwa haraka sana hivi kwamba maombi ya mtumiaji ndiyo yanayozuia. Data katika majedwali huhifadhiwa katika safuwima, ambayo ina maana kwamba utendakazi wowote kwenye safu utatumia akiba ya kichakataji kwa uwezo kamili. Kwa kuongezea hii, KX ilijaribu kutekeleza shughuli zote za kimsingi kama hesabu kupitia maagizo ya vekta ya processor, na kuongeza kasi yao. Q pia inaweza kufanya kazi ambazo si za kawaida kwa hifadhidata - kwa mfano, kuchakata data ya kutiririsha na kukokotoa katika "muda halisi" (kwa kucheleweshwa kutoka makumi ya milisekunde hadi sekunde kadhaa kulingana na kazi) kazi mbalimbali za ujumlisho wa vyombo vya kifedha kwa muda tofauti. vipindi au jenga kielelezo cha ushawishi wa shughuli kamilifu kwa soko na kutekeleza wasifu wake mara tu baada ya kukamilika. Katika kazi kama hizi, mara nyingi ucheleweshaji wa wakati kuu sio Q, lakini hitaji la kusawazisha data kutoka kwa vyanzo tofauti. Kasi ya juu hupatikana kwa sababu ya ukweli kwamba data na kazi zinazozichakata ziko katika mchakato mmoja, na usindikaji umepunguzwa hadi kutekeleza misemo kadhaa ya QSQL na viungo, ambavyo hazijafasiriwa, lakini zinatekelezwa na nambari ya binary.
Hatimaye, unaweza kuandika michakato yoyote ya huduma katika Q. Kwa mfano, michakato ya Gateway ambayo inasambaza maombi ya mtumiaji kiotomatiki kwa hifadhidata na seva zinazohitajika. Mpangaji programu ana uhuru kamili wa kutekeleza algorithm yoyote ya kusawazisha, kuweka vipaumbele, uvumilivu wa makosa, haki za ufikiaji, upendeleo na kimsingi kitu kingine chochote ambacho moyo wake unatamani. Shida kuu hapa ni kwamba utalazimika kutekeleza haya yote mwenyewe.
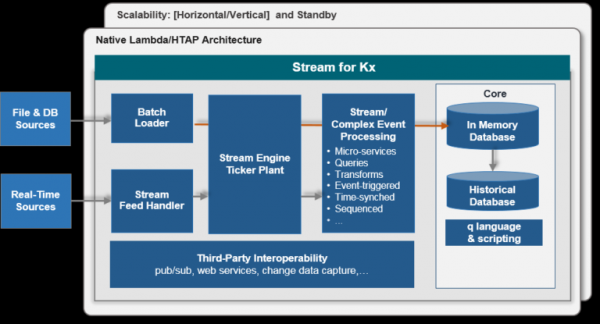
Kama mfano, nitaorodhesha ni aina gani za michakato tuliyo nayo. Zote zinatumika kikamilifu na hufanya kazi pamoja, kuchanganya kadhaa ya hifadhidata tofauti hadi moja, kuchakata data kutoka kwa vyanzo vingi na kuhudumia mamia ya watumiaji na programu.
- Viunganishi (feedhandler) kwa vyanzo vya data. Michakato hii kwa kawaida hutumia maktaba za nje ambazo zimepakiwa kwenye Q. Kiolesura cha C katika Q ni rahisi sana na hukuruhusu kuunda utendakazi wa seva mbadala kwa urahisi kwa maktaba yoyote ya C/C++. Q ina kasi ya kutosha kushughulikia, kwa mfano, kuchakata mafuriko ya ujumbe wa FIX kutoka kwa masoko yote ya hisa ya Ulaya kwa wakati mmoja.
- Wasambazaji wa data (tickerplant), ambayo hutumika kama kiunga cha kati kati ya viunganishi na watumiaji. Wakati huo huo, wanaandika data inayoingia kwa logi maalum ya binary, kutoa uimara kwa watumiaji dhidi ya upotezaji wa unganisho au kuanza tena.
- Hifadhidata ya kumbukumbu (rdb). Hifadhidata hizi hutoa ufikiaji wa haraka zaidi wa data mbichi, safi kwa kuihifadhi kwenye kumbukumbu. Kwa kawaida, hujilimbikiza data katika meza wakati wa mchana na kuziweka upya usiku.
- Hifadhidata ya kuendelea (pdb). Hifadhidata hizi huhakikisha kuwa data ya leo imehifadhiwa katika hifadhidata ya kihistoria. Kama sheria, tofauti na rdb, hazihifadhi data kwenye kumbukumbu, lakini hutumia kashe maalum kwenye diski wakati wa mchana na kunakili data usiku wa manane kwenye hifadhidata ya kihistoria.
- Hifadhidata za kihistoria (hdb). Hifadhidata hizi hutoa ufikiaji wa data kwa siku, miezi na miaka iliyopita. Ukubwa wao (kwa siku) ni mdogo tu kwa ukubwa wa anatoa ngumu. Data inaweza kupatikana mahali popote, haswa kwenye diski tofauti ili kuharakisha ufikiaji. Inawezekana kubana data kwa kutumia algorithms kadhaa kuchagua. Muundo wa hifadhidata umeandikwa vizuri na rahisi, data huhifadhiwa safu kwa safu kwenye faili za kawaida, ili ziweze kusindika, pamoja na mfumo wa uendeshaji.
- Hifadhidata zilizo na habari iliyojumlishwa. Huhifadhi mikusanyiko mbalimbali, kwa kawaida na, iliyopangwa kwa jina la chombo na muda wa muda. Hifadhidata za kumbukumbu husasisha hali yao kwa kila ujumbe unaoingia, na hifadhidata za kihistoria huhifadhi data iliyokokotwa awali ili kuharakisha ufikiaji wa data ya kihistoria.
- Mwishowe michakato ya langokuhudumia programu na watumiaji. Q hukuruhusu kutekeleza usindikaji usiolingana kabisa wa ujumbe unaoingia, kuzisambaza kwenye hifadhidata, kuangalia haki za ufikiaji, nk. Kumbuka kuwa ujumbe sio mdogo na mara nyingi sio misemo ya SQL, kama ilivyo katika hifadhidata zingine. Mara nyingi, usemi wa SQL hufichwa katika kazi maalum na hujengwa kulingana na vigezo vilivyoombwa na mtumiaji - wakati hubadilishwa, kuchujwa, data ni ya kawaida (kwa mfano, bei ya hisa inasawazishwa ikiwa gawio lililipwa), nk.
Usanifu wa kawaida wa aina moja ya data:
Kasi
Ingawa Q ni lugha iliyotafsiriwa, pia ni lugha ya vekta. Hii ina maana kwamba utendakazi nyingi zilizojengewa ndani, hasa zile za hesabu, huchukua hoja za aina yoyote - nambari, vekta, matrices, orodha - na mtayarishaji programu anatarajiwa kutekeleza programu kama shughuli za safu. Katika lugha kama hii, ukiongeza vekta mbili za vipengele milioni, haijalishi lugha inatafsiriwa; nyongeza itatekelezwa na utendaji kazi bora zaidi wa binary. Kwa kuwa sehemu kubwa ya muda katika programu za Q hutumika katika utendakazi na majedwali yanayotumia vitendaji hivi vya msingi vya vekta, matokeo ni kasi nzuri sana ya uendeshaji, ambayo inaturuhusu kuchakata kiasi kikubwa cha data hata katika mchakato mmoja. Hii ni sawa na maktaba za hesabu huko Python - ingawa Python yenyewe ni lugha polepole sana, ina maktaba nyingi bora kama numpy ambayo hukuruhusu kusindika data ya nambari kwa kasi ya lugha iliyokusanywa (kwa njia, numpy iko karibu kiitikadi na Q. )
Kwa kuongeza, KX ilichukua mbinu makini sana ya kubuni meza na kuboresha kazi pamoja nao. Kwanza, aina kadhaa za faharisi zinaungwa mkono, ambazo zinaungwa mkono na kazi zilizojengwa ndani na zinaweza kutumika sio tu kwa safu wima za meza, lakini pia kwa vekta yoyote - kuweka kambi, kupanga, sifa ya kipekee na kambi maalum ya hifadhidata za kihistoria. Faharasa inatumika kwa urahisi na inarekebishwa kiatomati wakati wa kuongeza vipengee kwenye safu/vekta. Fahirisi zinaweza kutumika kwa mafanikio kwa safu wima za jedwali kwenye kumbukumbu na kwenye diski. Wakati wa kutekeleza swali la QSQL, faharasa hutumiwa kiotomatiki ikiwezekana. Pili, kazi na data ya kihistoria inafanywa kupitia utaratibu wa kuonyesha faili za OS (ramani ya kumbukumbu). Jedwali kubwa hazijapakiwa kamwe kwenye kumbukumbu; badala yake, safu wima zinazohitajika zimepangwa moja kwa moja kwenye kumbukumbu na ni sehemu hiyo tu ndiyo inayopakiwa (fahasi pia husaidia hapa) ambazo zinahitajika. Haileti tofauti kwa mpanga programu ikiwa data iko kwenye kumbukumbu au la; utaratibu wa kufanya kazi na mmap umefichwa kabisa katika kina cha Q.
KDB+ si hifadhidata ya uhusiano; majedwali yanaweza kuwa na data kiholela, ilhali mpangilio wa safu mlalo katika jedwali haubadiliki vipengele vipya vinapoongezwa na vinaweza na vinapaswa kutumiwa wakati wa kuandika hoja. Kipengele hiki kinahitajika kwa haraka ili kufanya kazi na mfululizo wa saa (data kutoka kwa ubadilishanaji, telemetry, kumbukumbu za matukio), kwa sababu ikiwa data itapangwa kulingana na wakati, basi mtumiaji hahitaji kutumia mbinu zozote za SQL kupata safu mlalo ya kwanza au ya mwisho au N. safu kwenye jedwali , amua ni mstari gani unaofuata mstari wa Nth, nk. Viungio vya jedwali hurahisishwa hata zaidi, kwa mfano, kupata nukuu ya mwisho ya miamala 16000 ya VOD.L (Vodafone) kwenye jedwali la vipengele milioni 500 huchukua sekunde moja kwenye diski na makumi ya milisekunde kwenye kumbukumbu.
Mfano wa muda wa kujiunga - jedwali la kunukuu limewekwa kwenye kumbukumbu, kwa hivyo hakuna haja ya kutaja VOD.L ambapo, faharasa kwenye safu wima ya ulinganifu na ukweli kwamba data imepangwa kulingana na wakati hutumiwa kwa njia isiyo wazi. Karibu viungio vyote katika Q ni vitendaji vya kawaida, sio sehemu ya usemi uliochaguliwa:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Hatimaye, inafaa kuzingatia kwamba wahandisi katika KX, kuanzia na Arthur Whitney mwenyewe, wanatatizwa sana na ufanisi na wanajitahidi sana kupata manufaa zaidi kutoka kwa vipengele vya kawaida vya Q na kuboresha mifumo ya kawaida ya matumizi.
Jumla ya
KDB+ ni maarufu miongoni mwa biashara hasa kutokana na utengamano wake wa kipekee - inatumika kwa usawa kama hifadhidata ya kumbukumbu, kama hifadhidata ya kuhifadhi terabaiti za data ya kihistoria, na kama jukwaa la uchanganuzi wa data. Kutokana na ukweli kwamba usindikaji wa data hutokea moja kwa moja kwenye hifadhidata, kasi ya juu ya kazi na akiba ya rasilimali hupatikana. Lugha kamili ya programu iliyojumuishwa na kazi za hifadhidata hukuruhusu kutekeleza safu nzima ya michakato muhimu kwenye jukwaa moja - kutoka kwa kupokea data hadi kusindika maombi ya watumiaji.
Kwa habari zaidi,
Mapungufu
Ubaya mkubwa wa KDB+/Q ni kiwango cha juu cha kuingia. Lugha ina syntax ya kushangaza, kazi zingine zimejaa sana (thamani, kwa mfano, ina kesi 11 za utumiaji). Muhimu zaidi, inahitaji mbinu tofauti kabisa ya kuandika programu. Katika lugha ya vekta, lazima kila wakati ufikirie kuhusu mabadiliko ya safu, utekeleze vitanzi vyote kupitia lahaja kadhaa za utendakazi wa ramani/punguza (ambazo huitwa adverbs katika Q), na usijaribu kamwe kuokoa pesa kwa kubadilisha shughuli za vekta na za atomiki. Kwa mfano, kupata faharisi ya tukio la Nth la kitu katika safu, unapaswa kuandika:
1. (where element=vector)[N]
ingawa hii inaonekana haifai sana kwa viwango vya C/Java (= huunda vekta ya boolean, ambapo inarudisha faharisi za kweli za vitu vilivyomo). Lakini nukuu hii hufanya maana ya usemi kuwa wazi zaidi na unatumia shughuli za vekta haraka badala ya zile za polepole za atomiki. Tofauti ya kimawazo kati ya lugha ya vekta na zingine inalinganishwa na tofauti kati ya mbinu za lazima na za utendaji za programu, na unahitaji kuwa tayari kwa hili.
Watumiaji wengine pia hawafurahii na QSQL. Jambo ni kwamba inaonekana tu kama SQL halisi. Kwa kweli, ni mkalimani tu wa misemo kama SQL ambayo haiauni uboreshaji wa hoja. Mtumiaji lazima aandike maswali bora mwenyewe, na kwa Q, ambayo wengi hawako tayari. Kwa upande mwingine, bila shaka, unaweza daima kuandika swali mojawapo mwenyewe, badala ya kutegemea kiboreshaji cha kisanduku cheusi.
Pamoja na hayo, kitabu kuhusu Q - Q For Mortals kinapatikana bila malipo , pia kuna vifaa vingine vingi muhimu vilivyokusanywa huko.
Hasara nyingine kubwa ni gharama ya leseni. Hiyo ni makumi ya maelfu ya dola kwa mwaka kwa kila CPU. Makampuni makubwa tu yanaweza kumudu gharama hizo. Hivi majuzi, KX imefanya sera yake ya utoaji leseni kuwa rahisi zaidi na inatoa fursa ya kulipia tu muda wa matumizi au kukodisha KDB+ katika Google na Amazon clouds. KX pia inatoa kupakua (toleo la biti 32 au biti 64 kwa ombi).
Washindani
Kuna hifadhidata chache maalum zilizojengwa kwa kanuni zinazofanana - safu, kumbukumbu, inayozingatia idadi kubwa sana ya data. Shida ni kwamba hizi ni hifadhidata maalum. Mfano wa kushangaza ni Clickhouse. Hifadhidata hii ina kanuni sawa na KDB+ ya kuhifadhi data kwenye diski na kuunda faharasa; hufanya maswali kwa haraka zaidi kuliko KDB+, ingawa si kwa kiasi kikubwa. Lakini hata kama hifadhidata, Clickhouse ni maalum zaidi kuliko KDB+ - uchanganuzi wa wavuti dhidi ya mfululizo wa wakati wa kiholela (tofauti hii ni muhimu sana - kwa sababu yake, kwa mfano, katika Clickhouse haiwezekani kutumia kuagiza rekodi). Lakini, muhimu zaidi, Clickhouse haina utofauti wa KDB+, lugha ambayo ingeruhusu usindikaji wa data moja kwa moja kwenye hifadhidata, badala ya kuipakia kwanza kwenye programu tofauti, kujenga misemo ya SQL ya kiholela, kutumia kazi za kiholela katika hoja, kuunda michakato. haihusiani na utekelezaji wa kazi za hifadhidata za kihistoria . Kwa hivyo, ni ngumu kulinganisha KDB+ na hifadhidata zingine; zinaweza kuwa bora zaidi katika hali fulani za utumiaji au bora zaidi linapokuja suala la kazi za msingi za hifadhidata, lakini sijui zana nyingine yenye ufanisi na inayotumika sana ya kuchakata data ya muda.
Ushirikiano wa Python
Ili kufanya KDB+ iwe rahisi kutumia kwa watu wasioifahamu teknolojia, KX iliunda maktaba ili kuunganishwa kwa uthabiti na Python ndani ya mchakato mmoja. Unaweza kupiga kazi yoyote ya Python kutoka Q, au kinyume chake - piga simu kazi yoyote ya Q kutoka Python (haswa, misemo ya QSQL). Maktaba hubadilisha, ikiwa ni lazima (si mara zote kwa ajili ya ufanisi), data kutoka umbizo la lugha moja hadi umbizo la nyingine. Kama matokeo, Q na Python wanaishi katika symbiosis ya karibu sana kwamba mipaka kati yao imefichwa. Kama matokeo, programu, kwa upande mmoja, ina ufikiaji kamili wa maktaba nyingi muhimu za Python, kwa upande mwingine, anapokea msingi wa haraka wa kufanya kazi na data kubwa iliyojumuishwa kwenye Python, ambayo ni muhimu sana kwa wale wanaohusika katika ujifunzaji wa mashine. au modeli.
Kufanya kazi na Q katika Python:
1. >>> q()
2.q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
marejeo
Mahali pa kampuni -
Tovuti ya watengenezaji -
Kitabu Q For Mortals (kwa Kiingereza) -
Nakala juu ya maombi ya KDB+/Q kutoka kwa wafanyikazi wa kx -
Chanzo: mapenzi.com
