

KDB+, şirket ürünü zaman serilerini ve bunlara dayalı analitik hesaplamaları depolamak için tasarlanmış, dar çevrelerde yaygın olarak bilinen, son derece hızlı, sütunlu bir veritabanıdır. Başlangıçta, finans sektöründe çok popülerdi (ve hala da öyle) - ilk 10 yatırım bankasının tümü ve birçok tanınmış hedge fonu, borsa ve diğer kuruluşlar bunu kullanıyor. Son zamanlarda KX, müşteri tabanını genişletmeye karar verdi ve şimdi telekom, biyoenformatik, üretim vb. gibi zamana veya başka bir şekilde düzenlenmiş büyük miktarda verinin bulunduğu diğer alanlarda çözümler sunuyor. Ayrıca Formula 1'deki Aston Martin Red Bull Racing ekibinin ortağı oldular ve burada araba sensörlerinden veri toplanmasına ve işlenmesine ve rüzgar tüneli testlerinin analiz edilmesine yardımcı oldular. Bu makalede size KDB+'ın hangi özelliklerinin onu süper performanslı hale getirdiğini, şirketlerin neden buna çok fazla para harcamaya istekli olduklarını ve son olarak neden gerçekte bir veritabanı olmadığını anlatmak istiyorum.
Bu yazımda sizlere genel olarak KDB+'ın ne olduğunu, hangi yeteneklere ve sınırlamalara sahip olduğunu, büyük miktarda veri işlemek isteyen şirketler için faydalarının neler olduğunu anlatmaya çalışacağım. KDB+'ın uygulanmasının ayrıntılarına veya Q programlama dilinin ayrıntılarına girmeyeceğim. Bu konuların her ikisi de çok geniştir ve ayrı makaleleri hak etmektedir. Bu konularla ilgili birçok bilgiyi code.kx.com adresinde bulabilirsiniz; buna Q - Q For Mortals hakkındaki bir kitap da dahildir (aşağıdaki bağlantıya bakın).
Bazı terimler
- Bellek içi veritabanı. Daha hızlı erişim için verileri RAM'de saklayan bir veritabanı. Böyle bir veritabanının avantajları açıktır ancak dezavantajları veri kaybı olasılığı ve sunucuda çok fazla belleğe sahip olma ihtiyacıdır.
- Sütunlu veritabanı. Verilerin kayıt kayıt yerine sütun sütun depolandığı bir veritabanı. Böyle bir veritabanının temel avantajı, bir sütundaki verilerin diskte ve bellekte birlikte saklanmasıdır, bu da ona erişimi önemli ölçüde hızlandırır. Sorguda kullanılmayan sütunları yüklemenize gerek yoktur. En büyük dezavantajı kayıtları değiştirmenin ve silmenin zor olmasıdır.
- Zaman serisi. Tarih veya saat sütunu içeren veriler. Tipik olarak, hangi kaydın geçerli kayıttan önce veya sonra geldiğini kolayca belirleyebilmeniz veya sonuçları kayıtların sırasına bağlı olan işlevleri uygulayabilmeniz için bu tür veriler için zaman sıralaması önemlidir. Klasik veritabanları tamamen farklı bir prensip üzerine inşa edilmiştir; kayıtların sırasının prensipte tanımlanmadığı bir kayıt koleksiyonunu bir küme olarak temsil eder.
- Vektör. KDB+ bağlamında bu, aynı atom tipindeki öğelerin (örneğin sayılar) bir listesidir. Başka bir deyişle, bir dizi öğe. Diziler, listelerden farklı olarak kompakt bir şekilde saklanabilir ve vektör işlemci talimatları kullanılarak işlenebilir.
Tarihsel bilgi
KX, 1993 yılında, daha önce Morgan Stanley Bank'ta, finans dünyasında çok orijinal ve bir zamanlar popüler bir dil olan APL'nin halefi olan A+ dili üzerinde çalışmış olan Arthur Whitney tarafından kuruldu. Elbette Arthur, KX'te de aynı ruhu sürdürdü ve radikal minimalizm fikirlerinin rehberliğinde vektör fonksiyonlu K dilini yarattı. K programları, noktalama işaretleri ve özel karakterlerden oluşan bir karmaşa gibi görünür, işaretlerin ve işlevlerin anlamı bağlama bağlıdır ve her işlem, geleneksel programlama dillerinde olduğundan çok daha fazla anlam taşır. Bu nedenle, bir K programı çok az yer kaplar (Java gibi ayrıntılı bir dilde birkaç satır, sayfalarca metnin yerini alabilir) ve algoritmanın son derece konsantre bir uygulamasıdır.
Belirli bir dilbilgisine göre LL1 ayrıştırıcı oluşturucunun çoğunu uygulayan K'daki bir işlev:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/:1_r),"]";""]]}
Arthur, bu aşırı verimlilik felsefesini minimum vücut hareketleriyle 2003 yılında ortaya çıkan (sanırım isimdeki K harfinin nereden geldiği artık açık) KDB+'da somutlaştırdı ve K'nin dördüncü versiyonunun yorumlayıcısından başka bir şey değil. KK'nin üzerine Q adı verilen daha kullanıcı dostu bir sürüm eklendi. Q ayrıca belirli bir SQL lehçesi için destek - QSQL ve yorumlayıcı - sistem veri türü olarak tablolar için destek, tablolarla çalışmaya yönelik araçlar ekledi. bellekte ve diskte vb.
Yani kullanıcının bakış açısına göre KDB+, C#'tan tablolar ve SQL benzeri LINQ tarzı ifadeler desteğine sahip bir Q dili yorumlayıcısıdır. Bu, KDB+ ile diğer veritabanları arasındaki en önemli farktır ve genellikle göz ardı edilen temel rekabet avantajıdır. Bu bir veritabanı + devre dışı bırakılmış yardımcı dil değil, tam teşekküllü güçlü bir programlama dili + veritabanı işlevleri için yerleşik destektir. Bu ayrım, KDB+'ın tüm faydalarının listelenmesinde belirleyici bir rol oynayacaktır. Örneğin…
boyut
Modern standartlara göre KDB+'ın boyutu mikroskobiktir. Kelimenin tam anlamıyla bir megabaytın altında yürütülebilir dosya ve bazı sistem işlevlerini içeren küçük bir metin dosyasıdır. Gerçekte - bir megabayttan az ve bu program için şirketler, sunucudaki bir işlemciye yılda onbinlerce dolar ödüyor.
- Bu boyut, KDB+'ın Pi mikro bilgisayarlarından terabaytlarca belleğe sahip sunuculara kadar her türlü donanımda harika hissetmesini sağlar. Bu, işlevselliği hiçbir şekilde etkilemez; ayrıca Q anında başlar ve bu da onun diğer şeylerin yanı sıra bir komut dosyası dili olarak kullanılmasına olanak tanır.
- Bu boyutta, Q yorumlayıcısı tamamen işlemci önbelleğine sığar ve bu da programın yürütülmesini hızlandırır.
- Yürütülebilir dosyanın bu boyutuyla, Q işlemi bellekte ihmal edilebilecek kadar yer kaplar; yüzlercesini çalıştırabilirsiniz. Üstelik Q, gerektiğinde tek bir işlem içerisinde onlarca, yüzlerce gigabaytlık bellekle çalışabiliyor.
çok yönlülük
Q, geniş bir uygulama yelpazesi için mükemmeldir. Process Q, tarihsel bir veritabanı görevi görebilir ve terabaytlarca bilgiye hızlı erişim sağlayabilir. Örneğin, bazılarında sıkıştırılmamış bir günlük verinin 100 gigabayttan fazla yer kapladığı düzinelerce geçmiş veritabanımız var. Ancak makul kısıtlamalar altında, veritabanına yapılan bir sorgu onlarca ila yüzlerce milisaniye içinde tamamlanacaktır. Genel olarak, kullanıcı istekleri için evrensel bir zaman aşımımız vardır (30 saniye) ve bu çok nadiren çalışır.
Q, kolaylıkla bir bellek içi veritabanı da olabilir. Yeni veriler bellek içi tablolara o kadar hızlı eklenir ki kullanıcı istekleri sınırlayıcı faktör olur. Tablolardaki veriler sütunlarda saklanır; bu, bir sütundaki herhangi bir işlemin işlemci önbelleğini tam kapasiteyle kullanacağı anlamına gelir. Buna ek olarak KX, işlemcinin vektör talimatları aracılığıyla aritmetik gibi tüm temel işlemleri gerçekleştirerek hızlarını maksimuma çıkarmaya çalıştı. Q ayrıca veritabanları için tipik olmayan görevleri de gerçekleştirebilir - örneğin, akış verilerini işlemek ve "gerçek zamanlı" olarak hesaplamak (göreve bağlı olarak onlarca milisaniyeden birkaç saniyeye kadar bir gecikmeyle), farklı zamanlar için finansal araçlar için çeşitli toplama işlevleri aralıklarla veya mükemmel işlemlerin piyasaya etkisine ilişkin bir model oluşturun ve profil oluşturma işlemini tamamlandıktan hemen sonra gerçekleştirin. Bu tür görevlerde, çoğu zaman ana zaman gecikmesi Q değil, farklı kaynaklardan gelen verileri senkronize etme ihtiyacıdır. Verilerin ve bunları işleyen işlevlerin tek bir işlemde olması ve işlemin, yorumlanmayan ancak ikili kod tarafından yürütülen birkaç QSQL ifadesinin ve birleşiminin yürütülmesine indirgenmesi nedeniyle yüksek hız elde edilir.
Son olarak, herhangi bir hizmet sürecini Q'ya yazabilirsiniz. Örneğin, kullanıcı isteklerini otomatik olarak gerekli veritabanlarına ve sunuculara dağıtan Gateway işlemleri. Programcı, dengeleme, önceliklendirme, hata toleransı, erişim hakları, kotalar ve temel olarak kalbinin arzu ettiği her şey için herhangi bir algoritmayı uygulama özgürlüğüne sahiptir. Buradaki asıl sorun, tüm bunları kendinizin uygulamak zorunda kalacak olmanızdır.
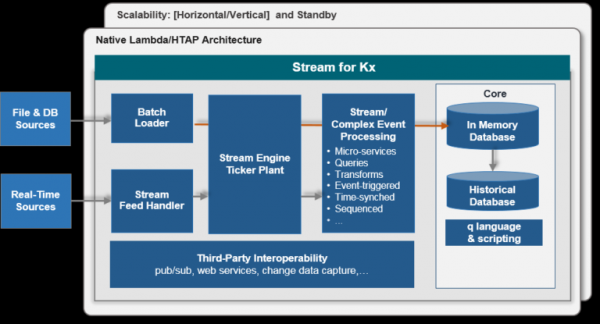
Örnek olarak ne tür süreçlerimiz olduğunu listeleyeceğim. Hepsi aktif olarak kullanılmakta ve birlikte çalışarak onlarca farklı veritabanını tek bir veritabanında birleştirerek, birden fazla kaynaktan gelen verileri işleyerek yüzlerce kullanıcıya ve uygulamaya hizmet vermektedir.
- Veri kaynaklarına yönelik bağlayıcılar (besleme işleyicisi). Bu işlemler genellikle Q'ya yüklenen harici kitaplıkları kullanır. Q'daki C arayüzü son derece basittir ve herhangi bir C/C++ kitaplığı için kolayca proxy işlevleri oluşturmanıza olanak tanır. Q, örneğin tüm Avrupa borsalarından gelen bir dizi FIX mesajını aynı anda işlemeye yetecek kadar hızlıdır.
- Veri dağıtıcıları (tickerplant), Konektörler ve tüketiciler arasında bir ara bağlantı görevi gören. Aynı zamanda gelen verileri özel bir ikili günlüğe yazarak tüketicilere bağlantı kayıplarına veya yeniden başlatmalara karşı dayanıklılık sağlarlar.
- Bellek içi veritabanı (rdb). Bu veritabanları ham, taze verileri hafızada saklayarak mümkün olan en hızlı erişimi sağlar. Tipik olarak gündüzleri tablolarda veri biriktirirler ve geceleri sıfırlarlar.
- Kalıcı veritabanı (pdb). Bu veritabanları bugüne ait verilerin geçmişe ait bir veri tabanında saklanmasını sağlar. Kural olarak, rdb'den farklı olarak, verileri hafızada saklamazlar, ancak gün boyunca diskte özel bir önbellek kullanırlar ve verileri gece yarısı tarihsel veritabanına kopyalarlar.
- Tarihsel veritabanları (hdb). Bu veritabanları geçmiş günlere, aylara ve yıllara ait verilere erişim sağlar. Boyutları (gün cinsinden) yalnızca sabit sürücülerin boyutuyla sınırlıdır. Veriler herhangi bir yere, özellikle erişimi hızlandırmak için farklı disklere yerleştirilebilir. Aralarından seçim yapabileceğiniz çeşitli algoritmalar kullanarak verileri sıkıştırmak mümkündür. Veritabanının yapısı iyi belgelenmiştir ve basittir; veriler, işletim sistemi aracılığıyla da işlenebilmeleri için normal dosyalarda sütun sütun depolanır.
- Toplu bilgi içeren veritabanları. Genellikle enstrüman adı ve zaman aralığına göre gruplandırılmış çeşitli toplamaları depolarlar. Bellek içi veritabanları, gelen her mesajla durumlarını günceller ve geçmiş veritabanları, geçmiş verilere erişimi hızlandırmak için önceden hesaplanmış verileri saklar.
- Son olarak, ağ geçidi süreçleriuygulamalara ve kullanıcılara hizmet vermek. Q, gelen mesajların tamamen eşzamansız işlenmesini, veritabanlarına dağıtılmasını, erişim haklarının kontrol edilmesini vb. sağlar. Mesajların sınırlı olmadığını ve diğer veritabanlarında olduğu gibi çoğunlukla SQL ifadeleri olmadığını unutmayın. Çoğu zaman, SQL ifadesi özel bir işlevde gizlenir ve kullanıcı tarafından talep edilen parametrelere göre oluşturulur - zaman dönüştürülür, filtrelenir, veriler normalleştirilir (örneğin, temettü ödenirse hisse senedi fiyatı eşitlenir), vb.
Bir veri türü için tipik mimari:
hız
Q yorumlanmış bir dil olmasına rağmen aynı zamanda bir vektör dilidir. Bu, pek çok yerleşik fonksiyonun, özellikle aritmetik olanların, herhangi bir biçimde (sayılar, vektörler, matrisler, listeler) argümanlar aldığı ve programcının programı dizi işlemleri olarak uygulamasının beklendiği anlamına gelir. Böyle bir dilde, bir milyon öğeden oluşan iki vektörü toplarsanız, artık dilin yorumlanmasının bir önemi kalmaz; ekleme işlemi süper optimize edilmiş bir ikili işlev tarafından gerçekleştirilecektir. Q programlarında zamanın aslan payı, bu temel vektörleştirilmiş işlevleri kullanan tablolarla yapılan işlemlere harcandığından, çıktı çok makul bir çalışma hızıdır ve tek bir işlemde bile büyük miktarda veriyi işlememize olanak tanır. Bu, Python'daki matematik kitaplıklarına benzer - Python'un kendisi çok yavaş bir dil olmasına rağmen, sayısal verileri derlenmiş bir dilin hızında işlemenize olanak tanıyan numpy gibi birçok mükemmel kitaplığa sahiptir (bu arada, numpy ideolojik olarak Q'ya yakındır) ).
Ayrıca KX, masaları tasarlarken ve onlarla çalışmayı optimize ederken çok dikkatli bir yaklaşım sergiledi. İlk olarak, yerleşik işlevler tarafından desteklenen ve yalnızca tablo sütunlarına değil aynı zamanda herhangi bir vektöre (gruplandırma, sıralama, benzersizlik özelliği ve tarihsel veritabanları için özel gruplandırma) uygulanabilen çeşitli dizin türleri desteklenir. İndeks basit bir şekilde uygulanır ve sütuna/vektöre öğeler eklenirken otomatik olarak ayarlanır. Dizinler hem bellekteki hem de diskteki tablo sütunlarına eşit derecede başarılı bir şekilde uygulanabilir. Bir QSQL sorgusu yürütülürken mümkünse dizinler otomatik olarak kullanılır. İkinci olarak, geçmiş verilerle çalışma, işletim sistemi dosyalarını (bellek haritası) görüntüleme mekanizması aracılığıyla yapılır. Büyük tablolar hiçbir zaman belleğe yüklenmez; bunun yerine gerekli sütunlar doğrudan belleğe eşlenir ve yalnızca ihtiyaç duyulan kısmı yüklenir (indeksler de burada yardımcı olur). Programcı için verinin bellekte olup olmamasının hiçbir önemi yoktur; mmap ile çalışma mekanizması tamamen Q'nun bağırsaklarında gizlidir.
KDB+ ilişkisel bir veritabanı değildir; tablolar rastgele veriler içerebilir, yeni öğeler eklendiğinde tablodaki satırların sırası değişmez ve sorgu yazarken kullanılabilir ve kullanılmalıdır. Bu özellik, zaman serileriyle (borsalardan, telemetriden, olay günlüklerinden gelen veriler) çalışmak için acilen gereklidir, çünkü veriler zamana göre sıralanırsa kullanıcının ilk veya son satırı veya N'yi bulmak için herhangi bir SQL hilesi kullanmasına gerek kalmaz. tablodaki satırlar, hangi satırın N'inci satırdan sonra geldiğini vb. belirler. Tablo birleştirmeleri daha da basitleştirilmiştir; örneğin, 16000 milyon öğeden oluşan bir tabloda 500 VOD.L (Vodafone) işleminin son teklifini bulmak, diskte yaklaşık bir saniye, bellekte ise onlarca milisaniye sürer.
Zaman birleşimine bir örnek - alıntı tablosu belleğe eşlenir, bu nedenle burada VOD.L'yi belirtmeye gerek yoktur, sym sütunundaki dizin ve verilerin zamana göre sıralandığı gerçeği örtülü olarak kullanılır. Q'daki hemen hemen tüm birleşimler, bir select ifadesinin parçası değil, normal işlevlerdir:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Son olarak, Arthur Whitney'den başlayarak KX'teki mühendislerin verimlilik konusunda gerçekten takıntılı olduklarını ve Q'nun standart özelliklerinden en iyi şekilde yararlanmak ve en yaygın kullanım modellerini optimize etmek için büyük çaba harcadıklarını belirtmekte fayda var.
sonuç
KDB+, olağanüstü çok yönlülüğü nedeniyle işletmeler arasında popülerdir - bellek içi veritabanı olarak, terabaytlarca geçmiş veriyi depolamak için bir veritabanı olarak ve veri analizi için bir platform olarak eşit derecede iyi hizmet eder. Veri işlemenin doğrudan veritabanında gerçekleşmesi nedeniyle yüksek çalışma hızı ve kaynak tasarrufu sağlanır. Veritabanı işlevleriyle entegre edilmiş tam teşekküllü bir programlama dili, veri almaktan kullanıcı isteklerini işlemeye kadar gerekli süreçlerin tüm yığınını tek bir platformda uygulamanıza olanak tanır.
Daha fazla bilgi için,
Dezavantajları:
KDB+/Q'nun önemli bir dezavantajı yüksek giriş eşiğidir. Dilin tuhaf bir sözdizimi var, bazı işlevler aşırı yüklenmiş (örneğin, değerin yaklaşık 11 kullanım durumu var). En önemlisi, program yazmaya tamamen farklı bir yaklaşım gerektirir. Bir vektör dilinde, her zaman dizi dönüşümleri açısından düşünmeli, tüm döngüleri harita/azaltma işlevlerinin (Q'da zarflar olarak adlandırılan) çeşitli varyantları aracılığıyla uygulamalı ve asla vektör işlemlerini atomik işlemlerle değiştirerek paradan tasarruf etmeye çalışmamalısınız. Örneğin, bir dizideki bir öğenin N'inci oluşumunun dizinini bulmak için şunu yazmalısınız:
1. (where element=vector)[N]
Her ne kadar bu, C/Java standartlarına göre son derece verimsiz görünse de (= içindeki öğelerin gerçek dizinlerini döndüren bir boole vektörü oluşturur). Ancak bu gösterim ifadenin anlamını daha net hale getirir ve yavaş atomik işlemler yerine hızlı vektör işlemlerini kullanırsınız. Vektör dili ile diğerleri arasındaki kavramsal fark, programlamaya zorunlu ve işlevsel yaklaşımlar arasındaki farkla karşılaştırılabilir ve buna hazırlıklı olmanız gerekir.
Bazı kullanıcılar da QSQL'den memnun değil. Mesele şu ki, sadece gerçek SQL'e benziyor. Gerçekte, sorgu optimizasyonunu desteklemeyen, SQL benzeri ifadelerin yalnızca bir yorumlayıcısıdır. Kullanıcının, çoğu kişinin hazır olmadığı en uygun sorguları kendisi ve Q'da yazması gerekir. Öte yandan, elbette, bir kara kutu optimizasyon aracına güvenmek yerine her zaman en uygun sorguyu kendiniz yazabilirsiniz.
Artı olarak, Q - Q For Mortals hakkındaki bir kitap şu adreste ücretsiz olarak mevcuttur: Ayrıca orada toplanan birçok başka faydalı malzeme de var.
Bir diğer büyük dezavantaj ise lisansın maliyetidir. Bu, CPU başına yılda onbinlerce dolar demektir. Bu tür masrafları ancak büyük şirketler karşılayabilir. Son zamanlarda KX, lisanslama politikasını daha esnek hale getirerek yalnızca kullanım süresi kadar ödeme yapma veya Google ve Amazon bulutlarında KDB+ kiralama fırsatı sunuyor. KX ayrıca indirme olanağı da sunuyor (32 bit versiyon veya istek üzerine 64 bit).
rakipler
Benzer ilkeler üzerine inşa edilmiş çok sayıda özel veri tabanı vardır - sütunlu, bellek içi, çok büyük miktarda veriye odaklanmış. Sorun, bunların özel veritabanları olmasıdır. Çarpıcı bir örnek Clickhouse'dur. Bu veritabanı, verileri diskte depolamak ve dizin oluşturmak için KDB+'ya çok benzer bir prensibe sahiptir; bazı sorguları, önemli ölçüde olmasa da, KDB+'dan daha hızlı gerçekleştirir. Ancak bir veritabanı olarak bile Clickhouse, KDB+'dan daha uzmanlaşmıştır - web analitiği ve rastgele zaman serileri (bu fark çok önemlidir; bu nedenle, örneğin Clickhouse'da kayıtların sırasını kullanmak mümkün değildir). Ancak en önemlisi Clickhouse, verileri önce ayrı bir uygulamaya yüklemek, rastgele SQL ifadeleri oluşturmak, bir sorguda rastgele işlevler uygulamak, süreçler oluşturmak yerine doğrudan veritabanında işlemeye izin veren bir dil olan KDB+'ın çok yönlülüğüne sahip değil. geçmiş veritabanı işlevlerinin yürütülmesiyle ilgili değildir. Bu nedenle, KDB+'ı diğer veritabanlarıyla karşılaştırmak zordur; belirli kullanım durumlarında daha iyi olabilirler veya klasik veritabanı görevleri söz konusu olduğunda daha iyi olabilirler, ancak geçici verileri işlemek için eşit derecede etkili ve çok yönlü başka bir araç bilmiyorum.
Python entegrasyonu
KDB+'ın teknolojiye aşina olmayan kişiler için kullanımını kolaylaştırmak amacıyla KX, tek bir işlemle Python ile sıkı bir şekilde entegre olacak kütüphaneler oluşturdu. Q'dan herhangi bir Python işlevini çağırabilir veya tam tersini yapabilirsiniz; Python'dan herhangi bir Q işlevini (özellikle QSQL ifadelerini) çağırabilirsiniz. Kütüphaneler, gerekirse (her zaman verimlilik açısından olmasa da) verileri bir dilin formatından diğerinin formatına dönüştürür. Sonuç olarak Q ve Python o kadar yakın bir simbiyoz içinde yaşıyor ki aralarındaki sınırlar bulanıklaşıyor. Sonuç olarak, programcı bir yandan çok sayıda yararlı Python kütüphanesine tam erişime sahip olurken, diğer yandan Python'a entegre edilmiş büyük verilerle çalışmak için hızlı bir temel elde eder ve bu özellikle makine öğrenimiyle ilgilenenler için faydalıdır. veya modelleme.
Python'da Q ile çalışmak:
1. >>> q()
2.q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
referanslar
Şirketin sitesi -
Geliştiriciler için web sitesi -
Ölümlüler İçin Kitap Q (İngilizce) -
kx çalışanlarından KDB+/Q uygulamalarına ilişkin makaleler -
Kaynak: habr.com
