

经过五个月的开发,IncidentRelay 1.1 正式发布。它是一个开源系统,用于值班管理、告警路由和事件响应,运行于自托管服务器上。IncidentRelay 1.1 是首个稳定版本(1.0 分支为 beta 版)。该项目面向 SRE、DevOps 和基础设施团队,旨在为他们提供本地部署的值班管理、升级策略和事件响应的替代方案,以取代 SaaS 服务。项目代码使用 Python 编写,并以 MIT 许可证发布。
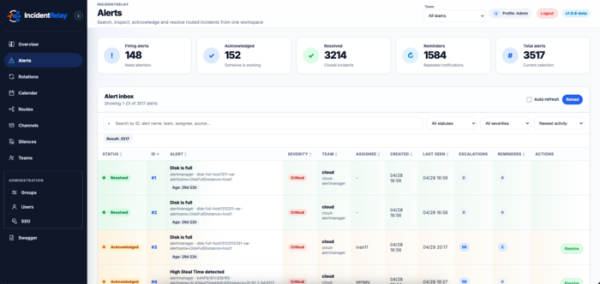
IncidentRelay 系统接收来自监控系统的事件,将其与服务、团队和轮班安排进行匹配,然后将通知发送给负责的值班人员或团队。该系统实现了值班表、轮班安排、班次变更、事件确认、ACK/解决状态、提醒、升级、临时值班人员替换、计划维护时间和警报抑制等功能。
该项目的主要优势在于对基础设施和路由逻辑的完全控制。IncidentRelay 部署在独立的环境中,使用独立的数据库,并允许对传入路由、命令、轮换和交付渠道进行显式分离。传入的令牌属于路由,而非渠道,这使得理解哪个外部源有权向特定命令发送事件变得更加容易。
IncidentRelay 支持接收来自 Prometheus Alertmanager、Grafana Alerting、Zabbix、Sentry、LibreNMS、RMON、AWS SNS/CloudWatch 以及自定义 Webhook 的事件。通知可以通过 Mattermost、Slack、Telegram、Discord、Microsoft Teams、电子邮件、Webhook、浏览器/PWA 推送以及语音通话提供商发送。在 Mattermost 和 Telegram 中,通知可以包含确认和解决问题的操作,从而无需切换到单独的界面即可处理事件。
该项目可以通过 Docker Compose(适用于 Red Hat 等发行版的 RPM 包)、systemd 手动运行,或者在 Kubernetes 中使用 Helm chart 运行。小型安装可以使用 SQLite,而生产环境和高负载场景建议使用 PostgreSQL。
新版本提出了以下更改:
- 增加了多级值班轮换制度,并设定了时间限制、层级优先级,以及考虑临时替补人员;
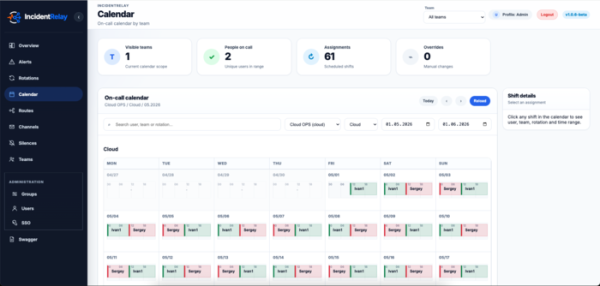
- 已出现值班日历、CalDAV 和 ICS 外部日历订阅;
- 实施了包含多步骤升级链的事件升级策略;
- 新增警报组、事件分组、延迟通知和相关警报手动合并功能;
- 已出现用于计划工作和“静默”警报的窗口;
- 增加了在提醒中添加评论的功能;
- 增加了事件优先级(P1-P5)和基于重要性的自动优先级升级;
- 实现了服务目录、服务依赖关系、SLI/SLO、服务影响历史记录和业务服务;
- 新增了“解释跟踪”功能,用于分析路由:解释为什么警报包含在命令中或未包含在命令中、被分组、被抑制或被发送到特定通道;
- 为看门狗、备份、ETL 和其他任务添加了检查(心跳/死人开关),这些任务的问题是缺少预期信号。
来源: opennet.ru
