

مقدمة
هناك أداة بسيطة ومفيدة للغاية في العالم - ، وقد حدث أنه كان متأصلًا في عملية الإنتاج لدينا لفترة طويلة جدًا (على الرغم من أنه لم يكن من الممكن تثبيت نسخته، لكنه بالتأكيد لم يكن الإصدار الأخير المتاح). نحن نستخدمه للغرض المقصود منه - وهو بناء تصحيحات ثنائية. إذا نظرت إلى ما هو موجود في المستودع، يصبح الأمر محزنًا بعض الشيء: في الواقع، تم التخلي عنه منذ وقت طويل والكثير منه قديم جدًا (قام زميلي السابق بإجراء عدة تعديلات هناك، لكن ذلك كان منذ وقت طويل) . بشكل عام، قررت إحياء هذا الأمر: لقد تشعبت، وتخلصت مما لم أخطط لاستخدامه، ونقلت المشروع إلى ، الوظائف الدقيقة المضمنة "الساخنة"، وإزالة المصفوفات الكبيرة من المكدس (والصفائف ذات الطول المتغير، والتي تجعلني "قنبلة" بصراحة)، وقمت بتشغيل ملف التعريف مرة أخرى - واكتشفت أن حوالي 40٪ من الوقت يتم إنفاقه على ...
إذن ما الأمر مع fwrite؟
في هذا الكود، يتم استدعاء fwrite (في حالة الاختبار الخاصة بي: إنشاء تصحيح بين ملفات قريبة بحجم 300 ميجابايت، وبيانات الإدخال موجودة بالكامل في الذاكرة) بملايين المرات مع حجم مخزن مؤقت صغير. من الواضح أن هذا الشيء سوف يتباطأ، وبالتالي أود التأثير بطريقة أو بأخرى على هذا العار. ليست هناك رغبة حتى الآن في تنفيذ أنواع مختلفة من مصادر البيانات، المدخلات والمخرجات غير المتزامنة، أردت إيجاد حل أبسط. أول ما يتبادر إلى الذهن هو زيادة حجم المخزن المؤقت
setvbuf(file, nullptr, _IOFBF, 64* 1024)لكنني لم أحصل على تحسن كبير في النتيجة (يمثل fwrite الآن حوالي 37% من الوقت) - مما يعني أن الأمر لا يتعلق بعد بكتابة البيانات بشكل متكرر على القرص. بالنظر "تحت غطاء" fwrite، يمكنك أن ترى أن بنية القفل/إلغاء القفل FILE تحدث داخل شيء مثل هذا (رمز زائف، تم إجراء جميع التحليلات ضمن Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
وفقًا لمحلل التعريف، يمثل _fwrite_nolock 6% فقط من الوقت، والباقي عبارة عن نفقات عامة. في حالتي الخاصة، من الواضح أن أمان الخيط مبالغ فيه، لذا سأضحي به عن طريق استبدال استدعاء fwrite بـ - لا تحتاج حتى إلى أن تكون ذكيًا في الحجج. الإجمالي: أدى هذا التلاعب البسيط إلى تقليل تكلفة تسجيل النتيجة بشكل كبير، والتي بلغت في النسخة الأصلية ما يقرب من نصف الوقت المستغرق. بالمناسبة، في عالم POSIX هناك وظيفة مماثلة - . بشكل عام، الأمر نفسه ينطبق على الخبز. وبالتالي، باستخدام زوج من التعريفات، يمكنك الحصول على حل متعدد المنصات بالكامل بدون أقفال غير ضرورية إذا لم تكن ضرورية (وهذا يحدث كثيرًا).
fwrite، _fwrite_nolock، setvbuf
لننتقل من المشروع الأصلي إلى اختبار حالة محددة: كتابة ملف كبير (512 ميجابايت) على أجزاء صغيرة للغاية - بايت واحد لكل جزء. نظام الاختبار: معالج AMD Ryzen 7 1700، ذاكرة وصول عشوائي 16 جيجابايت، قرص صلب بسرعة 7200 دورة في الدقيقة، ذاكرة تخزين مؤقتة 64 ميجابايت. Windows 10 في عام 1809، تم بناء الملف الثنائي كـ 32 بت، وتم تمكين التحسينات، وتم ربط المكتبة بشكل ثابت.
عينة للتجربة:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
ستكون المتغيرات TEST_BUFFER_SIZE، وفي بعض الحالات سوف نستبدل fwrite_unlocked بـ fwrite. لنبدأ بحالة fwrite دون تحديد حجم المخزن المؤقت بشكل صريح (علق على setvbuf والكود المرتبط): الوقت 27048906 ميكروثانية، سرعة الكتابة - 18.93 ميجابايت/ثانية. لنقم الآن بتعيين حجم المخزن المؤقت على 64 كيلو بايت: الوقت - 25037111 ميكروثانية، السرعة - 20.44 ميجا بايت/ثانية. الآن دعونا نختبر تشغيل _fwrite_nolock دون استدعاء setvbuf: 7262221 ميكروثانية، السرعة - 70.5 ميجا بايت/ثانية!
بعد ذلك، دعونا نجرب حجم المخزن المؤقت (setvbuf):
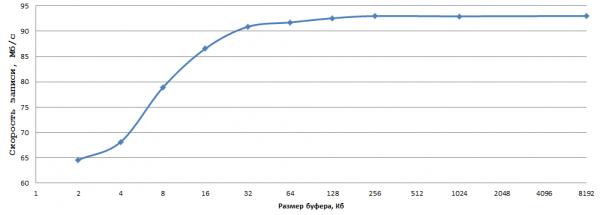
تم الحصول على البيانات من خلال متوسط 5 تجارب، وكنت كسولًا جدًا لدرجة أنني لم أتمكن من حساب الأخطاء. بالنسبة لي، تعد سرعة 93 ميجابايت/ثانية عند كتابة بايت واحد على محرك أقراص ثابت عادي نتيجة جيدة جدًا، كل ما عليك فعله هو تحديد حجم المخزن المؤقت الأمثل (في حالتي، 1 كيلو بايت هو الحجم المناسب تمامًا) واستبدال fwrite بـ _fwrite_nolock/fwrite_unlocked ( في حالة عدم الحاجة إلى سلامة الخيط بالطبع).
وبالمثل مع الخبز في ظروف مماثلة. وبما أنني لا أملك جهازًا يعمل بنظام التشغيل Linux في متناول اليد (لا يتم احتساب أجهزة الكمبيوتر ذات اللوحة الواحدة)، فقد قررت إجراء تجربة محدودة على جهاز افتراضي (Hyper-V، OpenSUSE 15،GC 8.3.1) - النمط، من حيث المبدأ، هو نفسه: fwrite "عاري" 20 ميجا بايت / ثانية، fwrite + 256 كيلو بايت المخزن المؤقت ينتج 23 ميجا بايت / ثانية، fwrite_unlocked بنفس المخزن المؤقت - 35 ميجا بايت / ثانية (ثنائي 64 بت، مجمع g++ -o2 - s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
خاتمة
كان الغرض من كتابة هذه المقالة هو وصف تقنية بسيطة وفعالة في كثير من الحالات (لم يسبق لي أن واجهت وظائف _fwrite_nolock/fwrite_unlocked من قبل، فهي لا تحظى بشعبية كبيرة - ولكن دون جدوى). لا أدعي أن المادة جديدة، لكن أتمنى أن تكون المقالة مفيدة للمجتمع.
المصدر: www.habr.com
