

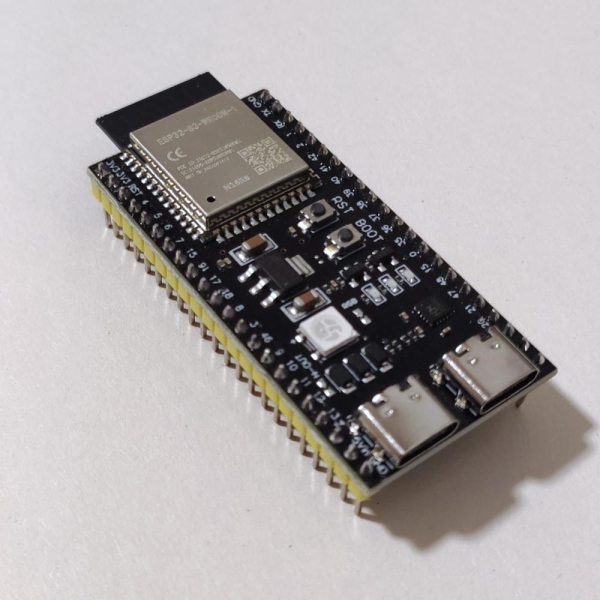
Programer Vyacheslav Serbov, koji nosi pseudonim slvDev, demonstrirano Potpuno lokalno generiranje teksta na ESP32-S3 mikrokontroleru. Rezultirajući jezički model sadrži 28,9 miliona parametara i proizvodi približno 9,9 tokena u sekundi bez pristupa serveru ili drugim vanjskim računarskim resursima. Generirane kratke priče prikazuju se na povezanom OLED ekranu.
Projekat esp32-ai Testirano na ESP32-S3 N16R8 modulu sa 512 KB ugrađene SRAM memorije, 8 MB PSRAM memorije i 16 MB fleš memorije. 4-bitni kvantizirani model zauzima 14,9 MB. Repozitorij sadrži izvorni kod za C runtime, alate za obuku i kvantizaciju, firmver, testove i skripte za postavljanje na ploču.
Navedenih 28,9 miliona parametara ne bi trebalo direktno porediti sa brojem parametara konvencionalnih LLM-ova za desktop računare. Prema detaljan izvještaj za programereModel se sastoji od gustog računarskog jezgra sa približno 559 parametara, izlaznog sloja sa 3,1 milionom parametara i tabele slojevitih vektorskih reprezentacija sa približno 25 miliona parametara. Potonja predstavlja većinu formalne veličine modela, ali se ne obrađuje u potpunosti prilikom generisanja svakog tokena.
Za pohranjivanje modela koriste se tri memorijska nivoa. Najčešće pristupani podaci nalaze se u internom SRAM-u, izlazni sloj, KV keš memorija i privremeni baferi nalaze se u PSRAM-u, a tabela od 25 miliona stavki nalazi se u fleš memoriji i dostupna joj je putem mapiranja adresnog prostora. Za svaki token, iz njega se čita samo oko šest redova, što ukupno iznosi približno 450 bajtova.
Ovaj uređaj je zasnovan na tehnologiji Per-Layer Embeddings koju Google koristi u Gemma 3n. Prema Google dokumentacijaPLE parametri se mogu pohraniti izvan radne memorije modela i dodati procesu zaključivanja kako se pojedinačni slojevi obrađuju. U esp32-ai, ovaj pristup je proširen na hijerarhiju memorije mikrokontrolera, gdje je brzi SRAM posebno ograničen.
Prva ispravna verzija C-baziranog runtime okruženja proizvodila je samo 0,57 tokena u sekundi. Nakon postavljanja izlaznog sloja u PSRAM, prelaska na osmobitne aktivacije, distribucije izračunavanja između dvije Xtensa LX7 jezgre i drugih optimizacija, latencija je smanjena na 94,9 ms po koraku modela. Konačni izmjereni protok dostigao je 9,88 tokena u sekundi, uzimajući u obzir puni proces generiranja. Glavno ograničenje sada je postao propusni opseg PSRAM-a pri čitanju izlaznog sloja.
Model je obučen na sintetičkom skupu podataka TinyStories, koji se sastoji od jednostavnih priča na engleskom jeziku s ograničenim vokabularom. Stoga može nastavljati rečenice i sastavljati kratke, koherentne priče, ali nije dizajniran da odgovara na pitanja, slijedi upute, programira ili reproducira činjenično znanje. Programer rad prvenstveno vidi kao demonstraciju efikasnog smještaja modela u memoriju mikrokontrolera, a ne kao gotovog, autonomnog chatbota.
U trenutnoj dokumentaciji, autor posebno naglašava da je esp32-ai nezavisni razvoj. Projekti llama2.c Rad Andreja Karpathyja i ranije lansiranje 260-og modela na ESP32-S3 dati su samo kao smjernice i primjeri prethodnog rada: kod, kontrolne tačke i metodologija nisu direktno posuđeni od njih. Izvorni kod esp32-ai distribuira se pod MIT licencom.
izvor: linux.org.ru
